

Python za analizu podataka: strojno učenje sa Scikit-Learnom
Piše Yasin TANIŞ
Uvod
Strojno učenje grana je znanosti koja računalima omogućuje da uče iz podataka i donose predviđanja, a danas se primjenjuje u mnogim djelatnostima. U ovom članku razmatramo Scikit-Learn, jednu od najčešće korištenih Python biblioteka za izradu aplikacija strojnog učenja.
Što je Scikit-Learn
Scikit-Learn je biblioteka za strojno učenje koja nudi jednostavne i učinkovite alate za Python. Sadrži algoritme i za nadzirano i za nenadzirano učenje.
Instalacija
Prije početka biblioteku treba instalirati. Ako je još nemate na sustavu, instalirajte je ovom naredbom:
pip install scikit-learnNapomena: primjeri su ovdje namjerno jednostavni kako bi ilustrirali pojmove; nisu uvijek najbolja metrika ili metoda za svaki scenarij.
Nadzirano učenje
Nadzirano učenje radi s označenim podacima: ishodi (oznake) primjera poznati su, pa ih model može naučiti predviđati.
Logistička regresija
Logistička regresija široko je korišten algoritam za probleme klasifikacije.
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import accuracy_score
# Veri setini yükle
iris = load_iris()
X = iris.data
y = iris.target
# Veriyi eğitim ve test olarak ayır
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
# Model oluştur ve eğit
model = LogisticRegression(max_iter=200)
model.fit(X_train, y_train)
# Tahmin yap ve doğruluğu ölç
y_pred = model.predict(X_test)
accuracy = accuracy_score(y_test, y_pred)
print(f'Model accuracy: {accuracy}')
Model Accuracy : 1.0Ovaj kod učitava skup podataka Iris, dijeli ga na značajke i ciljnu varijablu, trenira model i ispisuje njegovu točnost.
Stabla odlučivanja
Stabla odlučivanja moćan su algoritam i za klasifikaciju i za regresiju.
from sklearn.tree import DecisionTreeClassifier

# Model oluştur ve eğit
tree_model = DecisionTreeClassifier(random_state=42)
tree_model.fit(X_train, y_train)

# Tahmin yap ve doğruluğu ölç
y_pred_tree = tree_model.predict(X_test)
accuracy_tree = accuracy_score(y_test, y_pred_tree)

print(f'Decision Tree Model accuracy: {accuracy_tree}')
Decision Tree Model Accuracy: 1.0Nenadzirano učenje
Nenadzirano učenje ne koristi označene podatke; model sam pokušava naučiti strukturu podataka.
Klasteriranje algoritmom K-Means
K-Means je čest algoritam klasteriranja koji dijeli podatke u k klastera.
from sklearn.cluster import KMeans
import matplotlib.pyplot as plt

# Örnek veri seti oluştur
from sklearn.datasets import make_blobs
X, _ = make_blobs(n_samples=300, centers=4, random_state=42)

# Model oluştur ve eğit
kmeans = KMeans(n_clusters=4, random_state=42)
kmeans.fit(X)

# Tahmin yap ve kümeleri görselleştir
y_kmeans = kmeans.predict(X)

plt.scatter(X[:, 0], X[:, 1], c=y_kmeans, s=50, cmap='viridis')
centers = kmeans.cluster_centers_
plt.scatter(centers[:, 0], centers[:, 1], c='red', s=200, alpha=0.75)
plt.title('K-Means Clustering')
plt.show()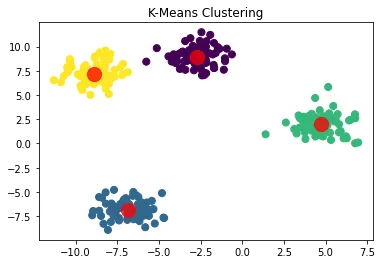
Analiza glavnih komponenti (PCA)
PCA je tehnika za svođenje višedimenzionalnih podataka na manji broj dimenzija.
from sklearn.decomposition import PCA

# Model oluştur ve eğit
pca = PCA(n_components=2)
X_pca = pca.fit_transform(X)

plt.scatter(X_pca[:, 0], X_pca[:, 1], c=y_kmeans, s=50, cmap='viridis')
plt.title('PCA Visualization')
plt.show()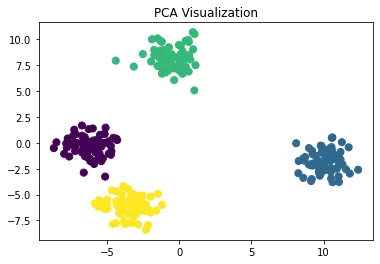
Ugađanje hiperparametara
Ugađanje hiperparametara važan je korak u postizanju najboljih performansi modela. Klasa GridSearchCV iz Scikit-Learna to olakšava.
from sklearn.model_selection import GridSearchCV
from sklearn.svm import SVC

# Parametre uzayını tanımla
param_grid = {'C': [0.1, 1, 10], 'kernel': ['rbf', 'linear']}

# Grid search nesnesi oluştur
grid_search = GridSearchCV(SVC(), param_grid, cv=5)

# Grid search'ü uygula
grid_search.fit(X_train, y_train)

print("En iyi parametreler:", grid_search.best_params_)
print("En iyi skor:", grid_search.best_score_)
En iyi parametreler: {'C': 1, 'kernel': 'linear'}
En iyi skor: 0.9583333333333334(Oznake u izlazu na turskom su jer ih izvorni kod tako ispisuje: „najbolji parametri“ i „najbolji rezultat“.)
Unakrsna validacija
Unakrsna validacija važna je tehnika za mjerenje koliko dobro model generalizira na nove podatke.
import numpy as np

# Örnek sayısını en küçük olan veri setine eşitleyin
min_samples = min(X.shape[0], y.shape[0])

# Rastgele örnekleme yapın
np.random.seed(42)  # Tekrarlanabilirlik için
indices = np.random.choice(X.shape[0], min_samples, replace=False)
X = X[indices]
y = y[:min_samples]  # y zaten daha küçük

print("New X shape:", X.shape)
print("New y shape:", y.shape)
New X shape: (150, 2)
New y shape: (150,)from sklearn.model_selection import cross_val_score
from sklearn.linear_model import LogisticRegression
# Lojistik regresyon modelini oluştur
log_reg = LogisticRegression()
# 5-fold cross-validation uygula
scores = cross_val_score(log_reg, X, y, cv=5)
print("Cross-validation skorları:", scores)
print("Ortalama skor:", scores.mean())Cross-validation skorları: [0.33333333 0.4 0.26666667 0.36666667 0.3 ]
Ortalama skor: 0.33333333333333337Napomena o ispravku: niski rezultati ovdje posljedica su prethodnog koraka, a ne modela. Kod za ponovno uzorkovanje nasumično miješa retke u X, ali oznake u y ne miješa na isti način, pa oznake više ne odgovaraju recima i model pada na razinu slučajnog pogađanja (oko 0,33 uz tri klase). Ako preskočite taj korak ili X i y odaberete s istim indeksima, rezultati se ponovno povećavaju. Metrike i rezultati cjevovoda u nastavku niski su iz istog razloga jer koriste iste podatke.
Odabir i inženjering značajki
Odabir i inženjering značajki imaju ključnu ulogu u performansama modela. Scikit-Learn nudi alate koji olakšavaju te korake.
from sklearn.feature_selection import SelectKBest, f_classif

# En iyi 2 özelliği seç
selector = SelectKBest(f_classif, k=2)
X_new = selector.fit_transform(X, y)

print("Seçilen özellikler:", selector.get_support())
Seçilen özellikler: [ True True]Tumačenje modela
Osobito kod modela kao što su stabla odlučivanja važno je razumjeti kako model donosi odluke.
from sklearn.tree import plot_tree
import matplotlib.pyplot as plt

# Karar ağacını görselleştir
plt.figure(figsize=(20,10))
plot_tree(tree_model, feature_names=iris.feature_names, class_names=iris.target_names, filled=True)
plt.show()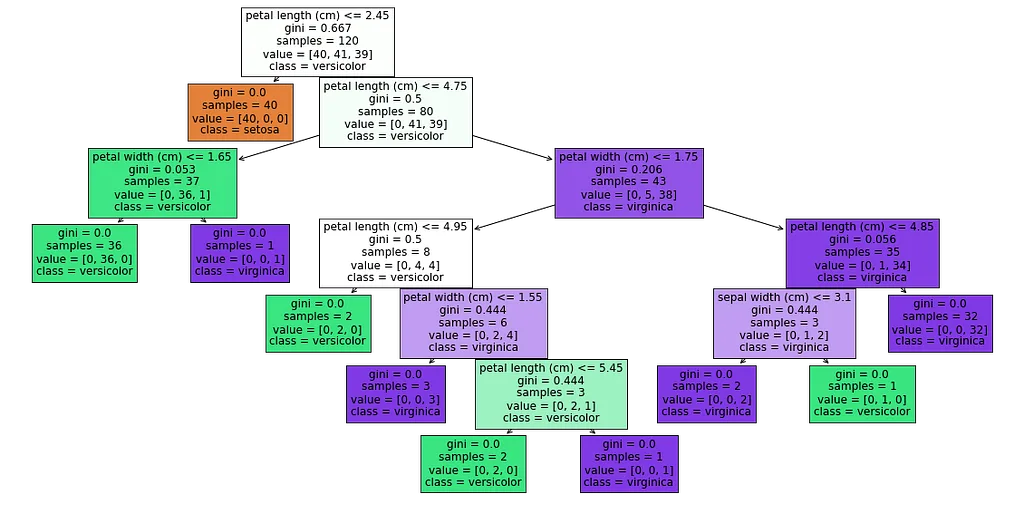
Grafikon prikazuje stablo odlučivanja klasifikatora treniranog na skupu podataka Iris. Stablo pomoću nekoliko pravila razdvaja klase setosa, versicolor i virginica:
- Korijenski čvor: uvjet petal length ≤ 2,45 cm; Gini 0,667; 120 primjera, raspodjela [40, 41, 39]. Ovdje su klase najviše izmiješane.
- Lijevi podređeni čvor: Gini 0,0; svih 40 primjera pripada klasi setosa. Jedno pravilo potpuno izdvaja setosu.
- Desni podređeni čvor (petal length > 2,45 cm): Gini 0,5; 80 primjera, raspodjela [0, 41, 39]. Versicolor i virginica i dalje su izmiješane.
- Finija podjela: uvjet petal length ≤ 4,75 cm; Gini 0,206; 43 primjera, raspodjela [0, 5, 38], većinom virginica.
- Niži čvorovi: uvjet petal width ≤ 1,75 cm; Gini 0,0; svih 35 primjera pripada klasi virginica.
Svaki čvor prikazuje Ginijev koeficijent, broj primjera i raspodjelu klasa, pa možete točno pratiti koju značajku model koristi u kojem trenutku i kako odlučuje.
Ansambl metode
Ansambl metode kombiniraju više modela kako bi dale snažnija predviđanja. Random Forest jedna je od najpopularnijih.
from sklearn.ensemble import RandomForestClassifier

# Random Forest modeli oluştur ve eğit
rf_model = RandomForestClassifier(n_estimators=100, random_state=42)
rf_model.fit(X_train, y_train)

# Tahmin yap ve doğruluğu ölç
y_pred_rf = rf_model.predict(X_test)
accuracy_rf = accuracy_score(y_test, y_pred_rf)

print(f'Random Forest Model accuracy: {accuracy_rf}')
Random Forest Model accuracy: 1.0Metrike vrednovanja
Osim točnosti, važne su i druge metrike vrednovanja.
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import classification_report, confusion_matrix

# Veri setini ayır
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)

# Modeli eğit
log_reg = LogisticRegression()
log_reg.fit(X_train, y_train)

# Tahminler yap
y_pred_log = log_reg.predict(X_test)

# Sınıflandırma raporu oluştur
print(classification_report(y_test, y_pred_log, target_names=iris.target_names))

# Confusion matrix oluştur
cm = confusion_matrix(y_test, y_pred_log)
print("Confusion Matrix:\n", cm)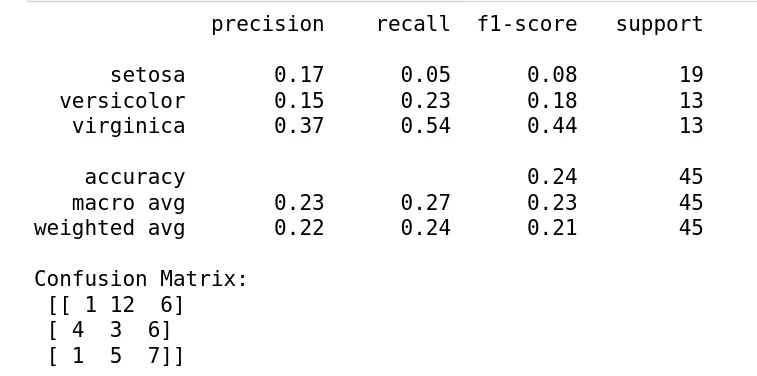
Ovi rezultati pokazuju performanse modela treniranog na gore izmiješanim podacima:
- Preciznost, udio točnih među pozitivnim predviđanjima: setosa 17 %, versicolor 15 %, virginica 37 %.
- Odziv, udio pronađenih stvarno pozitivnih primjera: setosa 5 %, versicolor 23 %, virginica 54 %.
- F1-mjera, harmonijska sredina preciznosti i odziva: setosa 0,08, versicolor 0,18, virginica 0,44.
- Ukupna točnost: 24 %.
- Makro prosjek: preciznost 23 %, odziv 27 %, F1 23 %. Ponderirani prosjek: preciznost 22 %, odziv 24 %, F1 21 %.
U matrici zabune 1 primjer klase setosa predviđen je točno, 12 kao versicolor i 6 kao virginica; kod klase versicolor 3 su točna, 4 kao setosa i 6 kao virginica; kod klase virginica 7 je točno, 1 kao setosa i 5 kao versicolor.
Tumačenje i prijedlozi
Ukupne performanse su niske; najbolje prolazi virginica, ali ni ona nije dovoljno dobra. Kao što objašnjava gornja napomena o ispravku, glavni su uzrok izmiješane oznake. Osim toga, performanse općenito poboljšavaju ovi koraci:
- Isprobati jače modele kao što su Random Forest ili SVM i ugoditi njihove hiperparametre
- Dodati nove značajke ili transformirati postojeće
- Uravnotežiti klase metodama kao što je SMOTE ako su neuravnotežene
- Koristiti unakrsnu validaciju kako bi se uočila prenaučenost ili podnaučenost
Primjena u praksi: segmentacija kupaca
Kao primjenu u praksi uzmimo segmentaciju kupaca jedne tvrtke za e-trgovinu.
from sklearn.preprocessing import StandardScaler
from sklearn.cluster import KMeans

# Örnek veri oluştur (gerçek senaryoda bu veri müşteri veritabanından gelir)
customer_data = np.random.rand(1000, 3)  # 1000 müşteri, 3 özellik (örn: yaş, toplam harcama, ziyaret sıklığı)

# Veriyi ölçeklendir
scaler = StandardScaler()
customer_data_scaled = scaler.fit_transform(customer_data)

# K-Means uygula
kmeans = KMeans(n_clusters=4, random_state=42)
clusters = kmeans.fit_predict(customer_data_scaled)

print("Müşteri segmentleri:", np.unique(clusters))
Müşteri segmentleri: [0 1 2 3]Cjevovodi (pipeline) u Scikit-Learnu
Cjevovod (pipeline) povezuje korake predobrade i treniranja modela, pa je kod čišći i učinkovitiji.
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler

# Pipeline oluştur
pipeline = Pipeline([
    ('scaler', StandardScaler()),
    ('classifier', LogisticRegression())
])

# Pipeline'ı eğit ve değerlendir
pipeline.fit(X_train, y_train)
accuracy_pipeline = pipeline.score(X_test, y_test)

print(f'Pipeline Model accuracy: {accuracy_pipeline}')
Pipeline Model accuracy: 0.24444444444444444Studija slučaja: klasifikacija na skupu Iris
U ovoj studiji slučaja primjenjujemo nekoliko algoritama strojnog učenja na skup podataka Iris i uspoređujemo rezultate.
Priprema podataka
Najprije učitavamo skup podataka i dijelimo ga na skup za učenje i skup za testiranje.
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split

# Veri setini yükle
iris = load_iris()
X = iris.data
y = iris.target

# Veriyi eğitim ve test olarak ayır
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
Primjena i usporedba algoritama
Sada primjenjujemo logističku regresiju, stablo odlučivanja i KNN te uspoređujemo njihove rezultate.
from sklearn.linear_model import LogisticRegression
from sklearn.tree import DecisionTreeClassifier
from sklearn.neighbors import KNeighborsClassifier
from sklearn.metrics import accuracy_score

# Lojistik Regresyon
log_reg = LogisticRegression(max_iter=200)
log_reg.fit(X_train, y_train)
y_pred_log = log_reg.predict(X_test)
accuracy_log = accuracy_score(y_test, y_pred_log)

# Karar Ağaçları
tree_model = DecisionTreeClassifier(random_state=42)
tree_model.fit(X_train, y_train)
y_pred_tree = tree_model.predict(X_test)
accuracy_tree = accuracy_score(y_test, y_pred_tree)

# KNN
knn = KNeighborsClassifier(n_neighbors=3)
knn.fit(X_train, y_train)
y_pred_knn = knn.predict(X_test)
accuracy_knn = accuracy_score(y_test, y_pred_knn)

print(f'Logistic Regression accuracy: {accuracy_log}')
print(f'Decision Tree accuracy: {accuracy_tree}')
print(f'KNN accuracy: {accuracy_knn}')
Logistic Regression accuracy: 1.0
Decision Tree accuracy: 1.0
KNN accuracy: 1.0Zaključak
U ovom članku prošli smo kroz faze procesa strojnog učenja sa Scikit-Learnom i vidjeli kako se primjenjuju. Nadzirane i nenadzirane algoritme primijenili smo na skup podataka Iris, a osim osnovnih algoritama obradili smo optimizaciju, vrednovanje i tumačenje, primjenu u praksi i cjevovode. Zahvaljujući širokom skupu alata, Scikit-Learn podatkovnim znanstvenicima i praktičarima strojnog učenja olakšava rješavanje složenih problema.
Izvori
- Pedregosa, F. i sur. (2011). Scikit-learn: Machine Learning in Python. Journal of Machine Learning Research, 12, 2825–2830.
- Dokumentacija Scikit-Learna: scikit-learn.org
- Hastie, T., Tibshirani, R. i Friedman, J. (2009). The Elements of Statistical Learning. Springer.
- Kuhn, M. i Johnson, K. (2013). Applied Predictive Modeling. Springer.
- Géron, A. (2019). Hands-On Machine Learning with Scikit-Learn, Keras, and TensorFlow. O’Reilly Media.
- Müller, A. C. i Guido, S. (2016). Introduction to Machine Learning with Python. O’Reilly Media.
- Raschka, S. i Mirjalili, V. (2019). Python Machine Learning. Packt Publishing.
- VanderPlas, J. (2016). Python Data Science Handbook. O’Reilly Media.