

Python für die Datenanalyse: Maschinelles Lernen mit Scikit-Learn
Von Yasin TANIŞ
Einführung
Maschinelles Lernen ist das Fachgebiet, das Computern ermöglicht, aus Daten zu lernen und Vorhersagen zu treffen; es wird heute in vielen Branchen eingesetzt. In diesem Beitrag betrachten wir Scikit-Learn, eine der meistgenutzten Python-Bibliotheken für Anwendungen des maschinellen Lernens.
Was ist Scikit-Learn?
Scikit-Learn ist eine Bibliothek für maschinelles Lernen mit einfachen, effizienten Werkzeugen für Python. Sie enthält Algorithmen für überwachtes und unüberwachtes Lernen.
Installation
Bevor wir beginnen, muss die Bibliothek installiert werden. Falls sie auf Ihrem System noch nicht installiert ist, installieren Sie sie mit diesem Befehl:
pip install scikit-learnHinweis: Die Beispiele sind bewusst einfach gehalten, um die Konzepte zu veranschaulichen; sie stellen nicht in jedem Szenario die beste Metrik oder Methode dar.
Überwachtes Lernen
Überwachtes Lernen arbeitet mit gelabelten Daten: Die Ergebnisse (Labels) der Beispiele sind bekannt, sodass das Modell lernen kann, sie vorherzusagen.
Logistische Regression
Die logistische Regression ist ein verbreiteter Algorithmus für Klassifikationsprobleme.
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import accuracy_score
# Veri setini yükle
iris = load_iris()
X = iris.data
y = iris.target
# Veriyi eğitim ve test olarak ayır
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
# Model oluştur ve eğit
model = LogisticRegression(max_iter=200)
model.fit(X_train, y_train)
# Tahmin yap ve doğruluğu ölç
y_pred = model.predict(X_test)
accuracy = accuracy_score(y_test, y_pred)
print(f'Model accuracy: {accuracy}')
Model Accuracy : 1.0Dieser Code lädt den Iris-Datensatz, teilt ihn in Merkmale und Zielvariable auf, trainiert das Modell und gibt seine Genauigkeit aus.
Entscheidungsbäume
Entscheidungsbäume sind ein leistungsfähiger Algorithmus für Klassifikation und Regression.
from sklearn.tree import DecisionTreeClassifier

# Model oluştur ve eğit
tree_model = DecisionTreeClassifier(random_state=42)
tree_model.fit(X_train, y_train)

# Tahmin yap ve doğruluğu ölç
y_pred_tree = tree_model.predict(X_test)
accuracy_tree = accuracy_score(y_test, y_pred_tree)

print(f'Decision Tree Model accuracy: {accuracy_tree}')
Decision Tree Model Accuracy: 1.0Unüberwachtes Lernen
Unüberwachtes Lernen nutzt keine gelabelten Daten; das Modell versucht selbst, die Struktur der Daten zu erkennen.
K-Means-Clustering
K-Means ist ein gängiger Clustering-Algorithmus, der Daten in k Cluster aufteilt.
from sklearn.cluster import KMeans
import matplotlib.pyplot as plt

# Örnek veri seti oluştur
from sklearn.datasets import make_blobs
X, _ = make_blobs(n_samples=300, centers=4, random_state=42)

# Model oluştur ve eğit
kmeans = KMeans(n_clusters=4, random_state=42)
kmeans.fit(X)

# Tahmin yap ve kümeleri görselleştir
y_kmeans = kmeans.predict(X)

plt.scatter(X[:, 0], X[:, 1], c=y_kmeans, s=50, cmap='viridis')
centers = kmeans.cluster_centers_
plt.scatter(centers[:, 0], centers[:, 1], c='red', s=200, alpha=0.75)
plt.title('K-Means Clustering')
plt.show()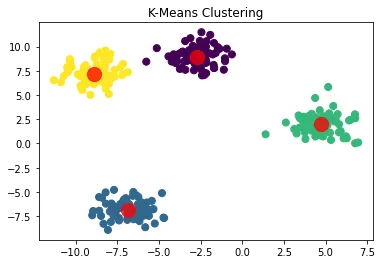
Hauptkomponentenanalyse (PCA)
PCA ist eine Technik, um hochdimensionale Daten auf weniger Dimensionen zu reduzieren.
from sklearn.decomposition import PCA

# Model oluştur ve eğit
pca = PCA(n_components=2)
X_pca = pca.fit_transform(X)

plt.scatter(X_pca[:, 0], X_pca[:, 1], c=y_kmeans, s=50, cmap='viridis')
plt.title('PCA Visualization')
plt.show()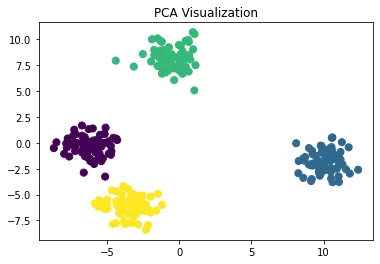
Hyperparameter-Tuning
Hyperparameter-Tuning ist ein wichtiger Schritt, um die bestmögliche Leistung aus einem Modell herauszuholen. Die Scikit-Learn-Klasse GridSearchCV macht ihn einfach.
from sklearn.model_selection import GridSearchCV
from sklearn.svm import SVC

# Parametre uzayını tanımla
param_grid = {'C': [0.1, 1, 10], 'kernel': ['rbf', 'linear']}

# Grid search nesnesi oluştur
grid_search = GridSearchCV(SVC(), param_grid, cv=5)

# Grid search'ü uygula
grid_search.fit(X_train, y_train)

print("En iyi parametreler:", grid_search.best_params_)
print("En iyi skor:", grid_search.best_score_)
En iyi parametreler: {'C': 1, 'kernel': 'linear'}
En iyi skor: 0.9583333333333334(Die Beschriftungen der Ausgabe sind türkisch, weil der Originalcode sie so ausgibt: „beste Parameter“ und „bester Score“.)
Kreuzvalidierung
Kreuzvalidierung ist eine wichtige Technik, um zu messen, wie gut ein Modell auf neue Daten generalisiert.
import numpy as np

# Örnek sayısını en küçük olan veri setine eşitleyin
min_samples = min(X.shape[0], y.shape[0])

# Rastgele örnekleme yapın
np.random.seed(42)  # Tekrarlanabilirlik için
indices = np.random.choice(X.shape[0], min_samples, replace=False)
X = X[indices]
y = y[:min_samples]  # y zaten daha küçük

print("New X shape:", X.shape)
print("New y shape:", y.shape)
New X shape: (150, 2)
New y shape: (150,)from sklearn.model_selection import cross_val_score
from sklearn.linear_model import LogisticRegression
# Lojistik regresyon modelini oluştur
log_reg = LogisticRegression()
# 5-fold cross-validation uygula
scores = cross_val_score(log_reg, X, y, cv=5)
print("Cross-validation skorları:", scores)
print("Ortalama skor:", scores.mean())Cross-validation skorları: [0.33333333 0.4 0.26666667 0.36666667 0.3 ]
Ortalama skor: 0.33333333333333337Korrekturhinweis: Die niedrigen Werte hier stammen aus dem vorherigen Schritt, nicht vom Modell. Der Resampling-Code mischt die Zeilen von X zufällig, die Labels in y aber nicht auf dieselbe Weise; dadurch passen die Labels nicht mehr zu den Zeilen, und das Modell fällt auf Zufallsniveau (etwa 0,33 bei drei Klassen). Lässt man diesen Schritt weg oder wählt X und y mit denselben Indizes aus, steigen die Werte wieder. Die Metriken und Pipeline-Ergebnisse weiter unten sind aus demselben Grund niedrig, da sie dieselben Daten verwenden.
Merkmalsauswahl und Feature Engineering
Merkmalsauswahl und Feature Engineering spielen eine entscheidende Rolle für die Modellleistung. Scikit-Learn bietet Werkzeuge, die diese Schritte erleichtern.
from sklearn.feature_selection import SelectKBest, f_classif

# En iyi 2 özelliği seç
selector = SelectKBest(f_classif, k=2)
X_new = selector.fit_transform(X, y)

print("Seçilen özellikler:", selector.get_support())
Seçilen özellikler: [ True True]Interpretierbarkeit des Modells
Besonders bei Modellen wie Entscheidungsbäumen ist es wichtig zu verstehen, wie das Modell zu seinen Entscheidungen kommt.
from sklearn.tree import plot_tree
import matplotlib.pyplot as plt

# Karar ağacını görselleştir
plt.figure(figsize=(20,10))
plot_tree(tree_model, feature_names=iris.feature_names, class_names=iris.target_names, filled=True)
plt.show()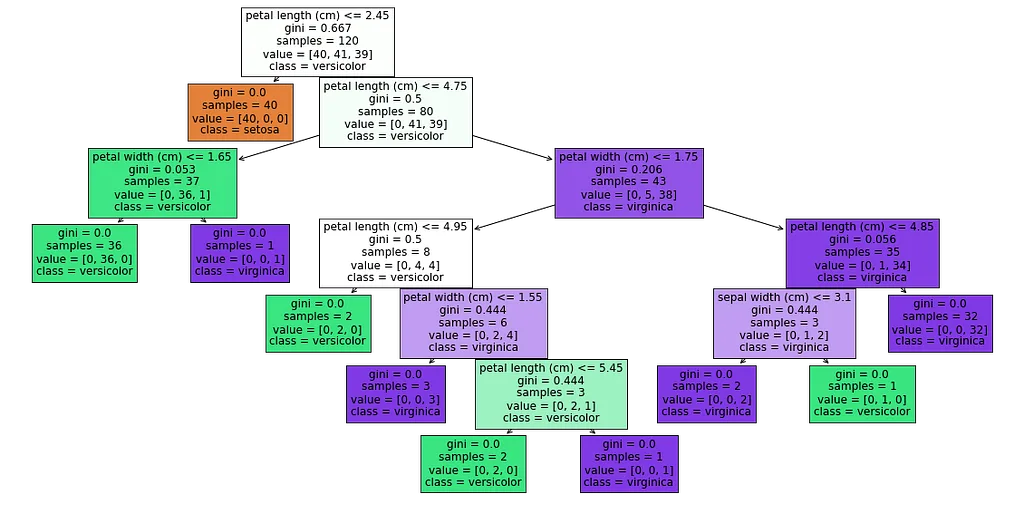
Das Diagramm zeigt den Entscheidungsbaum eines auf dem Iris-Datensatz trainierten Klassifikators. Mit wenigen Regeln trennt er die Klassen setosa, versicolor und virginica:
- Wurzelknoten: Bedingung petal length ≤ 2,45 cm; Gini 0,667; 120 Beispiele, Verteilung [40, 41, 39]. Hier sind die Klassen am stärksten gemischt.
- Linker Kindknoten: Gini 0,0; alle 40 Beispiele sind setosa. Eine einzige Regel trennt setosa vollständig ab.
- Rechter Kindknoten (petal length > 2,45 cm): Gini 0,5; 80 Beispiele, Verteilung [0, 41, 39]. Versicolor und virginica sind noch gemischt.
- Feinere Trennung: Bedingung petal length ≤ 4,75 cm; Gini 0,206; 43 Beispiele, Verteilung [0, 5, 38], überwiegend virginica.
- Untere Knoten: Bedingung petal width ≤ 1,75 cm; Gini 0,0; alle 35 Beispiele sind virginica.
Jeder Knoten zeigt den Gini-Koeffizienten, die Anzahl der Beispiele und die Klassenverteilung, sodass sich genau verfolgen lässt, welches Merkmal das Modell an welcher Stelle nutzt und wie es entscheidet.
Ensemble-Methoden
Ensemble-Methoden kombinieren mehrere Modelle, um stärkere Vorhersagen zu treffen. Random Forest gehört zu den beliebtesten.
from sklearn.ensemble import RandomForestClassifier

# Random Forest modeli oluştur ve eğit
rf_model = RandomForestClassifier(n_estimators=100, random_state=42)
rf_model.fit(X_train, y_train)

# Tahmin yap ve doğruluğu ölç
y_pred_rf = rf_model.predict(X_test)
accuracy_rf = accuracy_score(y_test, y_pred_rf)

print(f'Random Forest Model accuracy: {accuracy_rf}')
Random Forest Model accuracy: 1.0Bewertungsmetriken
Neben der Genauigkeit sind auch andere Bewertungsmetriken wichtig.
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import classification_report, confusion_matrix

# Veri setini ayır
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)

# Modeli eğit
log_reg = LogisticRegression()
log_reg.fit(X_train, y_train)

# Tahminler yap
y_pred_log = log_reg.predict(X_test)

# Sınıflandırma raporu oluştur
print(classification_report(y_test, y_pred_log, target_names=iris.target_names))

# Confusion matrix oluştur
cm = confusion_matrix(y_test, y_pred_log)
print("Confusion Matrix:\n", cm)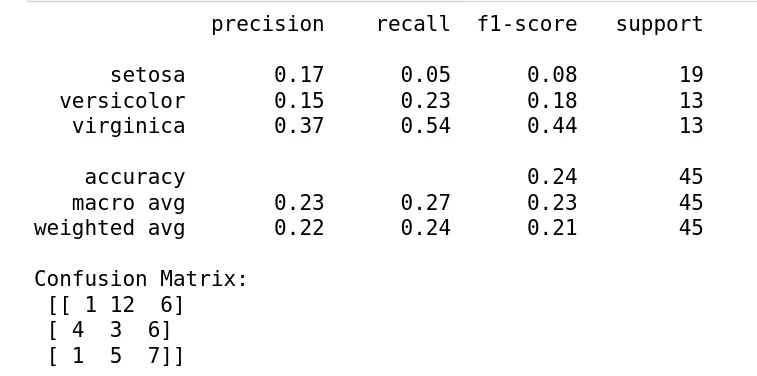
Diese Ergebnisse zeigen die Leistung eines Modells, das auf den weiter oben gemischten Daten trainiert wurde:
- Präzision, der Anteil korrekter positiver Vorhersagen: setosa 17 %, versicolor 15 %, virginica 37 %.
- Recall, der Anteil der tatsächlich positiven Fälle, die erkannt werden: setosa 5 %, versicolor 23 %, virginica 54 %.
- F1-Score, das harmonische Mittel aus Präzision und Recall: setosa 0,08, versicolor 0,18, virginica 0,44.
- Gesamtgenauigkeit: 24 %.
- Makro-Mittel: Präzision 23 %, Recall 27 %, F1 23 %. Gewichtetes Mittel: Präzision 22 %, Recall 24 %, F1 21 %.
In der Konfusionsmatrix wird von den setosa-Beispielen 1 richtig vorhergesagt, 12 als versicolor und 6 als virginica; bei versicolor sind es 3 richtige, 4 als setosa und 6 als virginica, bei virginica 7 richtige, 1 als setosa und 5 als versicolor.
Interpretation und Empfehlungen
Die Gesamtleistung ist niedrig; virginica schneidet am besten ab, aber noch nicht gut genug. Wie der Korrekturhinweis oben erklärt, liegt die Hauptursache in den durcheinandergeratenen Labels. Darüber hinaus verbessern diese Schritte die Leistung im Allgemeinen:
- Stärkere Modelle wie Random Forest oder SVM ausprobieren und die Hyperparameter abstimmen
- Neue Merkmale hinzufügen oder vorhandene transformieren
- Klassen mit Verfahren wie SMOTE ausgleichen, falls sie unausgewogen sind
- Mit Kreuzvalidierung Über- oder Unteranpassung erkennen
Eine Praxisanwendung: Kundensegmentierung
Als Praxisanwendung betrachten wir die Kundensegmentierung für ein E-Commerce-Unternehmen.
from sklearn.preprocessing import StandardScaler
from sklearn.cluster import KMeans

# Örnek veri oluştur (gerçek senaryoda bu veri müşteri veritabanından gelir)
customer_data = np.random.rand(1000, 3)  # 1000 müşteri, 3 özellik (örn: yaş, toplam harcama, ziyaret sıklığı)

# Veriyi ölçeklendir
scaler = StandardScaler()
customer_data_scaled = scaler.fit_transform(customer_data)

# K-Means uygula
kmeans = KMeans(n_clusters=4, random_state=42)
clusters = kmeans.fit_predict(customer_data_scaled)

print("Müşteri segmentleri:", np.unique(clusters))
Müşteri segmentleri: [0 1 2 3]Pipelines in Scikit-Learn
Eine Pipeline verkettet die Schritte der Vorverarbeitung und des Modelltrainings und macht den Code sauberer und effizienter.
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler

# Pipeline oluştur
pipeline = Pipeline([
    ('scaler', StandardScaler()),
    ('classifier', LogisticRegression())
])

# Pipeline'ı eğit ve değerlendir
pipeline.fit(X_train, y_train)
accuracy_pipeline = pipeline.score(X_test, y_test)

print(f'Pipeline Model accuracy: {accuracy_pipeline}')
Pipeline Model accuracy: 0.24444444444444444Fallstudie: Klassifikation mit dem Iris-Datensatz
In dieser Fallstudie wenden wir mehrere Algorithmen des maschinellen Lernens auf den Iris-Datensatz an und vergleichen die Ergebnisse.
Daten vorbereiten
Zuerst laden wir den Datensatz und teilen ihn in Trainings- und Testdaten.
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split

# Veri setini yükle
iris = load_iris()
X = iris.data
y = iris.target

# Veriyi eğitim ve test olarak ayır
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
Algorithmen anwenden und vergleichen
Nun wenden wir logistische Regression, einen Entscheidungsbaum und KNN an und vergleichen die Ergebnisse.
from sklearn.linear_model import LogisticRegression
from sklearn.tree import DecisionTreeClassifier
from sklearn.neighbors import KNeighborsClassifier
from sklearn.metrics import accuracy_score

# Lojistik Regresyon
log_reg = LogisticRegression(max_iter=200)
log_reg.fit(X_train, y_train)
y_pred_log = log_reg.predict(X_test)
accuracy_log = accuracy_score(y_test, y_pred_log)

# Karar Ağaçları
tree_model = DecisionTreeClassifier(random_state=42)
tree_model.fit(X_train, y_train)
y_pred_tree = tree_model.predict(X_test)
accuracy_tree = accuracy_score(y_test, y_pred_tree)

# KNN
knn = KNeighborsClassifier(n_neighbors=3)
knn.fit(X_train, y_train)
y_pred_knn = knn.predict(X_test)
accuracy_knn = accuracy_score(y_test, y_pred_knn)

print(f'Logistic Regression accuracy: {accuracy_log}')
print(f'Decision Tree accuracy: {accuracy_tree}')
print(f'KNN accuracy: {accuracy_knn}')
Logistic Regression accuracy: 1.0
Decision Tree accuracy: 1.0
KNN accuracy: 1.0Fazit
In diesem Beitrag haben wir die Phasen eines Machine-Learning-Workflows mit Scikit-Learn durchlaufen und gesehen, wie man sie anwendet. Wir haben überwachte und unüberwachte Algorithmen auf den Iris-Datensatz angewandt und neben den grundlegenden Algorithmen Optimierung, Bewertung und Interpretation, eine Praxisanwendung und Pipelines behandelt. Mit seinem breiten Werkzeugkasten erleichtert Scikit-Learn Data Scientists und Machine-Learning-Fachleuten das Lösen komplexer Probleme.
Quellen
- Pedregosa, F. et al. (2011). Scikit-learn: Machine Learning in Python. Journal of Machine Learning Research, 12, 2825–2830.
- Scikit-Learn-Dokumentation: scikit-learn.org
- Hastie, T., Tibshirani, R. und Friedman, J. (2009). The Elements of Statistical Learning. Springer.
- Kuhn, M. und Johnson, K. (2013). Applied Predictive Modeling. Springer.
- Géron, A. (2019). Hands-On Machine Learning with Scikit-Learn, Keras, and TensorFlow. O’Reilly Media.
- Müller, A. C. und Guido, S. (2016). Introduction to Machine Learning with Python. O’Reilly Media.
- Raschka, S. und Mirjalili, V. (2019). Python Machine Learning. Packt Publishing.
- VanderPlas, J. (2016). Python Data Science Handbook. O’Reilly Media.