

Python za analizo podatkov: strojno učenje s Scikit-Learn
Avtor Yasin TANIŞ
Uvod
Strojno učenje je znanstveno področje, ki računalnikom omogoča, da se učijo iz podatkov in napovedujejo, danes pa se uporablja v številnih panogah. V tem članku bomo spoznali Scikit-Learn, eno najbolj uporabljanih knjižnic za Python za izdelavo aplikacij strojnega učenja.
Kaj je Scikit-Learn
Scikit-Learn je knjižnica za strojno učenje s preprostimi in učinkovitimi orodji za Python. Vsebuje algoritme za nadzorovano in nenadzorovano učenje.
Namestitev
Pred začetkom moramo knjižnico namestiti. Če je v sistemu še nimate, jo namestite s tem ukazom:
pip install scikit-learnOpomba: primeri so namenoma preprosti, da ponazorijo pojme; ne predstavljajo vedno najboljše metrike ali metode za vsak scenarij.
Nadzorovano učenje
Nadzorovano učenje dela z označenimi podatki: izidi (oznake) primerov so znani, zato se jih model lahko nauči napovedovati.
Logistična regresija
Logistična regresija je pogosto uporabljen algoritem za klasifikacijske probleme.
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import accuracy_score
# Veri setini yükle
iris = load_iris()
X = iris.data
y = iris.target
# Veriyi eğitim ve test olarak ayır
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
# Model oluştur ve eğit
model = LogisticRegression(max_iter=200)
model.fit(X_train, y_train)
# Tahmin yap ve doğruluğu ölç
y_pred = model.predict(X_test)
accuracy = accuracy_score(y_test, y_pred)
print(f'Model accuracy: {accuracy}')
Model Accuracy : 1.0Ta koda naloži podatkovno zbirko Iris, jo razdeli na značilke in cilj, nauči model in izpiše njegovo točnost.
Odločitvena drevesa
Odločitvena drevesa so zmogljiv algoritem za klasifikacijo in regresijo.
from sklearn.tree import DecisionTreeClassifier

# Model oluştur ve eğit
tree_model = DecisionTreeClassifier(random_state=42)
tree_model.fit(X_train, y_train)

# Tahmin yap ve doğruluğu ölç
y_pred_tree = tree_model.predict(X_test)
accuracy_tree = accuracy_score(y_test, y_pred_tree)

print(f'Decision Tree Model accuracy: {accuracy_tree}')
Decision Tree Model Accuracy: 1.0Nenadzorovano učenje
Nenadzorovano učenje ne uporablja označenih podatkov; model se sam poskuša naučiti strukture podatkov.
Gručenje K-Means
K-Means je pogost algoritem gručenja, ki podatke razdeli v k gruč.
from sklearn.cluster import KMeans
import matplotlib.pyplot as plt

# Örnek veri seti oluştur
from sklearn.datasets import make_blobs
X, _ = make_blobs(n_samples=300, centers=4, random_state=42)

# Model oluştur ve eğit
kmeans = KMeans(n_clusters=4, random_state=42)
kmeans.fit(X)

# Tahmin yap ve kümeleri görselleştir
y_kmeans = kmeans.predict(X)

plt.scatter(X[:, 0], X[:, 1], c=y_kmeans, s=50, cmap='viridis')
centers = kmeans.cluster_centers_
plt.scatter(centers[:, 0], centers[:, 1], c='red', s=200, alpha=0.75)
plt.title('K-Means Clustering')
plt.show()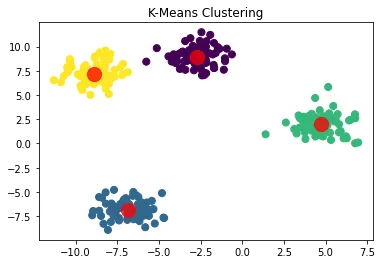
Analiza glavnih komponent (PCA)
PCA je tehnika, s katero večdimenzionalne podatke zmanjšamo na manj dimenzij.
from sklearn.decomposition import PCA

# Model oluştur ve eğit
pca = PCA(n_components=2)
X_pca = pca.fit_transform(X)

plt.scatter(X_pca[:, 0], X_pca[:, 1], c=y_kmeans, s=50, cmap='viridis')
plt.title('PCA Visualization')
plt.show()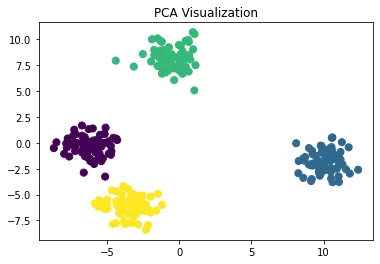
Nastavljanje hiperparametrov
Nastavljanje hiperparametrov je pomemben korak, da model doseže najboljše rezultate. Razred GridSearchCV v knjižnici Scikit-Learn to olajša.
from sklearn.model_selection import GridSearchCV
from sklearn.svm import SVC

# Parametre uzayını tanımla
param_grid = {'C': [0.1, 1, 10], 'kernel': ['rbf', 'linear']}

# Grid search nesnesi oluştur
grid_search = GridSearchCV(SVC(), param_grid, cv=5)

# Grid search'ü uygula
grid_search.fit(X_train, y_train)

print("En iyi parametreler:", grid_search.best_params_)
print("En iyi skor:", grid_search.best_score_)
En iyi parametreler: {'C': 1, 'kernel': 'linear'}
En iyi skor: 0.9583333333333334(Oznake v izpisu so v turščini, ker jih izvirna koda tako izpiše: »najboljši parametri« in »najboljši rezultat«.)
Navzkrižno preverjanje
Navzkrižno preverjanje je pomembna tehnika za merjenje, kako dobro model posplošuje na nove podatke.
import numpy as np

# Örnek sayısını en küçük olan veri setine eşitleyin
min_samples = min(X.shape[0], y.shape[0])

# Rastgele örnekleme yapın
np.random.seed(42)  # Tekrarlanabilirlik için
indices = np.random.choice(X.shape[0], min_samples, replace=False)
X = X[indices]
y = y[:min_samples]  # y zaten daha küçük

print("New X shape:", X.shape)
print("New y shape:", y.shape)
New X shape: (150, 2)
New y shape: (150,)from sklearn.model_selection import cross_val_score
from sklearn.linear_model import LogisticRegression
# Lojistik regresyon modelini oluştur
log_reg = LogisticRegression()
# 5-fold cross-validation uygula
scores = cross_val_score(log_reg, X, y, cv=5)
print("Cross-validation skorları:", scores)
print("Ortalama skor:", scores.mean())Cross-validation skorları: [0.33333333 0.4 0.26666667 0.36666667 0.3 ]
Ortalama skor: 0.33333333333333337Popravek: nizki rezultati tu izvirajo iz prejšnjega koraka, ne iz modela. Koda za ponovno vzorčenje naključno premeša vrstice v X, oznak v y pa ne premeša na enak način, zato se oznake ne ujemajo več z vrsticami in model pade na raven naključja (približno 0,33 pri treh razredih). Če ta korak izpustite ali X in y izberete z enakimi indeksi, se rezultati spet dvignejo. Spodnje metrike in rezultat cevovoda so nizki iz istega razloga, saj uporabljajo iste podatke.
Izbira in inženiring značilk
Izbira in inženiring značilk imata ključno vlogo pri uspešnosti modela. Scikit-Learn ponuja orodja, ki te korake olajšajo.
from sklearn.feature_selection import SelectKBest, f_classif

# En iyi 2 özelliği seç
selector = SelectKBest(f_classif, k=2)
X_new = selector.fit_transform(X, y)

print("Seçilen özellikler:", selector.get_support())
Seçilen özellikler: [ True True]Razložljivost modela
Zlasti pri modelih, kot so odločitvena drevesa, je pomembno razumeti, kako model sprejema odločitve.
from sklearn.tree import plot_tree
import matplotlib.pyplot as plt

# Karar ağacını görselleştir
plt.figure(figsize=(20,10))
plot_tree(tree_model, feature_names=iris.feature_names, class_names=iris.target_names, filled=True)
plt.show()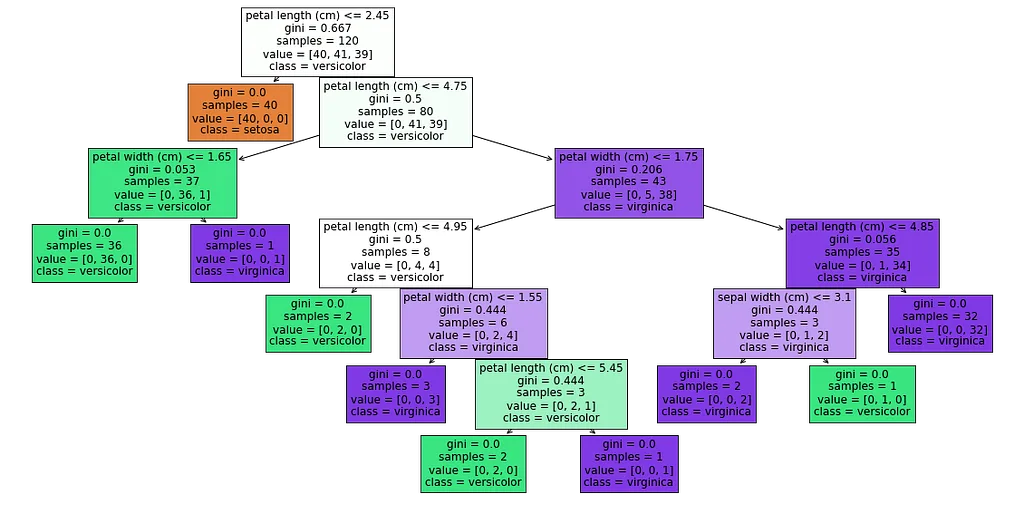
Graf prikazuje odločitveno drevo klasifikatorja, naučenega na zbirki Iris. Drevo z nekaj pravili loči razrede setosa, versicolor in virginica:
- Korenski vozel: pogoj petal length ≤ 2,45 cm; Gini 0,667; 120 primerov, razporeditev [40, 41, 39]. Tu so razredi najbolj pomešani.
- Levi podrejeni vozel: Gini 0,0; vseh 40 primerov je setosa. Že eno samo pravilo povsem loči setoso.
- Desni podrejeni vozel (petal length > 2,45 cm): Gini 0,5; 80 primerov, razporeditev [0, 41, 39]. Versicolor in virginica sta še pomešani.
- Natančnejša delitev: pogoj petal length ≤ 4,75 cm; Gini 0,206; 43 primerov, razporeditev [0, 5, 38], večinoma virginica.
- Nižji vozli: pogoj petal width ≤ 1,75 cm; Gini 0,0; vseh 35 primerov je virginica.
Vsak vozel prikazuje Ginijev koeficient, število primerov in razporeditev razredov, zato natančno vidite, katero značilko model uporabi na katerem mestu in kako odloča.
Ansambelske metode
Ansambelske metode združijo več modelov za močnejše napovedi. Random Forest je med najbolj priljubljenimi.
from sklearn.ensemble import RandomForestClassifier

# Random Forest modeli oluştur ve eğit
rf_model = RandomForestClassifier(n_estimators=100, random_state=42)
rf_model.fit(X_train, y_train)

# Tahmin yap ve doğruluğu ölç
y_pred_rf = rf_model.predict(X_test)
accuracy_rf = accuracy_score(y_test, y_pred_rf)

print(f'Random Forest Model accuracy: {accuracy_rf}')
Random Forest Model accuracy: 1.0Metrike vrednotenja
Poleg točnosti so pomembne tudi druge metrike vrednotenja.
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import classification_report, confusion_matrix

# Veri setini ayır
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)

# Modeli eğit
log_reg = LogisticRegression()
log_reg.fit(X_train, y_train)

# Tahminler yap
y_pred_log = log_reg.predict(X_test)

# Sınıflandırma raporu oluştur
print(classification_report(y_test, y_pred_log, target_names=iris.target_names))

# Confusion matrix oluştur
cm = confusion_matrix(y_test, y_pred_log)
print("Confusion Matrix:\n", cm)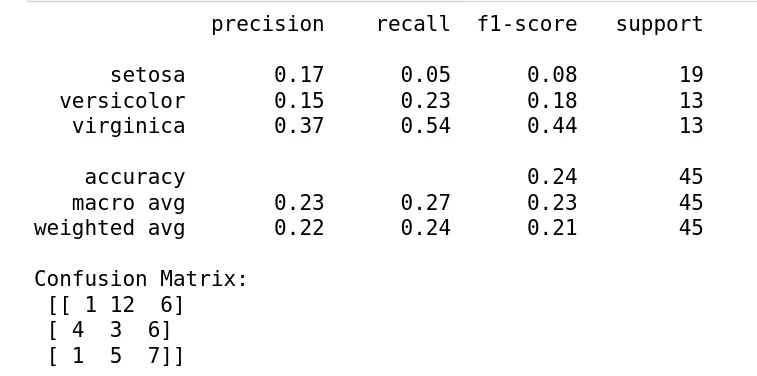
Ti rezultati kažejo uspešnost modela, naučenega na zgoraj premešanih podatkih:
- Natančnost (precision), delež pravilnih med pozitivnimi napovedmi: setosa 17 %, versicolor 15 %, virginica 37 %.
- Priklic (recall), delež dejansko pozitivnih primerov, ki jih model najde: setosa 5 %, versicolor 23 %, virginica 54 %.
- Mera F1, harmonična sredina natančnosti in priklica: setosa 0,08, versicolor 0,18, virginica 0,44.
- Skupna točnost: 24 %.
- Makro povprečje: natančnost 23 %, priklic 27 %, F1 23 %. Uteženo povprečje: natančnost 22 %, priklic 24 %, F1 21 %.
V matriki zmede je pri razredu setosa 1 primer napovedan pravilno, 12 kot versicolor in 6 kot virginica; pri razredu versicolor so 3 napovedani pravilno, 4 kot setosa in 6 kot virginica; pri razredu virginica je 7 napovedanih pravilno, 1 kot setosa in 5 kot versicolor.
Razlaga in predlogi
Skupna uspešnost je nizka; najboljša je virginica, a tudi ta ni dovolj dobra. Kot pojasnjuje popravek zgoraj, so glavni vzrok premešane oznake. Poleg tega uspešnost na splošno izboljšajo ti koraki:
- Preizkusiti močnejše modele, kot sta Random Forest ali SVM, in nastaviti hiperparametre
- Dodati nove značilke ali preoblikovati obstoječe
- Uravnotežiti razrede z metodami, kot je SMOTE, če so neuravnoteženi
- Z navzkrižnim preverjanjem odkriti prekomerno ali premajhno prilagajanje
Uporaba v praksi: segmentacija strank
Kot primer iz prakse vzemimo segmentacijo strank spletne trgovine.
from sklearn.preprocessing import StandardScaler
from sklearn.cluster import KMeans

# Örnek veri oluştur (gerçek senaryoda bu veri müşteri veritabanından gelir)
customer_data = np.random.rand(1000, 3)  # 1000 müşteri, 3 özellik (örn: yaş, toplam harcama, ziyaret sıklığı)

# Veriyi ölçeklendir
scaler = StandardScaler()
customer_data_scaled = scaler.fit_transform(customer_data)

# K-Means uygula
kmeans = KMeans(n_clusters=4, random_state=42)
clusters = kmeans.fit_predict(customer_data_scaled)

print("Müşteri segmentleri:", np.unique(clusters))
Müşteri segmentleri: [0 1 2 3]Cevovodi v Scikit-Learn
Cevovod (pipeline) poveže korake predobdelave in učenja modela, zato je koda čistejša in učinkovitejša.
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler

# Pipeline oluştur
pipeline = Pipeline([
    ('scaler', StandardScaler()),
    ('classifier', LogisticRegression())
])

# Pipeline'ı eğit ve değerlendir
pipeline.fit(X_train, y_train)
accuracy_pipeline = pipeline.score(X_test, y_test)

print(f'Pipeline Model accuracy: {accuracy_pipeline}')
Pipeline Model accuracy: 0.24444444444444444Študija primera: klasifikacija na zbirki Iris
V tej študiji na zbirki Iris uporabimo več algoritmov strojnega učenja in primerjamo rezultate.
Priprava podatkov
Najprej naložimo podatkovno zbirko in jo razdelimo na učno in testno množico.
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split

# Veri setini yükle
iris = load_iris()
X = iris.data
y = iris.target

# Veriyi eğitim ve test olarak ayır
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
Uporaba in primerjava algoritmov
Zdaj uporabimo logistično regresijo, odločitveno drevo in KNN ter primerjamo rezultate.
from sklearn.linear_model import LogisticRegression
from sklearn.tree import DecisionTreeClassifier
from sklearn.neighbors import KNeighborsClassifier
from sklearn.metrics import accuracy_score

# Lojistik Regresyon
log_reg = LogisticRegression(max_iter=200)
log_reg.fit(X_train, y_train)
y_pred_log = log_reg.predict(X_test)
accuracy_log = accuracy_score(y_test, y_pred_log)

# Karar Ağaçları
tree_model = DecisionTreeClassifier(random_state=42)
tree_model.fit(X_train, y_train)
y_pred_tree = tree_model.predict(X_test)
accuracy_tree = accuracy_score(y_test, y_pred_tree)

# KNN
knn = KNeighborsClassifier(n_neighbors=3)
knn.fit(X_train, y_train)
y_pred_knn = knn.predict(X_test)
accuracy_knn = accuracy_score(y_test, y_pred_knn)

print(f'Logistic Regression accuracy: {accuracy_log}')
print(f'Decision Tree accuracy: {accuracy_tree}')
print(f'KNN accuracy: {accuracy_knn}')
Logistic Regression accuracy: 1.0
Decision Tree accuracy: 1.0
KNN accuracy: 1.0Sklep
V tem članku smo s Scikit-Learn prehodili faze postopka strojnega učenja in videli, kako jih uporabiti. Nadzorovane in nenadzorovane algoritme smo uporabili na zbirki Iris, poleg osnovnih algoritmov pa obravnavali optimizacijo, vrednotenje in razlago, uporabo v praksi in cevovode. S široko paleto orodij Scikit-Learn podatkovnim znanstvenikom in praktikom strojnega učenja olajša reševanje zapletenih problemov.
Viri
- Pedregosa, F. idr. (2011). Scikit-learn: Machine Learning in Python. Journal of Machine Learning Research, 12, 2825–2830.
- Dokumentacija Scikit-Learn: scikit-learn.org
- Hastie, T., Tibshirani, R. in Friedman, J. (2009). The Elements of Statistical Learning. Springer.
- Kuhn, M. in Johnson, K. (2013). Applied Predictive Modeling. Springer.
- Géron, A. (2019). Hands-On Machine Learning with Scikit-Learn, Keras, and TensorFlow. O’Reilly Media.
- Müller, A. C. in Guido, S. (2016). Introduction to Machine Learning with Python. O’Reilly Media.
- Raschka, S. in Mirjalili, V. (2019). Python Machine Learning. Packt Publishing.
- VanderPlas, J. (2016). Python Data Science Handbook. O’Reilly Media.