

Python за анализ на данни: машинно обучение със Scikit-Learn
Автор Yasin TANIŞ
Въведение
Машинното обучение е научна област, която позволява на компютрите да се учат от данни и да правят прогнози, и днес се използва в много отрасли. В тази статия разглеждаме Scikit-Learn – една от най-използваните библиотеки на Python за създаване на приложения за машинно обучение.
Какво е Scikit-Learn
Scikit-Learn е библиотека за машинно обучение, която предлага прости и ефективни инструменти за Python. Тя съдържа алгоритми както за обучение с учител, така и за обучение без учител.
Инсталиране
Преди да започнем, библиотеката трябва да се инсталира. Ако все още я нямате в системата си, инсталирайте я със следната команда:
pip install scikit-learnБележка: примерите тук са умишлено прости, за да илюстрират понятията; те невинаги са най-подходящата метрика или метод за всеки сценарий.
Обучение с учител
Обучението с учител работи с етикетирани данни: резултатите (етикетите) на примерите са известни, така че моделът може да се научи да ги предсказва.
Логистична регресия
Логистичната регресия е често използван алгоритъм за класификационни задачи.
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import accuracy_score
# Veri setini yükle
iris = load_iris()
X = iris.data
y = iris.target
# Veriyi eğitim ve test olarak ayır
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
# Model oluştur ve eğit
model = LogisticRegression(max_iter=200)
model.fit(X_train, y_train)
# Tahmin yap ve doğruluğu ölç
y_pred = model.predict(X_test)
accuracy = accuracy_score(y_test, y_pred)
print(f'Model accuracy: {accuracy}')
Model Accuracy : 1.0Този код зарежда набора Iris, разделя го на признаци и целева променлива, обучава модела и отпечатва точността му.
Дървета на решенията
Дърветата на решенията са мощен алгоритъм както за класификация, така и за регресия.
from sklearn.tree import DecisionTreeClassifier

# Model oluştur ve eğit
tree_model = DecisionTreeClassifier(random_state=42)
tree_model.fit(X_train, y_train)

# Tahmin yap ve doğruluğu ölç
y_pred_tree = tree_model.predict(X_test)
accuracy_tree = accuracy_score(y_test, y_pred_tree)

print(f'Decision Tree Model accuracy: {accuracy_tree}')
Decision Tree Model Accuracy: 1.0Обучение без учител
Обучението без учител не използва етикетирани данни; моделът сам се опитва да научи структурата на данните.
Клъстеризация K-Means
K-Means е често срещан алгоритъм за клъстеризация, който разделя данните на k клъстера.
from sklearn.cluster import KMeans
import matplotlib.pyplot as plt

# Örnek veri seti oluştur
from sklearn.datasets import make_blobs
X, _ = make_blobs(n_samples=300, centers=4, random_state=42)

# Model oluştur ve eğit
kmeans = KMeans(n_clusters=4, random_state=42)
kmeans.fit(X)

# Tahmin yap ve kümeleri görselleştir
y_kmeans = kmeans.predict(X)

plt.scatter(X[:, 0], X[:, 1], c=y_kmeans, s=50, cmap='viridis')
centers = kmeans.cluster_centers_
plt.scatter(centers[:, 0], centers[:, 1], c='red', s=200, alpha=0.75)
plt.title('K-Means Clustering')
plt.show()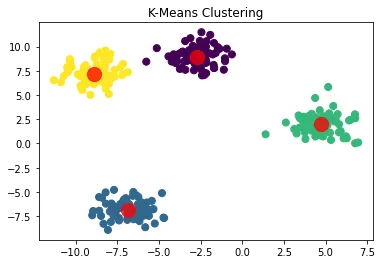
Анализ на главните компоненти (PCA)
PCA е техника за свеждане на многомерни данни до по-малко измерения.
from sklearn.decomposition import PCA

# Model oluştur ve eğit
pca = PCA(n_components=2)
X_pca = pca.fit_transform(X)

plt.scatter(X_pca[:, 0], X_pca[:, 1], c=y_kmeans, s=50, cmap='viridis')
plt.title('PCA Visualization')
plt.show()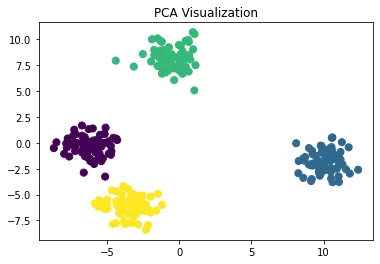
Настройка на хиперпараметри
Настройката на хиперпараметри е важна стъпка, за да се постигне най-доброто представяне на модела. Класът GridSearchCV на Scikit-Learn я улеснява.
from sklearn.model_selection import GridSearchCV
from sklearn.svm import SVC

# Parametre uzayını tanımla
param_grid = {'C': [0.1, 1, 10], 'kernel': ['rbf', 'linear']}

# Grid search nesnesi oluştur
grid_search = GridSearchCV(SVC(), param_grid, cv=5)

# Grid search'ü uygula
grid_search.fit(X_train, y_train)

print("En iyi parametreler:", grid_search.best_params_)
print("En iyi skor:", grid_search.best_score_)
En iyi parametreler: {'C': 1, 'kernel': 'linear'}
En iyi skor: 0.9583333333333334(Етикетите в резултата са на турски, защото оригиналният код ги отпечатва така: „най-добри параметри“ и „най-добър резултат“.)
Кръстосана проверка
Кръстосаната проверка е важна техника за измерване колко добре моделът обобщава върху нови данни.
import numpy as np

# Örnek sayısını en küçük olan veri setine eşitleyin
min_samples = min(X.shape[0], y.shape[0])

# Rastgele örnekleme yapın
np.random.seed(42)  # Tekrarlanabilirlik için
indices = np.random.choice(X.shape[0], min_samples, replace=False)
X = X[indices]
y = y[:min_samples]  # y zaten daha küçük

print("New X shape:", X.shape)
print("New y shape:", y.shape)
New X shape: (150, 2)
New y shape: (150,)from sklearn.model_selection import cross_val_score
from sklearn.linear_model import LogisticRegression
# Lojistik regresyon modelini oluştur
log_reg = LogisticRegression()
# 5-fold cross-validation uygula
scores = cross_val_score(log_reg, X, y, cv=5)
print("Cross-validation skorları:", scores)
print("Ortalama skor:", scores.mean())Cross-validation skorları: [0.33333333 0.4 0.26666667 0.36666667 0.3 ]
Ortalama skor: 0.33333333333333337Бележка за поправка: ниските резултати тук се дължат на предишната стъпка, а не на модела. Кодът за повторна извадка разбърква редовете на X, но не разбърква по същия начин етикетите в y, така че етикетите вече не съответстват на редовете и моделът пада до нивото на случайното отгатване (около 0,33 при три класа). Ако тази стъпка се пропусне или X и y се изберат със същите индекси, резултатите отново се повишават. Метриките и резултатите от pipeline по-долу са ниски по същата причина, тъй като използват същите данни.
Избор и конструиране на признаци
Изборът и конструирането на признаци играят ключова роля за представянето на модела. Scikit-Learn предлага инструменти, които улесняват тези стъпки.
from sklearn.feature_selection import SelectKBest, f_classif

# En iyi 2 özelliği seç
selector = SelectKBest(f_classif, k=2)
X_new = selector.fit_transform(X, y)

print("Seçilen özellikler:", selector.get_support())
Seçilen özellikler: [ True True]Тълкуемост на модела
Особено при модели като дърветата на решенията е важно да се разбере как моделът стига до решенията си.
from sklearn.tree import plot_tree
import matplotlib.pyplot as plt

# Karar ağacını görselleştir
plt.figure(figsize=(20,10))
plot_tree(tree_model, feature_names=iris.feature_names, class_names=iris.target_names, filled=True)
plt.show()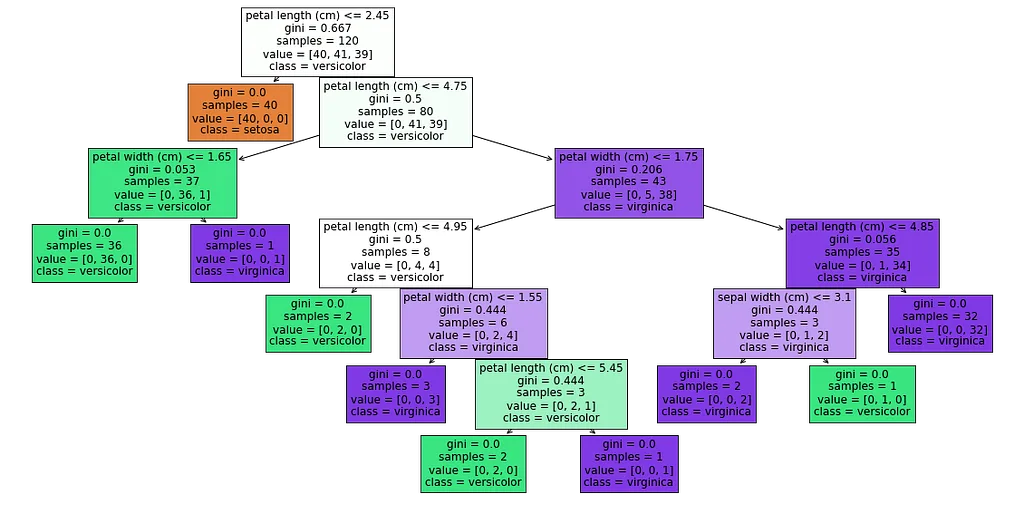
Диаграмата показва дървото на решенията на класификатор, обучен върху набора Iris. С няколко правила дървото разделя класовете setosa, versicolor и virginica:
- Коренов възел: условие petal length ≤ 2,45 см; Gini 0,667; 120 примера, разпределение [40, 41, 39]. Тук класовете са най-смесени.
- Ляв дъщерен възел: Gini 0,0; всичките 40 примера са setosa. Едно-единствено правило отделя setosa напълно.
- Десен дъщерен възел (petal length > 2,45 см): Gini 0,5; 80 примера, разпределение [0, 41, 39]. Versicolor и virginica все още са смесени.
- По-фино разделяне: условие petal length ≤ 4,75 см; Gini 0,206; 43 примера, разпределение [0, 5, 38], предимно virginica.
- По-долни възли: условие petal width ≤ 1,75 см; Gini 0,0; всичките 35 примера са virginica.
Всеки възел показва коефициента на Джини, броя на примерите и разпределението по класове, така че може да се проследи точно кой признак използва моделът в коя точка и как взема решение.
Ансамблови методи
Ансамбловите методи съчетават няколко модела, за да правят по-силни прогнози. Random Forest е сред най-популярните.
from sklearn.ensemble import RandomForestClassifier

# Random Forest modeli oluştur ve eğit
rf_model = RandomForestClassifier(n_estimators=100, random_state=42)
rf_model.fit(X_train, y_train)

# Tahmin yap ve doğruluğu ölç
y_pred_rf = rf_model.predict(X_test)
accuracy_rf = accuracy_score(y_test, y_pred_rf)

print(f'Random Forest Model accuracy: {accuracy_rf}')
Random Forest Model accuracy: 1.0Метрики за оценка
Освен точността важни са и други метрики за оценка.
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import classification_report, confusion_matrix

# Veri setini ayır
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)

# Modeli eğit
log_reg = LogisticRegression()
log_reg.fit(X_train, y_train)

# Tahminler yap
y_pred_log = log_reg.predict(X_test)

# Sınıflandırma raporu oluştur
print(classification_report(y_test, y_pred_log, target_names=iris.target_names))

# Confusion matrix oluştur
cm = confusion_matrix(y_test, y_pred_log)
print("Confusion Matrix:\n", cm)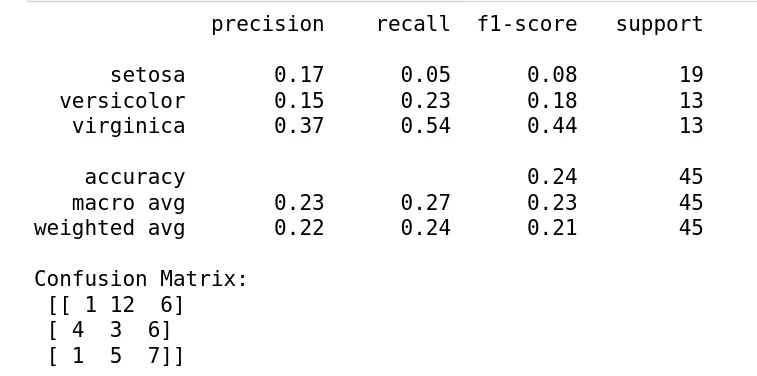
Тези резултати показват представянето на модел, обучен върху разбърканите данни от по-горе:
- Прецизност (precision) – делът на верните сред положителните прогнози: setosa 17 %, versicolor 15 %, virginica 37 %.
- Пълнота (recall) – делът на откритите сред действително положителните: setosa 5 %, versicolor 23 %, virginica 54 %.
- F1 мярка – хармоничното средно на прецизността и пълнотата: setosa 0,08, versicolor 0,18, virginica 0,44.
- Обща точност: 24 %.
- Макро средно: прецизност 23 %, пълнота 27 %, F1 23 %. Претеглено средно: прецизност 22 %, пълнота 24 %, F1 21 %.
В матрицата на объркванията 1 пример setosa е предсказан вярно, 12 – като versicolor и 6 – като virginica; при versicolor има 3 верни, 4 като setosa и 6 като virginica; при virginica – 7 верни, 1 като setosa и 5 като versicolor.
Тълкуване и предложения
Общото представяне е слабо; най-добре се справя virginica, но и това не е достатъчно. Както обяснява бележката за поправка по-горе, основната причина са разбърканите етикети. Освен това следните стъпки по принцип подобряват представянето:
- Да се изпробват по-силни модели като Random Forest или SVM и да се настроят хиперпараметрите им
- Да се добавят нови признаци или да се трансформират съществуващите
- Да се балансират класовете с методи като SMOTE, ако са небалансирани
- Да се използва кръстосана проверка за откриване на преобучение или недообучение
Приложение в практиката: сегментиране на клиенти
Като практическо приложение да разгледаме сегментирането на клиентите на компания за електронна търговия.
from sklearn.preprocessing import StandardScaler
from sklearn.cluster import KMeans

# Örnek veri oluştur (gerçek senaryoda bu veri müşteri veritabanından gelir)
customer_data = np.random.rand(1000, 3)  # 1000 müşteri, 3 özellik (örn: yaş, toplam harcama, ziyaret sıklığı)

# Veriyi ölçeklendir
scaler = StandardScaler()
customer_data_scaled = scaler.fit_transform(customer_data)

# K-Means uygula
kmeans = KMeans(n_clusters=4, random_state=42)
clusters = kmeans.fit_predict(customer_data_scaled)

print("Müşteri segmentleri:", np.unique(clusters))
Müşteri segmentleri: [0 1 2 3]Pipeline в Scikit-Learn
Pipeline свързва стъпките на предварителна обработка и обучение на модела, което прави кода по-чист и по-ефективен.
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler

# Pipeline oluştur
pipeline = Pipeline([
    ('scaler', StandardScaler()),
    ('classifier', LogisticRegression())
])

# Pipeline'ı eğit ve değerlendir
pipeline.fit(X_train, y_train)
accuracy_pipeline = pipeline.score(X_test, y_test)

print(f'Pipeline Model accuracy: {accuracy_pipeline}')
Pipeline Model accuracy: 0.24444444444444444Казус: класификация с набора Iris
В този казус прилагаме няколко алгоритъма за машинно обучение върху набора Iris и сравняваме резултатите.
Подготовка на данните
Първо зареждаме набора от данни и го разделяме на обучаваща и тестова извадка.
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split

# Veri setini yükle
iris = load_iris()
X = iris.data
y = iris.target

# Veriyi eğitim ve test olarak ayır
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
Прилагане и сравнение на алгоритмите
Сега прилагаме логистична регресия, дърво на решенията и KNN и сравняваме резултатите.
from sklearn.linear_model import LogisticRegression
from sklearn.tree import DecisionTreeClassifier
from sklearn.neighbors import KNeighborsClassifier
from sklearn.metrics import accuracy_score

# Lojistik Regresyon
log_reg = LogisticRegression(max_iter=200)
log_reg.fit(X_train, y_train)
y_pred_log = log_reg.predict(X_test)
accuracy_log = accuracy_score(y_test, y_pred_log)

# Karar Ağaçları
tree_model = DecisionTreeClassifier(random_state=42)
tree_model.fit(X_train, y_train)
y_pred_tree = tree_model.predict(X_test)
accuracy_tree = accuracy_score(y_test, y_pred_tree)

# KNN
knn = KNeighborsClassifier(n_neighbors=3)
knn.fit(X_train, y_train)
y_pred_knn = knn.predict(X_test)
accuracy_knn = accuracy_score(y_test, y_pred_knn)

print(f'Logistic Regression accuracy: {accuracy_log}')
print(f'Decision Tree accuracy: {accuracy_tree}')
print(f'KNN accuracy: {accuracy_knn}')
Logistic Regression accuracy: 1.0
Decision Tree accuracy: 1.0
KNN accuracy: 1.0Заключение
В тази статия преминахме през етапите на процеса на машинно обучение със Scikit-Learn и видяхме как се прилагат. Приложихме алгоритми за обучение с учител и без учител върху набора Iris, а освен основните алгоритми разгледахме оптимизацията, оценката и тълкуването, едно практическо приложение и pipeline. С широкия си набор от инструменти Scikit-Learn улеснява специалистите по данни и практиците в машинното обучение при решаването на сложни задачи.
Източници
- Pedregosa, F. и др. (2011). Scikit-learn: Machine Learning in Python. Journal of Machine Learning Research, 12, 2825–2830.
- Документация на Scikit-Learn: scikit-learn.org
- Hastie, T., Tibshirani, R. и Friedman, J. (2009). The Elements of Statistical Learning. Springer.
- Kuhn, M. и Johnson, K. (2013). Applied Predictive Modeling. Springer.
- Géron, A. (2019). Hands-On Machine Learning with Scikit-Learn, Keras, and TensorFlow. O’Reilly Media.
- Müller, A. C. и Guido, S. (2016). Introduction to Machine Learning with Python. O’Reilly Media.
- Raschka, S. и Mirjalili, V. (2019). Python Machine Learning. Packt Publishing.
- VanderPlas, J. (2016). Python Data Science Handbook. O’Reilly Media.