

Python para el análisis de datos: aprendizaje automático con Scikit-Learn
Escrito por Yasin TANIŞ
Introducción
El aprendizaje automático es la rama de la ciencia que permite a los ordenadores aprender de los datos y hacer predicciones, y hoy se usa en muchos sectores. En este artículo analizamos Scikit-Learn, una de las bibliotecas de Python más usadas para crear aplicaciones de aprendizaje automático.
Qué es Scikit-Learn
Scikit-Learn es una biblioteca de aprendizaje automático que ofrece herramientas sencillas y eficientes para Python. Incluye algoritmos de aprendizaje supervisado y no supervisado.
Instalación
Antes de empezar hay que instalar la biblioteca. Si aún no la tiene en su sistema, instálela con este comando:
pip install scikit-learnNota: los ejemplos de este artículo son deliberadamente sencillos para ilustrar los conceptos; no siempre son la mejor métrica o el mejor método para cada escenario.
Aprendizaje supervisado
El aprendizaje supervisado trabaja con datos etiquetados: se conocen los resultados (etiquetas) de los ejemplos, así que el modelo puede aprender a predecirlos.
Regresión logística
La regresión logística es un algoritmo muy usado en problemas de clasificación.
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import accuracy_score
# Veri setini yükle
iris = load_iris()
X = iris.data
y = iris.target
# Veriyi eğitim ve test olarak ayır
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
# Model oluştur ve eğit
model = LogisticRegression(max_iter=200)
model.fit(X_train, y_train)
# Tahmin yap ve doğruluğu ölç
y_pred = model.predict(X_test)
accuracy = accuracy_score(y_test, y_pred)
print(f'Model accuracy: {accuracy}')
Model Accuracy : 1.0Este código carga el conjunto de datos Iris, lo divide en variables predictoras y variable objetivo, entrena el modelo e imprime su exactitud.
Árboles de decisión
Los árboles de decisión son un algoritmo potente tanto para clasificación como para regresión.
from sklearn.tree import DecisionTreeClassifier

# Model oluştur ve eğit
tree_model = DecisionTreeClassifier(random_state=42)
tree_model.fit(X_train, y_train)

# Tahmin yap ve doğruluğu ölç
y_pred_tree = tree_model.predict(X_test)
accuracy_tree = accuracy_score(y_test, y_pred_tree)

print(f'Decision Tree Model accuracy: {accuracy_tree}')
Decision Tree Model Accuracy: 1.0Aprendizaje no supervisado
El aprendizaje no supervisado no usa datos etiquetados; el modelo intenta aprender por sí mismo la estructura de los datos.
Clustering con K-Means
K-Means es un algoritmo de clustering habitual que divide los datos en k clústeres.
from sklearn.cluster import KMeans
import matplotlib.pyplot as plt

# Örnek veri seti oluştur
from sklearn.datasets import make_blobs
X, _ = make_blobs(n_samples=300, centers=4, random_state=42)

# Model oluştur ve eğit
kmeans = KMeans(n_clusters=4, random_state=42)
kmeans.fit(X)

# Tahmin yap ve kümeleri görselleştir
y_kmeans = kmeans.predict(X)

plt.scatter(X[:, 0], X[:, 1], c=y_kmeans, s=50, cmap='viridis')
centers = kmeans.cluster_centers_
plt.scatter(centers[:, 0], centers[:, 1], c='red', s=200, alpha=0.75)
plt.title('K-Means Clustering')
plt.show()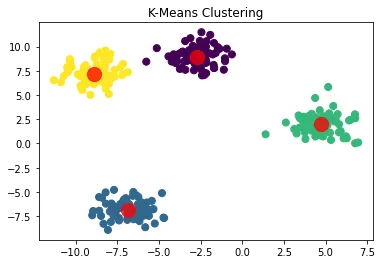
Análisis de componentes principales (PCA)
El PCA es una técnica para reducir datos de alta dimensión a menos dimensiones.
from sklearn.decomposition import PCA

# Model oluştur ve eğit
pca = PCA(n_components=2)
X_pca = pca.fit_transform(X)

plt.scatter(X_pca[:, 0], X_pca[:, 1], c=y_kmeans, s=50, cmap='viridis')
plt.title('PCA Visualization')
plt.show()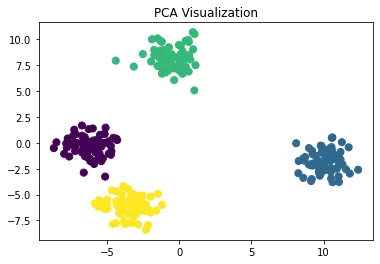
Ajuste de hiperparámetros
El ajuste de hiperparámetros es un paso importante para obtener el mejor rendimiento de un modelo. La clase GridSearchCV de Scikit-Learn lo facilita.
from sklearn.model_selection import GridSearchCV
from sklearn.svm import SVC

# Parametre uzayını tanımla
param_grid = {'C': [0.1, 1, 10], 'kernel': ['rbf', 'linear']}

# Grid search nesnesi oluştur
grid_search = GridSearchCV(SVC(), param_grid, cv=5)

# Grid search'ü uygula
grid_search.fit(X_train, y_train)

print("En iyi parametreler:", grid_search.best_params_)
print("En iyi skor:", grid_search.best_score_)
En iyi parametreler: {'C': 1, 'kernel': 'linear'}
En iyi skor: 0.9583333333333334(Las etiquetas de la salida están en turco porque el código original las imprime así: «mejores parámetros» y «mejor puntuación».)
Validación cruzada
La validación cruzada es una técnica importante para medir en qué medida un modelo generaliza bien a datos nuevos.
import numpy as np

# Örnek sayısını en küçük olan veri setine eşitleyin
min_samples = min(X.shape[0], y.shape[0])

# Rastgele örnekleme yapın
np.random.seed(42)  # Tekrarlanabilirlik için
indices = np.random.choice(X.shape[0], min_samples, replace=False)
X = X[indices]
y = y[:min_samples]  # y zaten daha küçük

print("New X shape:", X.shape)
print("New y shape:", y.shape)
New X shape: (150, 2)
New y shape: (150,)from sklearn.model_selection import cross_val_score
from sklearn.linear_model import LogisticRegression
# Lojistik regresyon modelini oluştur
log_reg = LogisticRegression()
# 5-fold cross-validation uygula
scores = cross_val_score(log_reg, X, y, cv=5)
print("Cross-validation skorları:", scores)
print("Ortalama skor:", scores.mean())Cross-validation skorları: [0.33333333 0.4 0.26666667 0.36666667 0.3 ]
Ortalama skor: 0.33333333333333337Nota de corrección: las puntuaciones bajas de aquí proceden del paso anterior, no del modelo. El código de remuestreo baraja las filas de X, pero no baraja del mismo modo las etiquetas de y, así que las etiquetas dejan de corresponder a las filas y el modelo cae al nivel del azar (alrededor de 0,33 con tres clases). Si se omite ese paso o se seleccionan X e y con los mismos índices, las puntuaciones vuelven a subir. Las métricas y los resultados del pipeline que aparecen más abajo también son bajos por la misma razón, porque usan los mismos datos.
Selección e ingeniería de variables
La selección y la ingeniería de variables tienen un papel clave en el rendimiento del modelo. Scikit-Learn ofrece herramientas que facilitan estos pasos.
from sklearn.feature_selection import SelectKBest, f_classif

# En iyi 2 özelliği seç
selector = SelectKBest(f_classif, k=2)
X_new = selector.fit_transform(X, y)

print("Seçilen özellikler:", selector.get_support())
Seçilen özellikler: [ True True]Interpretabilidad del modelo
Sobre todo en modelos como los árboles de decisión, es importante entender cómo llega el modelo a sus decisiones.
from sklearn.tree import plot_tree
import matplotlib.pyplot as plt

# Karar ağacını görselleştir
plt.figure(figsize=(20,10))
plot_tree(tree_model, feature_names=iris.feature_names, class_names=iris.target_names, filled=True)
plt.show()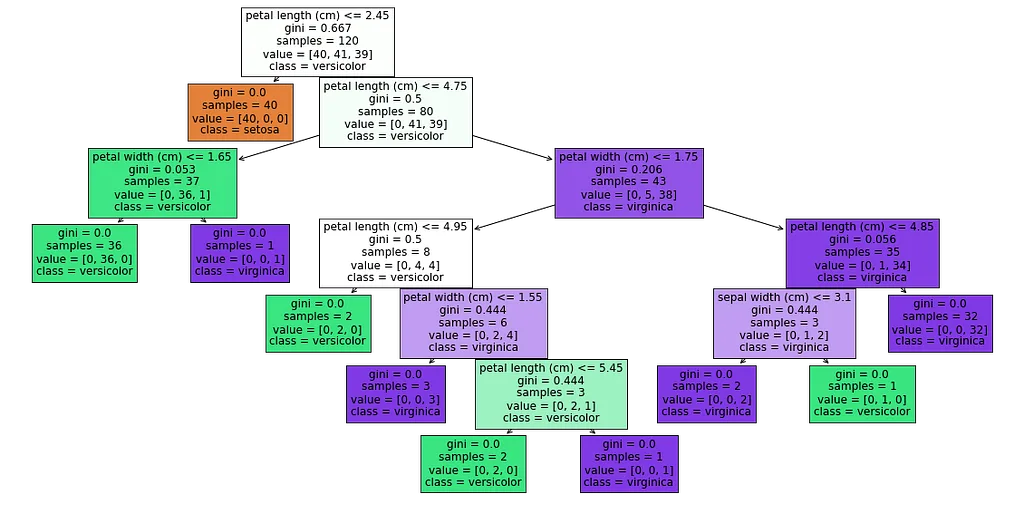
El gráfico muestra el árbol de decisión de un clasificador entrenado con el conjunto de datos Iris. Con unas pocas reglas, el árbol separa las clases setosa, versicolor y virginica:
- Nodo raíz: condición petal length ≤ 2,45 cm; Gini 0,667; 120 ejemplos, reparto [40, 41, 39]. Aquí las clases están más mezcladas.
- Nodo hijo izquierdo: Gini 0,0; los 40 ejemplos son setosa. Una sola regla separa por completo la setosa.
- Nodo hijo derecho (petal length > 2,45 cm): Gini 0,5; 80 ejemplos, reparto [0, 41, 39]. Versicolor y virginica siguen mezcladas.
- Separación más fina: condición petal length ≤ 4,75 cm; Gini 0,206; 43 ejemplos, reparto [0, 5, 38], sobre todo virginica.
- Nodos inferiores: condición petal width ≤ 1,75 cm; Gini 0,0; los 35 ejemplos son virginica.
Cada nodo muestra el coeficiente de Gini, el número de ejemplos y el reparto de clases, de modo que puede seguir exactamente qué variable usa el modelo en cada punto y cómo decide.
Métodos de ensemble
Los métodos de ensemble combinan varios modelos para obtener predicciones más sólidas. Random Forest es uno de los más populares.
from sklearn.ensemble import RandomForestClassifier

# Random Forest modeli oluştur ve eğit
rf_model = RandomForestClassifier(n_estimators=100, random_state=42)
rf_model.fit(X_train, y_train)

# Tahmin yap ve doğruluğu ölç
y_pred_rf = rf_model.predict(X_test)
accuracy_rf = accuracy_score(y_test, y_pred_rf)

print(f'Random Forest Model accuracy: {accuracy_rf}')
Random Forest Model accuracy: 1.0Métricas de evaluación
Además de la exactitud, también importan otras métricas de evaluación.
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import classification_report, confusion_matrix

# Veri setini ayır
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)

# Modeli eğit
log_reg = LogisticRegression()
log_reg.fit(X_train, y_train)

# Tahminler yap
y_pred_log = log_reg.predict(X_test)

# Sınıflandırma raporu oluştur
print(classification_report(y_test, y_pred_log, target_names=iris.target_names))

# Confusion matrix oluştur
cm = confusion_matrix(y_test, y_pred_log)
print("Confusion Matrix:\n", cm)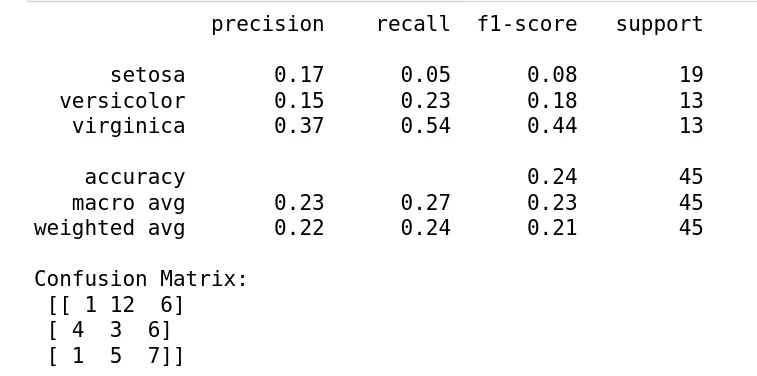
Estos resultados muestran el rendimiento de un modelo entrenado con los datos barajados de arriba:
- Precisión, la proporción de predicciones positivas correctas: setosa 17 %, versicolor 15 %, virginica 37 %.
- Exhaustividad (recall), la proporción de positivos reales encontrados: setosa 5 %, versicolor 23 %, virginica 54 %.
- Puntuación F1, la media armónica de precisión y exhaustividad: setosa 0,08, versicolor 0,18, virginica 0,44.
- Exactitud global: 24 %.
- Media macro: precisión 23 %, exhaustividad 27 %, F1 23 %. Media ponderada: precisión 22 %, exhaustividad 24 %, F1 21 %.
En la matriz de confusión, 1 ejemplo de setosa se predice correctamente, 12 como versicolor y 6 como virginica; en versicolor hay 3 aciertos, 4 como setosa y 6 como virginica; en virginica, 7 aciertos, 1 como setosa y 5 como versicolor.
Interpretación y sugerencias
El rendimiento general es bajo; virginica es la que mejor resulta, pero aun así no lo bastante bien. Como explica la nota de corrección anterior, la causa principal son las etiquetas barajadas. Además, en general estos pasos mejoran el rendimiento:
- Probar modelos más potentes como Random Forest o SVM y ajustar sus hiperparámetros
- Añadir variables nuevas o transformar las existentes
- Equilibrar las clases con métodos como SMOTE si están desequilibradas
- Usar validación cruzada para detectar sobreajuste o infraajuste
Una aplicación real: segmentación de clientes
Como aplicación real, consideremos la segmentación de clientes de una empresa de comercio electrónico.
from sklearn.preprocessing import StandardScaler
from sklearn.cluster import KMeans

# Örnek veri oluştur (gerçek senaryoda bu veri müşteri veritabanından gelir)
customer_data = np.random.rand(1000, 3)  # 1000 müşteri, 3 özellik (örn: yaş, toplam harcama, ziyaret sıklığı)

# Veriyi ölçeklendir
scaler = StandardScaler()
customer_data_scaled = scaler.fit_transform(customer_data)

# K-Means uygula
kmeans = KMeans(n_clusters=4, random_state=42)
clusters = kmeans.fit_predict(customer_data_scaled)

print("Müşteri segmentleri:", np.unique(clusters))
Müşteri segmentleri: [0 1 2 3]Pipelines de Scikit-Learn
Un pipeline encadena los pasos de preprocesamiento y de entrenamiento del modelo, lo que hace que el código sea más limpio y eficiente.
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler

# Pipeline oluştur
pipeline = Pipeline([
    ('scaler', StandardScaler()),
    ('classifier', LogisticRegression())
])

# Pipeline'ı eğit ve değerlendir
pipeline.fit(X_train, y_train)
accuracy_pipeline = pipeline.score(X_test, y_test)

print(f'Pipeline Model accuracy: {accuracy_pipeline}')
Pipeline Model accuracy: 0.24444444444444444Caso práctico: clasificación con el conjunto Iris
En este caso práctico aplicamos varios algoritmos de aprendizaje automático al conjunto Iris y comparamos los resultados.
Preparar los datos
Primero cargamos el conjunto de datos y lo dividimos en conjuntos de entrenamiento y de prueba.
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split

# Veri setini yükle
iris = load_iris()
X = iris.data
y = iris.target

# Veriyi eğitim ve test olarak ayır
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
Aplicar y comparar los algoritmos
Ahora aplicamos regresión logística, un árbol de decisión y KNN y comparamos los resultados.
from sklearn.linear_model import LogisticRegression
from sklearn.tree import DecisionTreeClassifier
from sklearn.neighbors import KNeighborsClassifier
from sklearn.metrics import accuracy_score

# Lojistik Regresyon
log_reg = LogisticRegression(max_iter=200)
log_reg.fit(X_train, y_train)
y_pred_log = log_reg.predict(X_test)
accuracy_log = accuracy_score(y_test, y_pred_log)

# Karar Ağaçları
tree_model = DecisionTreeClassifier(random_state=42)
tree_model.fit(X_train, y_train)
y_pred_tree = tree_model.predict(X_test)
accuracy_tree = accuracy_score(y_test, y_pred_tree)

# KNN
knn = KNeighborsClassifier(n_neighbors=3)
knn.fit(X_train, y_train)
y_pred_knn = knn.predict(X_test)
accuracy_knn = accuracy_score(y_test, y_pred_knn)

print(f'Logistic Regression accuracy: {accuracy_log}')
print(f'Decision Tree accuracy: {accuracy_tree}')
print(f'KNN accuracy: {accuracy_knn}')
Logistic Regression accuracy: 1.0
Decision Tree accuracy: 1.0
KNN accuracy: 1.0Conclusión
En este artículo hemos recorrido las etapas de un proceso de aprendizaje automático con Scikit-Learn y hemos visto cómo aplicarlas. Hemos usado algoritmos supervisados y no supervisados con el conjunto de datos Iris y, además de los algoritmos básicos, hemos tratado la optimización, la evaluación y la interpretación, una aplicación real y los pipelines. Con su amplio conjunto de herramientas, Scikit-Learn facilita a científicos de datos y profesionales del aprendizaje automático la resolución de problemas complejos.
Referencias
- Pedregosa, F. et al. (2011). Scikit-learn: Machine Learning in Python. Journal of Machine Learning Research, 12, 2825–2830.
- Documentación de Scikit-Learn: scikit-learn.org
- Hastie, T., Tibshirani, R. y Friedman, J. (2009). The Elements of Statistical Learning. Springer.
- Kuhn, M. y Johnson, K. (2013). Applied Predictive Modeling. Springer.
- Géron, A. (2019). Hands-On Machine Learning with Scikit-Learn, Keras, and TensorFlow. O’Reilly Media.
- Müller, A. C. y Guido, S. (2016). Introduction to Machine Learning with Python. O’Reilly Media.
- Raschka, S. y Mirjalili, V. (2019). Python Machine Learning. Packt Publishing.
- VanderPlas, J. (2016). Python Data Science Handbook. O’Reilly Media.