

Python pentru analiza datelor: învățare automată cu Scikit-Learn
Scris de Yasin TANIŞ
Introducere
Învățarea automată este ramura științei care permite calculatoarelor să învețe din date și să facă predicții, iar astăzi este folosită în multe domenii. În acest articol analizăm Scikit-Learn, una dintre cele mai folosite biblioteci Python pentru aplicații de învățare automată.
Ce este Scikit-Learn
Scikit-Learn este o bibliotecă de învățare automată cu instrumente simple și eficiente pentru Python. Conține algoritmi atât pentru învățarea supervizată, cât și pentru cea nesupervizată.
Instalare
Înainte de a începe, biblioteca trebuie instalată. Dacă nu o aveți încă în sistem, instalați-o cu această comandă:
pip install scikit-learnNotă: exemplele sunt intenționat simple pentru a ilustra conceptele; nu sunt întotdeauna cea mai bună măsură sau metodă pentru orice scenariu.
Învățare supervizată
Învățarea supervizată lucrează cu date etichetate: rezultatele (etichetele) exemplelor sunt cunoscute, așa că modelul poate învăța să le prezică.
Regresie logistică
Regresia logistică este un algoritm larg folosit pentru probleme de clasificare.
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import accuracy_score
# Veri setini yükle
iris = load_iris()
X = iris.data
y = iris.target
# Veriyi eğitim ve test olarak ayır
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
# Model oluştur ve eğit
model = LogisticRegression(max_iter=200)
model.fit(X_train, y_train)
# Tahmin yap ve doğruluğu ölç
y_pred = model.predict(X_test)
accuracy = accuracy_score(y_test, y_pred)
print(f'Model accuracy: {accuracy}')
Model Accuracy : 1.0Acest cod încarcă setul Iris, îl împarte în caracteristici și țintă, antrenează modelul și afișează acuratețea lui.
Arbori de decizie
Arborii de decizie sunt un algoritm puternic atât pentru clasificare, cât și pentru regresie.
from sklearn.tree import DecisionTreeClassifier

# Model oluştur ve eğit
tree_model = DecisionTreeClassifier(random_state=42)
tree_model.fit(X_train, y_train)

# Tahmin yap ve doğruluğu ölç
y_pred_tree = tree_model.predict(X_test)
accuracy_tree = accuracy_score(y_test, y_pred_tree)

print(f'Decision Tree Model accuracy: {accuracy_tree}')
Decision Tree Model Accuracy: 1.0Învățare nesupervizată
Învățarea nesupervizată nu folosește date etichetate; modelul încearcă singur să învețe structura datelor.
Clusterizare K-Means
K-Means este un algoritm de clusterizare uzual care împarte datele în k clustere.
from sklearn.cluster import KMeans
import matplotlib.pyplot as plt

# Örnek veri seti oluştur
from sklearn.datasets import make_blobs
X, _ = make_blobs(n_samples=300, centers=4, random_state=42)

# Model oluştur ve eğit
kmeans = KMeans(n_clusters=4, random_state=42)
kmeans.fit(X)

# Tahmin yap ve kümeleri görselleştir
y_kmeans = kmeans.predict(X)

plt.scatter(X[:, 0], X[:, 1], c=y_kmeans, s=50, cmap='viridis')
centers = kmeans.cluster_centers_
plt.scatter(centers[:, 0], centers[:, 1], c='red', s=200, alpha=0.75)
plt.title('K-Means Clustering')
plt.show()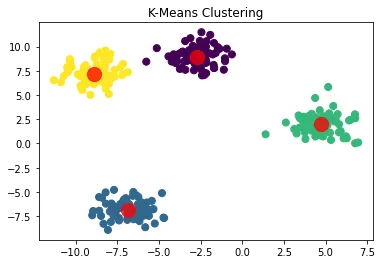
Analiza componentelor principale (PCA)
PCA este o tehnică pentru reducerea datelor multidimensionale la mai puține dimensiuni.
from sklearn.decomposition import PCA

# Model oluştur ve eğit
pca = PCA(n_components=2)
X_pca = pca.fit_transform(X)

plt.scatter(X_pca[:, 0], X_pca[:, 1], c=y_kmeans, s=50, cmap='viridis')
plt.title('PCA Visualization')
plt.show()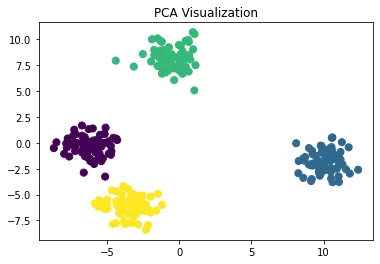
Reglarea hiperparametrilor
Reglarea hiperparametrilor este un pas important pentru ca modelul să dea cele mai bune rezultate. Clasa GridSearchCV din Scikit-Learn o ușurează.
from sklearn.model_selection import GridSearchCV
from sklearn.svm import SVC

# Parametre uzayını tanımla
param_grid = {'C': [0.1, 1, 10], 'kernel': ['rbf', 'linear']}

# Grid search nesnesi oluştur
grid_search = GridSearchCV(SVC(), param_grid, cv=5)

# Grid search'ü uygula
grid_search.fit(X_train, y_train)

print("En iyi parametreler:", grid_search.best_params_)
print("En iyi skor:", grid_search.best_score_)
En iyi parametreler: {'C': 1, 'kernel': 'linear'}
En iyi skor: 0.9583333333333334(Etichetele din rezultat sunt în turcă, deoarece codul original le afișează așa: „cei mai buni parametri” și „cel mai bun scor”.)
Validare încrucișată
Validarea încrucișată este o tehnică importantă pentru a măsura cât de bine generalizează modelul pe date noi.
import numpy as np

# Örnek sayısını en küçük olan veri setine eşitleyin
min_samples = min(X.shape[0], y.shape[0])

# Rastgele örnekleme yapın
np.random.seed(42)  # Tekrarlanabilirlik için
indices = np.random.choice(X.shape[0], min_samples, replace=False)
X = X[indices]
y = y[:min_samples]  # y zaten daha küçük

print("New X shape:", X.shape)
print("New y shape:", y.shape)
New X shape: (150, 2)
New y shape: (150,)from sklearn.model_selection import cross_val_score
from sklearn.linear_model import LogisticRegression
# Lojistik regresyon modelini oluştur
log_reg = LogisticRegression()
# 5-fold cross-validation uygula
scores = cross_val_score(log_reg, X, y, cv=5)
print("Cross-validation skorları:", scores)
print("Ortalama skor:", scores.mean())Cross-validation skorları: [0.33333333 0.4 0.26666667 0.36666667 0.3 ]
Ortalama skor: 0.33333333333333337Notă de corectură: scorurile mici de aici provin din pasul anterior, nu din model. Codul de reeșantionare amestecă aleator rândurile lui X, dar nu amestecă la fel etichetele din y, așa că etichetele nu mai corespund rândurilor și modelul coboară la nivelul hazardului (circa 0,33 cu trei clase). Dacă omiteți acest pas sau selectați X și y cu aceiași indici, scorurile cresc din nou. Metricile și rezultatele pipeline-ului de mai jos sunt mici din același motiv, fiindcă folosesc aceleași date.
Selecția și ingineria caracteristicilor
Selecția și ingineria caracteristicilor joacă un rol esențial în performanța modelului. Scikit-Learn oferă instrumente care ușurează acești pași.
from sklearn.feature_selection import SelectKBest, f_classif

# En iyi 2 özelliği seç
selector = SelectKBest(f_classif, k=2)
X_new = selector.fit_transform(X, y)

print("Seçilen özellikler:", selector.get_support())
Seçilen özellikler: [ True True]Interpretabilitatea modelului
Mai ales la modele precum arborii de decizie, este important să înțelegem cum ajunge modelul la decizii.
from sklearn.tree import plot_tree
import matplotlib.pyplot as plt

# Karar ağacını görselleştir
plt.figure(figsize=(20,10))
plot_tree(tree_model, feature_names=iris.feature_names, class_names=iris.target_names, filled=True)
plt.show()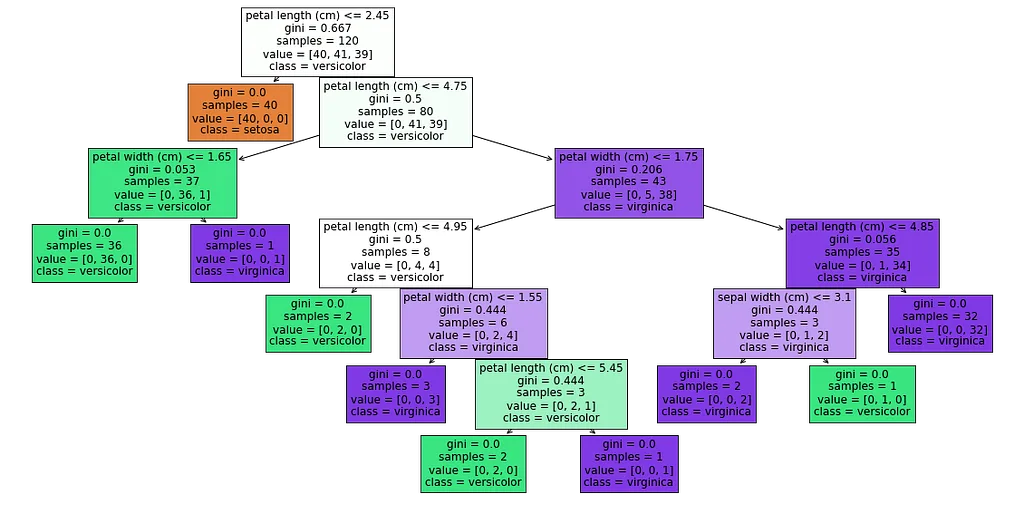
Diagrama arată arborele de decizie al unui clasificator antrenat pe setul Iris. Cu câteva reguli, arborele separă clasele setosa, versicolor și virginica:
- Nodul rădăcină: condiția petal length ≤ 2,45 cm; Gini 0,667; 120 de exemple, distribuție [40, 41, 39]. Aici clasele sunt cele mai amestecate.
- Nodul-copil stâng: Gini 0,0; toate cele 40 de exemple sunt setosa. O singură regulă separă complet setosa.
- Nodul-copil drept (petal length > 2,45 cm): Gini 0,5; 80 de exemple, distribuție [0, 41, 39]. Versicolor și virginica sunt încă amestecate.
- Separare mai fină: condiția petal length ≤ 4,75 cm; Gini 0,206; 43 de exemple, distribuție [0, 5, 38], în majoritate virginica.
- Nodurile inferioare: condiția petal width ≤ 1,75 cm; Gini 0,0; toate cele 35 de exemple sunt virginica.
Fiecare nod arată coeficientul Gini, numărul de exemple și distribuția claselor, așa că puteți urmări exact ce caracteristică folosește modelul în fiecare punct și cum decide.
Metode de ansamblu
Metodele de ansamblu combină mai multe modele pentru predicții mai puternice. Random Forest este una dintre cele mai populare.
from sklearn.ensemble import RandomForestClassifier

# Random Forest modeli oluştur ve eğit
rf_model = RandomForestClassifier(n_estimators=100, random_state=42)
rf_model.fit(X_train, y_train)

# Tahmin yap ve doğruluğu ölç
y_pred_rf = rf_model.predict(X_test)
accuracy_rf = accuracy_score(y_test, y_pred_rf)

print(f'Random Forest Model accuracy: {accuracy_rf}')
Random Forest Model accuracy: 1.0Metrici de evaluare
Dincolo de acuratețe, contează și alte metrici de evaluare.
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import classification_report, confusion_matrix

# Veri setini ayır
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)

# Modeli eğit
log_reg = LogisticRegression()
log_reg.fit(X_train, y_train)

# Tahminler yap
y_pred_log = log_reg.predict(X_test)

# Sınıflandırma raporu oluştur
print(classification_report(y_test, y_pred_log, target_names=iris.target_names))

# Confusion matrix oluştur
cm = confusion_matrix(y_test, y_pred_log)
print("Confusion Matrix:\n", cm)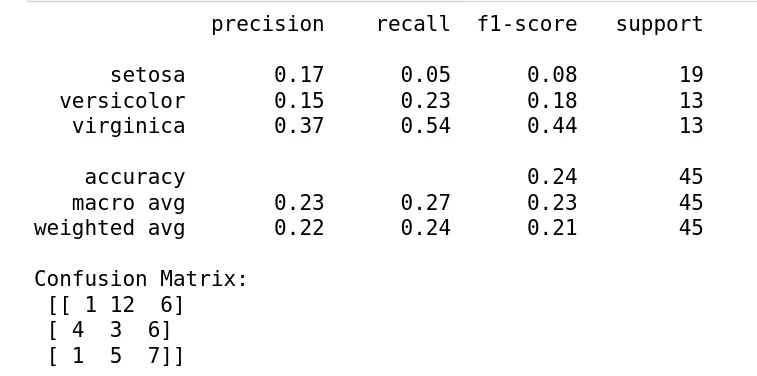
Aceste rezultate arată performanța unui model antrenat pe datele amestecate de mai sus:
- Precizia, proporția predicțiilor pozitive corecte: setosa 17 %, versicolor 15 %, virginica 37 %.
- Recall-ul, proporția cazurilor pozitive reale care sunt identificate: setosa 5 %, versicolor 23 %, virginica 54 %.
- Scorul F1, media armonică a preciziei și recall-ului: setosa 0,08, versicolor 0,18, virginica 0,44.
- Acuratețea generală: 24 %.
- Media macro: precizie 23 %, recall 27 %, F1 23 %. Media ponderată: precizie 22 %, recall 24 %, F1 21 %.
În matricea de confuzie, 1 exemplu setosa este prezis corect, 12 ca versicolor și 6 ca virginica; la versicolor 3 corecte, 4 ca setosa și 6 ca virginica; la virginica 7 corecte, 1 ca setosa și 5 ca versicolor.
Interpretare și sugestii
Performanța generală este slabă; virginica se descurcă cel mai bine, dar tot insuficient. Așa cum explică nota de corectură de mai sus, cauza principală sunt etichetele amestecate. În afară de asta, acești pași îmbunătățesc în general performanța:
- Încercarea unor modele mai puternice, precum Random Forest sau SVM, și reglarea hiperparametrilor
- Adăugarea de caracteristici noi sau transformarea celor existente
- Echilibrarea claselor cu metode precum SMOTE, dacă sunt dezechilibrate
- Folosirea validării încrucișate pentru a depista supraînvățarea sau subînvățarea
Aplicație practică: segmentarea clienților
Ca aplicație practică, să luăm segmentarea clienților unei companii de comerț electronic.
from sklearn.preprocessing import StandardScaler
from sklearn.cluster import KMeans

# Örnek veri oluştur (gerçek senaryoda bu veri müşteri veritabanından gelir)
customer_data = np.random.rand(1000, 3)  # 1000 müşteri, 3 özellik (örn: yaş, toplam harcama, ziyaret sıklığı)

# Veriyi ölçeklendir
scaler = StandardScaler()
customer_data_scaled = scaler.fit_transform(customer_data)

# K-Means uygula
kmeans = KMeans(n_clusters=4, random_state=42)
clusters = kmeans.fit_predict(customer_data_scaled)

print("Müşteri segmentleri:", np.unique(clusters))
Müşteri segmentleri: [0 1 2 3]Pipeline-uri în Scikit-Learn
Un pipeline leagă pașii de preprocesare și de antrenare a modelului, ceea ce face codul mai curat și mai eficient.
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler

# Pipeline oluştur
pipeline = Pipeline([
    ('scaler', StandardScaler()),
    ('classifier', LogisticRegression())
])

# Pipeline'ı eğit ve değerlendir
pipeline.fit(X_train, y_train)
accuracy_pipeline = pipeline.score(X_test, y_test)

print(f'Pipeline Model accuracy: {accuracy_pipeline}')
Pipeline Model accuracy: 0.24444444444444444Studiu de caz: clasificare cu setul Iris
În acest studiu de caz aplicăm mai mulți algoritmi de învățare automată pe setul Iris și comparăm rezultatele.
Pregătirea datelor
Mai întâi încărcăm setul de date și îl împărțim în seturi de antrenare și de test.
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split

# Veri setini yükle
iris = load_iris()
X = iris.data
y = iris.target

# Veriyi eğitim ve test olarak ayır
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
Aplicarea și compararea algoritmilor
Acum aplicăm regresia logistică, un arbore de decizie și KNN și comparăm rezultatele.
from sklearn.linear_model import LogisticRegression
from sklearn.tree import DecisionTreeClassifier
from sklearn.neighbors import KNeighborsClassifier
from sklearn.metrics import accuracy_score

# Lojistik Regresyon
log_reg = LogisticRegression(max_iter=200)
log_reg.fit(X_train, y_train)
y_pred_log = log_reg.predict(X_test)
accuracy_log = accuracy_score(y_test, y_pred_log)

# Karar Ağaçları
tree_model = DecisionTreeClassifier(random_state=42)
tree_model.fit(X_train, y_train)
y_pred_tree = tree_model.predict(X_test)
accuracy_tree = accuracy_score(y_test, y_pred_tree)

# KNN
knn = KNeighborsClassifier(n_neighbors=3)
knn.fit(X_train, y_train)
y_pred_knn = knn.predict(X_test)
accuracy_knn = accuracy_score(y_test, y_pred_knn)

print(f'Logistic Regression accuracy: {accuracy_log}')
print(f'Decision Tree accuracy: {accuracy_tree}')
print(f'KNN accuracy: {accuracy_knn}')
Logistic Regression accuracy: 1.0
Decision Tree accuracy: 1.0
KNN accuracy: 1.0Concluzie
În acest articol am parcurs etapele unui proces de învățare automată cu Scikit-Learn și am văzut cum se aplică. Am folosit algoritmi supervizați și nesupervizați pe setul Iris și, dincolo de algoritmii de bază, am acoperit optimizarea, evaluarea și interpretarea, o aplicație practică și pipeline-urile. Cu gama sa largă de instrumente, Scikit-Learn ușurează rezolvarea problemelor complexe pentru specialiștii în știința datelor și practicienii învățării automate.
Surse
- Pedregosa, F. et al. (2011). Scikit-learn: Machine Learning in Python. Journal of Machine Learning Research, 12, 2825–2830.
- Documentația Scikit-Learn: scikit-learn.org
- Hastie, T., Tibshirani, R. și Friedman, J. (2009). The Elements of Statistical Learning. Springer.
- Kuhn, M. și Johnson, K. (2013). Applied Predictive Modeling. Springer.
- Géron, A. (2019). Hands-On Machine Learning with Scikit-Learn, Keras, and TensorFlow. O’Reilly Media.
- Müller, A. C. și Guido, S. (2016). Introduction to Machine Learning with Python. O’Reilly Media.
- Raschka, S. și Mirjalili, V. (2019). Python Machine Learning. Packt Publishing.
- VanderPlas, J. (2016). Python Data Science Handbook. O’Reilly Media.