

Python для аналізу даних: машинне навчання зі Scikit-Learn
Автор: Yasin TANIŞ
Вступ
Машинне навчання — це галузь науки, що дає комп’ютерам змогу вчитися на даних і робити прогнози; сьогодні воно застосовується в багатьох сферах. У цій статті ми розглянемо Scikit-Learn, одну з найпопулярніших бібліотек Python для створення застосунків машинного навчання.
Що таке Scikit-Learn
Scikit-Learn — бібліотека машинного навчання з простими й ефективними інструментами для Python. Вона містить алгоритми навчання з учителем і без учителя.
Встановлення
Перш ніж почати, бібліотеку потрібно встановити. Якщо її ще немає у вашій системі, встановіть її цією командою:
pip install scikit-learnПримітка: приклади тут навмисно прості, щоб проілюструвати поняття; вони не завжди демонструють найкращу метрику чи метод для кожного сценарію.
Навчання з учителем
Навчання з учителем працює з розміченими даними: результати (мітки) прикладів відомі, тож модель може навчитися їх передбачати.
Логістична регресія
Логістична регресія — поширений алгоритм для задач класифікації.
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import accuracy_score
# Veri setini yükle
iris = load_iris()
X = iris.data
y = iris.target
# Veriyi eğitim ve test olarak ayır
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
# Model oluştur ve eğit
model = LogisticRegression(max_iter=200)
model.fit(X_train, y_train)
# Tahmin yap ve doğruluğu ölç
y_pred = model.predict(X_test)
accuracy = accuracy_score(y_test, y_pred)
print(f'Model accuracy: {accuracy}')
Model Accuracy : 1.0Цей код завантажує набір даних Iris, ділить його на ознаки й цільову змінну, навчає модель і виводить її точність.
Дерева рішень
Дерева рішень — потужний алгоритм і для класифікації, і для регресії.
from sklearn.tree import DecisionTreeClassifier

# Model oluştur ve eğit
tree_model = DecisionTreeClassifier(random_state=42)
tree_model.fit(X_train, y_train)

# Tahmin yap ve doğruluğu ölç
y_pred_tree = tree_model.predict(X_test)
accuracy_tree = accuracy_score(y_test, y_pred_tree)

print(f'Decision Tree Model accuracy: {accuracy_tree}')
Decision Tree Model Accuracy: 1.0Навчання без учителя
Навчання без учителя не використовує розмічених даних; модель намагається сама виявити структуру даних.
Кластеризація K-Means
K-Means — поширений алгоритм кластеризації, який ділить дані на k кластерів.
from sklearn.cluster import KMeans
import matplotlib.pyplot as plt

# Örnek veri seti oluştur
from sklearn.datasets import make_blobs
X, _ = make_blobs(n_samples=300, centers=4, random_state=42)

# Model oluştur ve eğit
kmeans = KMeans(n_clusters=4, random_state=42)
kmeans.fit(X)

# Tahmin yap ve kümeleri görselleştir
y_kmeans = kmeans.predict(X)

plt.scatter(X[:, 0], X[:, 1], c=y_kmeans, s=50, cmap='viridis')
centers = kmeans.cluster_centers_
plt.scatter(centers[:, 0], centers[:, 1], c='red', s=200, alpha=0.75)
plt.title('K-Means Clustering')
plt.show()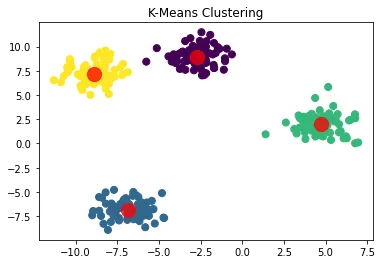
Метод головних компонент (PCA)
PCA — метод, що зводить багатовимірні дані до меншої кількості вимірів.
from sklearn.decomposition import PCA

# Model oluştur ve eğit
pca = PCA(n_components=2)
X_pca = pca.fit_transform(X)

plt.scatter(X_pca[:, 0], X_pca[:, 1], c=y_kmeans, s=50, cmap='viridis')
plt.title('PCA Visualization')
plt.show()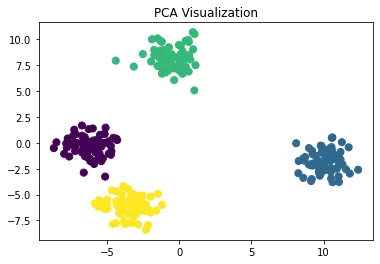
Підбір гіперпараметрів
Підбір гіперпараметрів — важливий крок, щоб отримати від моделі найкращий результат. Клас GridSearchCV бібліотеки Scikit-Learn значно його спрощує.
from sklearn.model_selection import GridSearchCV
from sklearn.svm import SVC

# Parametre uzayını tanımla
param_grid = {'C': [0.1, 1, 10], 'kernel': ['rbf', 'linear']}

# Grid search nesnesi oluştur
grid_search = GridSearchCV(SVC(), param_grid, cv=5)

# Grid search'ü uygula
grid_search.fit(X_train, y_train)

print("En iyi parametreler:", grid_search.best_params_)
print("En iyi skor:", grid_search.best_score_)
En iyi parametreler: {'C': 1, 'kernel': 'linear'}
En iyi skor: 0.9583333333333334(Підписи у виведенні турецькою, бо так їх друкує оригінальний код: «найкращі параметри» і «найкращий результат».)
Перехресна перевірка
Перехресна перевірка — важливий прийом, щоб виміряти, наскільки добре модель узагальнює знання на нові дані.
import numpy as np

# Örnek sayısını en küçük olan veri setine eşitleyin
min_samples = min(X.shape[0], y.shape[0])

# Rastgele örnekleme yapın
np.random.seed(42)  # Tekrarlanabilirlik için
indices = np.random.choice(X.shape[0], min_samples, replace=False)
X = X[indices]
y = y[:min_samples]  # y zaten daha küçük

print("New X shape:", X.shape)
print("New y shape:", y.shape)
New X shape: (150, 2)
New y shape: (150,)from sklearn.model_selection import cross_val_score
from sklearn.linear_model import LogisticRegression
# Lojistik regresyon modelini oluştur
log_reg = LogisticRegression()
# 5-fold cross-validation uygula
scores = cross_val_score(log_reg, X, y, cv=5)
print("Cross-validation skorları:", scores)
print("Ortalama skor:", scores.mean())Cross-validation skorları: [0.33333333 0.4 0.26666667 0.36666667 0.3 ]
Ortalama skor: 0.33333333333333337Виправлення: низькі оцінки тут спричинені попереднім кроком, а не моделлю. Код повторної вибірки випадково перемішує рядки X, але не перемішує так само мітки в y, тож мітки перестають відповідати рядкам, і модель опускається до рівня випадкового вгадування (близько 0,33 за трьох класів). Якщо пропустити цей крок або вибирати X і y за тими самими індексами, оцінки знову зростають. Метрики й результат конвеєра нижче низькі з тієї самої причини, бо використовують ті самі дані.
Відбір і конструювання ознак
Відбір і конструювання ознак відіграють ключову роль у якості моделі. Scikit-Learn має інструменти, що спрощують ці кроки.
from sklearn.feature_selection import SelectKBest, f_classif

# En iyi 2 özelliği seç
selector = SelectKBest(f_classif, k=2)
X_new = selector.fit_transform(X, y)

print("Seçilen özellikler:", selector.get_support())
Seçilen özellikler: [ True True]Інтерпретованість моделі
Особливо для таких моделей, як дерева рішень, важливо розуміти, як модель ухвалює рішення.
from sklearn.tree import plot_tree
import matplotlib.pyplot as plt

# Karar ağacını görselleştir
plt.figure(figsize=(20,10))
plot_tree(tree_model, feature_names=iris.feature_names, class_names=iris.target_names, filled=True)
plt.show()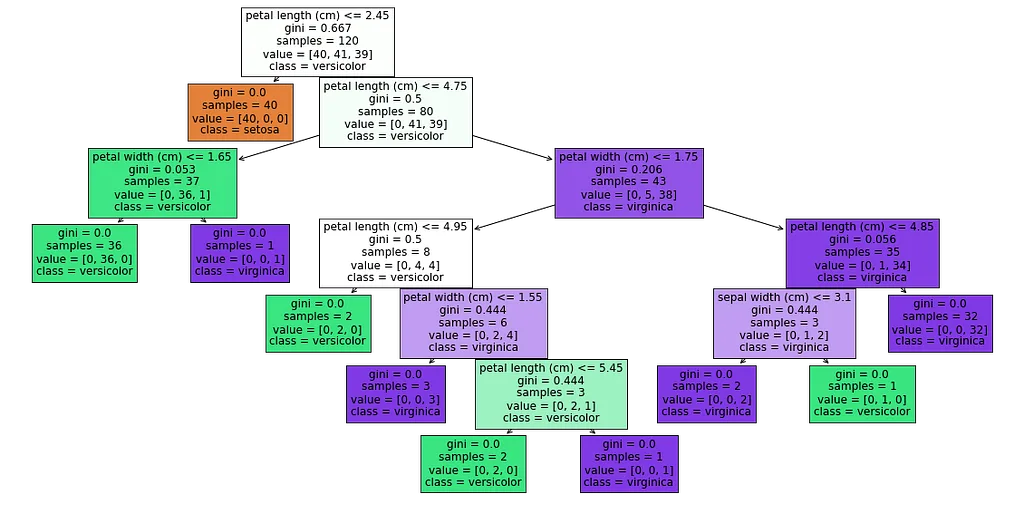
Схема показує дерево рішень класифікатора, навченого на наборі даних Iris. Кількома правилами дерево розділяє класи setosa, versicolor і virginica:
- Кореневий вузол: умова petal length ≤ 2.45 cm; Gini 0.667; 120 прикладів, розподіл [40, 41, 39]. Тут класи найбільше змішані.
- Лівий дочірній вузол: Gini 0.0; усі 40 прикладів — setosa. Одне правило повністю відокремлює setosa.
- Правий дочірній вузол (petal length > 2.45 cm): Gini 0.5; 80 прикладів, розподіл [0, 41, 39]. Versicolor і virginica ще змішані.
- Детальніший поділ: умова petal length ≤ 4.75 cm; Gini 0.206; 43 приклади, розподіл [0, 5, 38], переважно virginica.
- Нижні вузли: умова petal width ≤ 1.75 cm; Gini 0.0; усі 35 прикладів — virginica.
У кожному вузлі видно коефіцієнт Джині, кількість прикладів і розподіл класів, тож можна точно простежити, яку ознаку модель використовує на кожному етапі і як ухвалює рішення.
Ансамблеві методи
Ансамблеві методи поєднують кілька моделей, щоб отримувати надійніші прогнози. Random Forest — один із найпопулярніших.
from sklearn.ensemble import RandomForestClassifier

# Random Forest modeli oluştur ve eğit
rf_model = RandomForestClassifier(n_estimators=100, random_state=42)
rf_model.fit(X_train, y_train)

# Tahmin yap ve doğruluğu ölç
y_pred_rf = rf_model.predict(X_test)
accuracy_rf = accuracy_score(y_test, y_pred_rf)

print(f'Random Forest Model accuracy: {accuracy_rf}')
Random Forest Model accuracy: 1.0Метрики оцінювання
Крім точності, важливі й інші метрики оцінювання.
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import classification_report, confusion_matrix

# Veri setini ayır
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)

# Modeli eğit
log_reg = LogisticRegression()
log_reg.fit(X_train, y_train)

# Tahminler yap
y_pred_log = log_reg.predict(X_test)

# Sınıflandırma raporu oluştur
print(classification_report(y_test, y_pred_log, target_names=iris.target_names))

# Confusion matrix oluştur
cm = confusion_matrix(y_test, y_pred_log)
print("Confusion Matrix:\n", cm)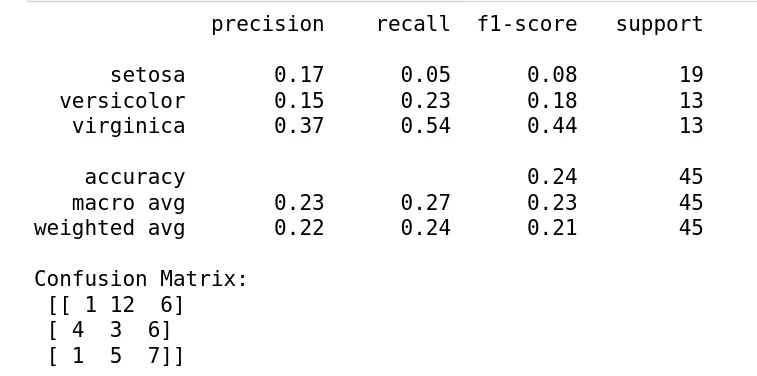
Ці результати показують якість моделі, навченої на даних, перемішаних вище:
- Влучність (precision), частка правильних серед позитивних прогнозів: setosa 17 %, versicolor 15 %, virginica 37 %.
- Повнота (recall), частка справді позитивних прикладів, які вдалося знайти: setosa 5 %, versicolor 23 %, virginica 54 %.
- F1-міра, гармонічне середнє влучності й повноти: setosa 0,08; versicolor 0,18; virginica 0,44.
- Загальна частка правильних відповідей: 24 %.
- Макросереднє: влучність 23 %, повнота 27 %, F1 23 %. Зважене середнє: влучність 22 %, повнота 24 %, F1 21 %.
У матриці помилок 1 приклад setosa передбачено правильно, 12 — як versicolor і 6 — як virginica; для versicolor 3 передбачено правильно, 4 — як setosa і 6 — як virginica; для virginica 7 правильно, 1 — як setosa і 5 — як versicolor.
Інтерпретація та поради
Загальна якість низька; найкращі результати — для virginica, але й вони недостатньо добрі. Як пояснює виправлення вище, головна причина — переплутані мітки. Крім того, якість зазвичай покращують такі кроки:
- Спробувати сильніші моделі, як-от Random Forest або SVM, і підібрати гіперпараметри
- Додати нові ознаки або перетворити наявні
- Збалансувати класи методами на кшталт SMOTE, якщо вони незбалансовані
- Використати перехресну перевірку, щоб виявити перенавчання чи недонавчання
Практичне застосування: сегментація клієнтів
Як практичний приклад розгляньмо сегментацію клієнтів компанії електронної комерції.
from sklearn.preprocessing import StandardScaler
from sklearn.cluster import KMeans

# Örnek veri oluştur (gerçek senaryoda bu veri müşteri veritabanından gelir)
customer_data = np.random.rand(1000, 3)  # 1000 müşteri, 3 özellik (örn: yaş, toplam harcama, ziyaret sıklığı)

# Veriyi ölçeklendir
scaler = StandardScaler()
customer_data_scaled = scaler.fit_transform(customer_data)

# K-Means uygula
kmeans = KMeans(n_clusters=4, random_state=42)
clusters = kmeans.fit_predict(customer_data_scaled)

print("Müşteri segmentleri:", np.unique(clusters))
Müşteri segmentleri: [0 1 2 3]Конвеєри у Scikit-Learn
Конвеєр (pipeline) поєднує кроки попередньої обробки й навчання моделі, роблячи код чистішим і ефективнішим.
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler

# Pipeline oluştur
pipeline = Pipeline([
    ('scaler', StandardScaler()),
    ('classifier', LogisticRegression())
])

# Pipeline'ı eğit ve değerlendir
pipeline.fit(X_train, y_train)
accuracy_pipeline = pipeline.score(X_test, y_test)

print(f'Pipeline Model accuracy: {accuracy_pipeline}')
Pipeline Model accuracy: 0.24444444444444444Розбір: класифікація на наборі Iris
У цьому розборі ми застосуємо кілька алгоритмів машинного навчання до набору Iris і порівняємо результати.
Підготовка даних
Спершу завантажимо набір даних і поділимо його на навчальну й тестову вибірки.
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split

# Veri setini yükle
iris = load_iris()
X = iris.data
y = iris.target

# Veriyi eğitim ve test olarak ayır
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
Застосування й порівняння алгоритмів
Тепер застосуємо логістичну регресію, дерево рішень і KNN і порівняємо результати.
from sklearn.linear_model import LogisticRegression
from sklearn.tree import DecisionTreeClassifier
from sklearn.neighbors import KNeighborsClassifier
from sklearn.metrics import accuracy_score

# Lojistik Regresyon
log_reg = LogisticRegression(max_iter=200)
log_reg.fit(X_train, y_train)
y_pred_log = log_reg.predict(X_test)
accuracy_log = accuracy_score(y_test, y_pred_log)

# Karar Ağaçları
tree_model = DecisionTreeClassifier(random_state=42)
tree_model.fit(X_train, y_train)
y_pred_tree = tree_model.predict(X_test)
accuracy_tree = accuracy_score(y_test, y_pred_tree)

# KNN
knn = KNeighborsClassifier(n_neighbors=3)
knn.fit(X_train, y_train)
y_pred_knn = knn.predict(X_test)
accuracy_knn = accuracy_score(y_test, y_pred_knn)

print(f'Logistic Regression accuracy: {accuracy_log}')
print(f'Decision Tree accuracy: {accuracy_tree}')
print(f'KNN accuracy: {accuracy_knn}')
Logistic Regression accuracy: 1.0
Decision Tree accuracy: 1.0
KNN accuracy: 1.0Висновок
У цій статті ми пройшли етапи процесу машинного навчання зі Scikit-Learn і побачили, як їх застосовувати. Ми використали алгоритми з учителем і без учителя на наборі Iris і, крім базових алгоритмів, розглянули оптимізацію, оцінювання й інтерпретацію, практичне застосування та конвеєри. Завдяки широкому набору інструментів Scikit-Learn допомагає фахівцям з аналізу даних і машинного навчання легше розв’язувати складні задачі.
Джерела
- Pedregosa, F. та ін. (2011). Scikit-learn: Machine Learning in Python. Journal of Machine Learning Research, 12, 2825–2830.
- Документація Scikit-Learn: scikit-learn.org
- Hastie, T., Tibshirani, R. і Friedman, J. (2009). The Elements of Statistical Learning. Springer.
- Kuhn, M. і Johnson, K. (2013). Applied Predictive Modeling. Springer.
- Géron, A. (2019). Hands-On Machine Learning with Scikit-Learn, Keras, and TensorFlow. O’Reilly Media.
- Müller, A. C. і Guido, S. (2016). Introduction to Machine Learning with Python. O’Reilly Media.
- Raschka, S. і Mirjalili, V. (2019). Python Machine Learning. Packt Publishing.
- VanderPlas, J. (2016). Python Data Science Handbook. O’Reilly Media.