

Python за анализу података: машинско учење уз Scikit-Learn
Аутор Yasin TANIŞ
Увод
Машинско учење је научна област која рачунарима омогућава да уче из података и праве предвиђања, и данас се користи у многим делатностима. У овом тексту разматрамо Scikit-Learn, једну од најкоришћенијих Python библиотека за израду апликација машинског учења.
Шта је Scikit-Learn
Scikit-Learn је библиотека за машинско учење која нуди једноставне и ефикасне алате за Python. Садржи алгоритме и за надгледано и за ненадгледано учење.
Инсталација
Пре почетка библиотеку треба инсталирати. Ако је немате на систему, инсталирајте је овом командом:
pip install scikit-learnНапомена: примери су намерно једноставни како би илустровали појмове; нису увек најбоља мера или метода за сваки сценарио.
Надгледано учење
Надгледано учење ради с означеним подацима: исходи (ознаке) примера су познати, па модел може да научи да их предвиђа.
Логистичка регресија
Логистичка регресија је често коришћен алгоритам за проблеме класификације.
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import accuracy_score
# Veri setini yükle
iris = load_iris()
X = iris.data
y = iris.target
# Veriyi eğitim ve test olarak ayır
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
# Model oluştur ve eğit
model = LogisticRegression(max_iter=200)
model.fit(X_train, y_train)
# Tahmin yap ve doğruluğu ölç
y_pred = model.predict(X_test)
accuracy = accuracy_score(y_test, y_pred)
print(f'Model accuracy: {accuracy}')
Model Accuracy : 1.0Овај код учитава скуп података Iris, дели га на обележја и циљ, обучава модел и исписује његову тачност.
Стабла одлучивања
Стабла одлучивања су моћан алгоритам и за класификацију и за регресију.
from sklearn.tree import DecisionTreeClassifier

# Model oluştur ve eğit
tree_model = DecisionTreeClassifier(random_state=42)
tree_model.fit(X_train, y_train)

# Tahmin yap ve doğruluğu ölç
y_pred_tree = tree_model.predict(X_test)
accuracy_tree = accuracy_score(y_test, y_pred_tree)

print(f'Decision Tree Model accuracy: {accuracy_tree}')
Decision Tree Model Accuracy: 1.0Ненадгледано учење
Ненадгледано учење не користи означене податке; модел сам покушава да научи структуру података.
Кластеровање K-Means
K-Means је чест алгоритам кластеровања који дели податке у k кластера.
from sklearn.cluster import KMeans
import matplotlib.pyplot as plt

# Örnek veri seti oluştur
from sklearn.datasets import make_blobs
X, _ = make_blobs(n_samples=300, centers=4, random_state=42)

# Model oluştur ve eğit
kmeans = KMeans(n_clusters=4, random_state=42)
kmeans.fit(X)

# Tahmin yap ve kümeleri görselleştir
y_kmeans = kmeans.predict(X)

plt.scatter(X[:, 0], X[:, 1], c=y_kmeans, s=50, cmap='viridis')
centers = kmeans.cluster_centers_
plt.scatter(centers[:, 0], centers[:, 1], c='red', s=200, alpha=0.75)
plt.title('K-Means Clustering')
plt.show()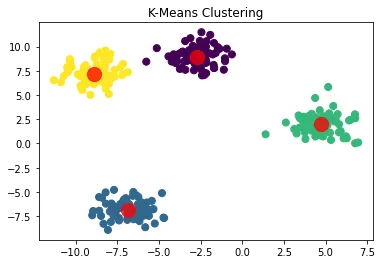
Анализа главних компоненти (PCA)
PCA је техника за свођење вишедимензионалних података на мањи број димензија.
from sklearn.decomposition import PCA

# Model oluştur ve eğit
pca = PCA(n_components=2)
X_pca = pca.fit_transform(X)

plt.scatter(X_pca[:, 0], X_pca[:, 1], c=y_kmeans, s=50, cmap='viridis')
plt.title('PCA Visualization')
plt.show()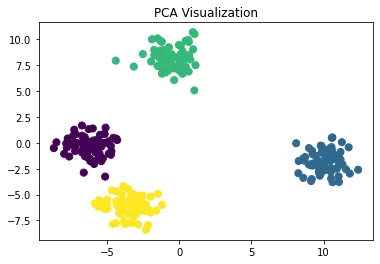
Подешавање хиперпараметара
Подешавање хиперпараметара важан је корак да би модел дао најбоље резултате. Класа GridSearchCV из Scikit-Learn-а то олакшава.
from sklearn.model_selection import GridSearchCV
from sklearn.svm import SVC

# Parametre uzayını tanımla
param_grid = {'C': [0.1, 1, 10], 'kernel': ['rbf', 'linear']}

# Grid search nesnesi oluştur
grid_search = GridSearchCV(SVC(), param_grid, cv=5)

# Grid search'ü uygula
grid_search.fit(X_train, y_train)

print("En iyi parametreler:", grid_search.best_params_)
print("En iyi skor:", grid_search.best_score_)
En iyi parametreler: {'C': 1, 'kernel': 'linear'}
En iyi skor: 0.9583333333333334(Ознаке у излазу су на турском јер их изворни код тако исписује: „најбољи параметри” и „најбољи резултат”.)
Унакрсна валидација
Унакрсна валидација је важна техника за мерење колико добро модел генерализује на нове податке.
import numpy as np

# Örnek sayısını en küçük olan veri setine eşitleyin
min_samples = min(X.shape[0], y.shape[0])

# Rastgele örnekleme yapın
np.random.seed(42)  # Tekrarlanabilirlik için
indices = np.random.choice(X.shape[0], min_samples, replace=False)
X = X[indices]
y = y[:min_samples]  # y zaten daha küçük

print("New X shape:", X.shape)
print("New y shape:", y.shape)
New X shape: (150, 2)
New y shape: (150,)from sklearn.model_selection import cross_val_score
from sklearn.linear_model import LogisticRegression
# Lojistik regresyon modelini oluştur
log_reg = LogisticRegression()
# 5-fold cross-validation uygula
scores = cross_val_score(log_reg, X, y, cv=5)
print("Cross-validation skorları:", scores)
print("Ortalama skor:", scores.mean())Cross-validation skorları: [0.33333333 0.4 0.26666667 0.36666667 0.3 ]
Ortalama skor: 0.33333333333333337Напомена о исправци: ниски резултати овде потичу из претходног корака, а не од модела. Код за поновно узорковање насумично меша редове у X, али ознаке у y не меша на исти начин, па ознаке више не одговарају редовима и модел пада на ниво случајности (око 0,33 код три класе). Ако се тај корак изостави или се X и y бирају истим индексима, резултати поново расту. Метрике и резултат pipeline-а испод ниски су из истог разлога, јер користе исте податке.
Избор и инжењеринг обележја
Избор и инжењеринг обележја имају кључну улогу у перформансама модела. Scikit-Learn нуди алате који олакшавају те кораке.
from sklearn.feature_selection import SelectKBest, f_classif

# En iyi 2 özelliği seç
selector = SelectKBest(f_classif, k=2)
X_new = selector.fit_transform(X, y)

print("Seçilen özellikler:", selector.get_support())
Seçilen özellikler: [ True True]Тумачење модела
Нарочито код модела као што су стабла одлучивања важно је разумети како модел доноси одлуке.
from sklearn.tree import plot_tree
import matplotlib.pyplot as plt

# Karar ağacını görselleştir
plt.figure(figsize=(20,10))
plot_tree(tree_model, feature_names=iris.feature_names, class_names=iris.target_names, filled=True)
plt.show()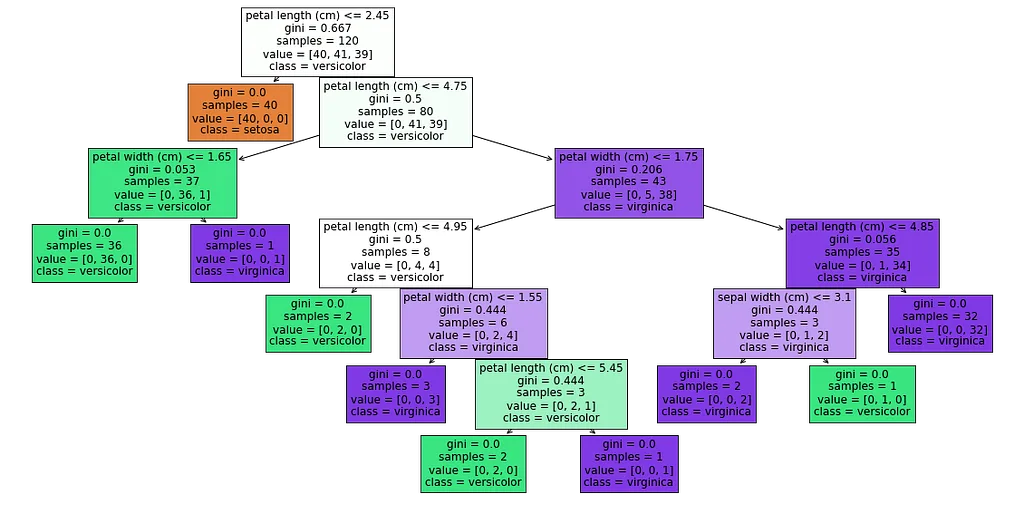
Графикон приказује стабло одлучивања класификатора обученог на скупу Iris. Стабло помоћу неколико правила раздваја класе setosa, versicolor и virginica:
- Коренски чвор: услов petal length ≤ 2,45 cm; Gini 0,667; 120 примера, расподела [40, 41, 39]. Овде су класе највише измешане.
- Леви чвор: Gini 0,0; свих 40 примера припада класи setosa. Једно правило потпуно издваја класу setosa.
- Десни чвор (petal length > 2,45 cm): Gini 0,5; 80 примера, расподела [0, 41, 39]. Versicolor и virginica су и даље измешане.
- Финија подела: услов petal length ≤ 4,75 cm; Gini 0,206; 43 примера, расподела [0, 5, 38], већином virginica.
- Нижи чворови: услов petal width ≤ 1,75 cm; Gini 0,0; свих 35 примера припада класи virginica.
Сваки чвор приказује Gini коефицијент, број примера и расподелу класа, па се тачно види које обележје модел користи у којој тачки и како одлучује.
Ансамбл методе
Ансамбл методе комбинују више модела да би дале јача предвиђања. Random Forest је једна од најпопуларнијих.
from sklearn.ensemble import RandomForestClassifier

# Random Forest modeli oluştur ve eğit
rf_model = RandomForestClassifier(n_estimators=100, random_state=42)
rf_model.fit(X_train, y_train)

# Tahmin yap ve doğruluğu ölç
y_pred_rf = rf_model.predict(X_test)
accuracy_rf = accuracy_score(y_test, y_pred_rf)

print(f'Random Forest Model accuracy: {accuracy_rf}')
Random Forest Model accuracy: 1.0Метрике вредновања
Осим тачности, важне су и друге метрике вредновања.
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import classification_report, confusion_matrix

# Veri setini ayır
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)

# Modeli eğit
log_reg = LogisticRegression()
log_reg.fit(X_train, y_train)

# Tahminler yap
y_pred_log = log_reg.predict(X_test)

# Sınıflandırma raporu oluştur
print(classification_report(y_test, y_pred_log, target_names=iris.target_names))

# Confusion matrix oluştur
cm = confusion_matrix(y_test, y_pred_log)
print("Confusion Matrix:\n", cm)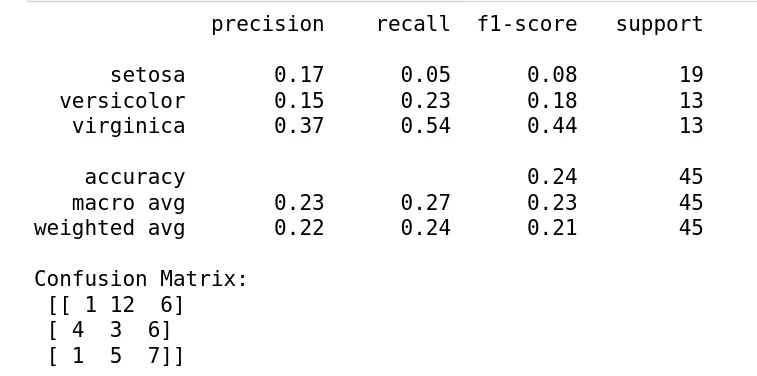
Ови резултати показују перформансе модела обученог на измешаним подацима из претходног одељка:
- Прецизност, удео тачних међу позитивним предвиђањима: setosa 17 %, versicolor 15 %, virginica 37 %.
- Одзив, удео пронађених међу стварно позитивним примерима: setosa 5 %, versicolor 23 %, virginica 54 %.
- F1 мера, хармонијска средина прецизности и одзива: setosa 0,08, versicolor 0,18, virginica 0,44.
- Укупна тачност: 24 %.
- Макро просек: прецизност 23 %, одзив 27 %, F1 23 %. Пондерисани просек: прецизност 22 %, одзив 24 %, F1 21 %.
У матрици конфузије 1 пример класе setosa предвиђен је тачно, 12 као versicolor и 6 као virginica; код versicolor 3 тачно, 4 као setosa и 6 као virginica; код virginica 7 тачно, 1 као setosa и 5 као versicolor.
Тумачење и предлози
Укупне перформансе су ниске; најбоља је virginica, али ни она није довољно добра. Као што објашњава напомена о исправци, главни узрок су измешане ознаке. Осим тога, ови кораци углавном побољшавају перформансе:
- Испробати јаче моделе као што су Random Forest или SVM и подесити хиперпараметре
- Додати нова обележја или трансформисати постојећа
- Уравнотежити класе методама као што је SMOTE ако су неуравнотежене
- Користити унакрсну валидацију како би се уочило преприлагођавање (overfitting) или потприлагођавање (underfitting)
Примена у пракси: сегментација купаца
Као примену у пракси узмимо сегментацију купаца једне компаније за е-трговину.
from sklearn.preprocessing import StandardScaler
from sklearn.cluster import KMeans

# Örnek veri oluştur (gerçek senaryoda bu veri müşteri veritabanından gelir)
customer_data = np.random.rand(1000, 3)  # 1000 müşteri, 3 özellik (örn: yaş, toplam harcama, ziyaret sıklığı)

# Veriyi ölçeklendir
scaler = StandardScaler()
customer_data_scaled = scaler.fit_transform(customer_data)

# K-Means uygula
kmeans = KMeans(n_clusters=4, random_state=42)
clusters = kmeans.fit_predict(customer_data_scaled)

print("Müşteri segmentleri:", np.unique(clusters))
Müşteri segmentleri: [0 1 2 3]Pipeline у Scikit-Learn-у
Pipeline повезује кораке предобраде и обуке модела, па је код чистији и ефикаснији.
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler

# Pipeline oluştur
pipeline = Pipeline([
    ('scaler', StandardScaler()),
    ('classifier', LogisticRegression())
])

# Pipeline'ı eğit ve değerlendir
pipeline.fit(X_train, y_train)
accuracy_pipeline = pipeline.score(X_test, y_test)

print(f'Pipeline Model accuracy: {accuracy_pipeline}')
Pipeline Model accuracy: 0.24444444444444444Студија случаја: класификација на скупу Iris
У овој студији примењујемо више алгоритама машинског учења на скуп Iris и поредимо резултате.
Припрема података
Прво учитавамо скуп података и делимо га на скуп за обуку и скуп за тестирање.
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split

# Veri setini yükle
iris = load_iris()
X = iris.data
y = iris.target

# Veriyi eğitim ve test olarak ayır
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
Примена и поређење алгоритама
Сада примењујемо логистичку регресију, стабло одлучивања и KNN и поредимо резултате.
from sklearn.linear_model import LogisticRegression
from sklearn.tree import DecisionTreeClassifier
from sklearn.neighbors import KNeighborsClassifier
from sklearn.metrics import accuracy_score

# Lojistik Regresyon
log_reg = LogisticRegression(max_iter=200)
log_reg.fit(X_train, y_train)
y_pred_log = log_reg.predict(X_test)
accuracy_log = accuracy_score(y_test, y_pred_log)

# Karar Ağaçları
tree_model = DecisionTreeClassifier(random_state=42)
tree_model.fit(X_train, y_train)
y_pred_tree = tree_model.predict(X_test)
accuracy_tree = accuracy_score(y_test, y_pred_tree)

# KNN
knn = KNeighborsClassifier(n_neighbors=3)
knn.fit(X_train, y_train)
y_pred_knn = knn.predict(X_test)
accuracy_knn = accuracy_score(y_test, y_pred_knn)

print(f'Logistic Regression accuracy: {accuracy_log}')
print(f'Decision Tree accuracy: {accuracy_tree}')
print(f'KNN accuracy: {accuracy_knn}')
Logistic Regression accuracy: 1.0
Decision Tree accuracy: 1.0
KNN accuracy: 1.0Закључак
У овом тексту прошли смо кроз фазе процеса машинског учења уз Scikit-Learn и видели како се примењују. Надгледане и ненадгледане алгоритме применили смо на скуп Iris, а поред основних алгоритама обрадили смо оптимизацију, вредновање и тумачење, примену у пракси и pipeline. Захваљујући широком скупу алата, Scikit-Learn стручњацима за науку о подацима и практичарима машинског учења олакшава решавање сложених проблема.
Извори
- Pedregosa, F. и др. (2011). Scikit-learn: Machine Learning in Python. Journal of Machine Learning Research, 12, 2825–2830.
- Документација Scikit-Learn-а: scikit-learn.org
- Hastie, T., Tibshirani, R. и Friedman, J. (2009). The Elements of Statistical Learning. Springer.
- Kuhn, M. и Johnson, K. (2013). Applied Predictive Modeling. Springer.
- Géron, A. (2019). Hands-On Machine Learning with Scikit-Learn, Keras, and TensorFlow. O’Reilly Media.
- Müller, A. C. и Guido, S. (2016). Introduction to Machine Learning with Python. O’Reilly Media.
- Raschka, S. и Mirjalili, V. (2019). Python Machine Learning. Packt Publishing.
- VanderPlas, J. (2016). Python Data Science Handbook. O’Reilly Media.