

Python για ανάλυση δεδομένων: μηχανική μάθηση με το Scikit-Learn
Γράφει Yasin TANIŞ
Εισαγωγή
Η μηχανική μάθηση είναι ο επιστημονικός κλάδος που επιτρέπει στους υπολογιστές να μαθαίνουν από δεδομένα και να κάνουν προβλέψεις, και σήμερα χρησιμοποιείται σε πολλούς κλάδους. Σε αυτό το άρθρο εξετάζουμε το Scikit-Learn, μία από τις πιο διαδεδομένες βιβλιοθήκες της Python για τη δημιουργία εφαρμογών μηχανικής μάθησης.
Τι είναι το Scikit-Learn
Το Scikit-Learn είναι μια βιβλιοθήκη μηχανικής μάθησης που προσφέρει απλά και αποδοτικά εργαλεία για την Python. Περιλαμβάνει αλγορίθμους τόσο επιβλεπόμενης όσο και μη επιβλεπόμενης μάθησης.
Εγκατάσταση
Πριν ξεκινήσουμε, πρέπει να εγκαταστήσουμε τη βιβλιοθήκη. Αν δεν υπάρχει ακόμη στο σύστημά σας, εγκαταστήστε τη με αυτή την εντολή:
pip install scikit-learnΣημείωση: τα παραδείγματα εδώ είναι σκόπιμα απλά, για να δείξουν τις έννοιες· δεν αποτελούν πάντα την καλύτερη μετρική ή μέθοδο για κάθε σενάριο.
Επιβλεπόμενη μάθηση
Η επιβλεπόμενη μάθηση δουλεύει με επισημασμένα δεδομένα: τα αποτελέσματα (ετικέτες) των παραδειγμάτων είναι γνωστά, οπότε το μοντέλο μπορεί να μάθει να τα προβλέπει.
Λογιστική παλινδρόμηση
Η λογιστική παλινδρόμηση είναι ένας ευρέως χρησιμοποιούμενος αλγόριθμος για προβλήματα ταξινόμησης.
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import accuracy_score
# Veri setini yükle
iris = load_iris()
X = iris.data
y = iris.target
# Veriyi eğitim ve test olarak ayır
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
# Model oluştur ve eğit
model = LogisticRegression(max_iter=200)
model.fit(X_train, y_train)
# Tahmin yap ve doğruluğu ölç
y_pred = model.predict(X_test)
accuracy = accuracy_score(y_test, y_pred)
print(f'Model accuracy: {accuracy}')
Model Accuracy : 1.0Ο κώδικας αυτός φορτώνει το σύνολο δεδομένων Iris, το χωρίζει σε χαρακτηριστικά και στόχο, εκπαιδεύει το μοντέλο και τυπώνει την ακρίβειά του.
Δέντρα αποφάσεων
Τα δέντρα αποφάσεων είναι ένας ισχυρός αλγόριθμος τόσο για ταξινόμηση όσο και για παλινδρόμηση.
from sklearn.tree import DecisionTreeClassifier

# Model oluştur ve eğit
tree_model = DecisionTreeClassifier(random_state=42)
tree_model.fit(X_train, y_train)

# Tahmin yap ve doğruluğu ölç
y_pred_tree = tree_model.predict(X_test)
accuracy_tree = accuracy_score(y_test, y_pred_tree)

print(f'Decision Tree Model accuracy: {accuracy_tree}')
Decision Tree Model Accuracy: 1.0Μη επιβλεπόμενη μάθηση
Η μη επιβλεπόμενη μάθηση δεν χρησιμοποιεί επισημασμένα δεδομένα· το μοντέλο προσπαθεί να μάθει τη δομή των ίδιων των δεδομένων.
Συσταδοποίηση K-Means
Ο K-Means είναι ένας διαδεδομένος αλγόριθμος συσταδοποίησης που χωρίζει τα δεδομένα σε k συστάδες.
from sklearn.cluster import KMeans
import matplotlib.pyplot as plt

# Örnek veri seti oluştur
from sklearn.datasets import make_blobs
X, _ = make_blobs(n_samples=300, centers=4, random_state=42)

# Model oluştur ve eğit
kmeans = KMeans(n_clusters=4, random_state=42)
kmeans.fit(X)

# Tahmin yap ve kümeleri görselleştir
y_kmeans = kmeans.predict(X)

plt.scatter(X[:, 0], X[:, 1], c=y_kmeans, s=50, cmap='viridis')
centers = kmeans.cluster_centers_
plt.scatter(centers[:, 0], centers[:, 1], c='red', s=200, alpha=0.75)
plt.title('K-Means Clustering')
plt.show()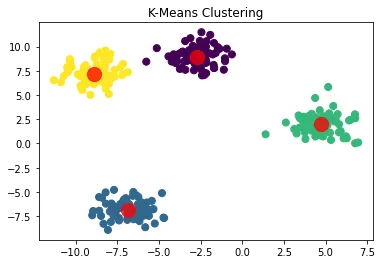
Ανάλυση κύριων συνιστωσών (PCA)
Η PCA είναι μια τεχνική για τη μείωση δεδομένων υψηλής διάστασης σε λιγότερες διαστάσεις.
from sklearn.decomposition import PCA

# Model oluştur ve eğit
pca = PCA(n_components=2)
X_pca = pca.fit_transform(X)

plt.scatter(X_pca[:, 0], X_pca[:, 1], c=y_kmeans, s=50, cmap='viridis')
plt.title('PCA Visualization')
plt.show()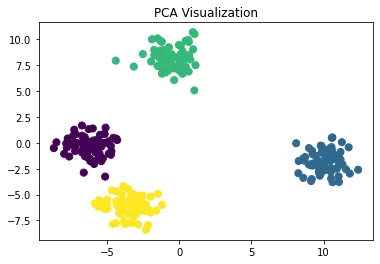
Ρύθμιση υπερπαραμέτρων
Η ρύθμιση υπερπαραμέτρων είναι σημαντικό βήμα για να επιτύχει ένα μοντέλο την καλύτερη δυνατή απόδοση. Η κλάση GridSearchCV του Scikit-Learn τη διευκολύνει.
from sklearn.model_selection import GridSearchCV
from sklearn.svm import SVC

# Parametre uzayını tanımla
param_grid = {'C': [0.1, 1, 10], 'kernel': ['rbf', 'linear']}

# Grid search nesnesi oluştur
grid_search = GridSearchCV(SVC(), param_grid, cv=5)

# Grid search'ü uygula
grid_search.fit(X_train, y_train)

print("En iyi parametreler:", grid_search.best_params_)
print("En iyi skor:", grid_search.best_score_)
En iyi parametreler: {'C': 1, 'kernel': 'linear'}
En iyi skor: 0.9583333333333334(Οι ετικέτες της εξόδου είναι στα τουρκικά, επειδή έτσι τις τυπώνει ο αρχικός κώδικας: «καλύτερες παράμετροι» και «καλύτερο σκορ».)
Διασταυρωμένη επικύρωση
Η διασταυρωμένη επικύρωση είναι μια σημαντική τεχνική για να μετρήσουμε πόσο καλά γενικεύει το μοντέλο σε νέα δεδομένα.
import numpy as np

# Örnek sayısını en küçük olan veri setine eşitleyin
min_samples = min(X.shape[0], y.shape[0])

# Rastgele örnekleme yapın
np.random.seed(42)  # Tekrarlanabilirlik için
indices = np.random.choice(X.shape[0], min_samples, replace=False)
X = X[indices]
y = y[:min_samples]  # y zaten daha küçük

print("New X shape:", X.shape)
print("New y shape:", y.shape)
New X shape: (150, 2)
New y shape: (150,)from sklearn.model_selection import cross_val_score
from sklearn.linear_model import LogisticRegression
# Lojistik regresyon modelini oluştur
log_reg = LogisticRegression()
# 5-fold cross-validation uygula
scores = cross_val_score(log_reg, X, y, cv=5)
print("Cross-validation skorları:", scores)
print("Ortalama skor:", scores.mean())Cross-validation skorları: [0.33333333 0.4 0.26666667 0.36666667 0.3 ]
Ortalama skor: 0.33333333333333337Σημείωση διόρθωσης: τα χαμηλά σκορ εδώ προέρχονται από το προηγούμενο βήμα, όχι από το μοντέλο. Ο κώδικας επαναδειγματοληψίας ανακατεύει τυχαία τις γραμμές του X, αλλά δεν ανακατεύει με τον ίδιο τρόπο τις ετικέτες του y, οπότε οι ετικέτες δεν αντιστοιχούν πια στις γραμμές και το μοντέλο πέφτει στο επίπεδο της τύχης (περίπου 0,33 με τρεις κλάσεις). Αν παραλείψετε αυτό το βήμα ή επιλέξετε τα X και y με τους ίδιους δείκτες, τα σκορ ανεβαίνουν ξανά. Οι μετρικές και τα αποτελέσματα του pipeline παρακάτω είναι χαμηλά για τον ίδιο λόγο, αφού χρησιμοποιούν τα ίδια δεδομένα.
Επιλογή και μηχανική χαρακτηριστικών
Η επιλογή και η μηχανική χαρακτηριστικών παίζουν καθοριστικό ρόλο στην απόδοση του μοντέλου. Το Scikit-Learn προσφέρει εργαλεία που διευκολύνουν αυτά τα βήματα.
from sklearn.feature_selection import SelectKBest, f_classif

# En iyi 2 özelliği seç
selector = SelectKBest(f_classif, k=2)
X_new = selector.fit_transform(X, y)

print("Seçilen özellikler:", selector.get_support())
Seçilen özellikler: [ True True]Ερμηνευσιμότητα του μοντέλου
Ιδίως σε μοντέλα όπως τα δέντρα αποφάσεων, είναι σημαντικό να κατανοούμε πώς καταλήγει το μοντέλο στις αποφάσεις του.
from sklearn.tree import plot_tree
import matplotlib.pyplot as plt

# Karar ağacını görselleştir
plt.figure(figsize=(20,10))
plot_tree(tree_model, feature_names=iris.feature_names, class_names=iris.target_names, filled=True)
plt.show()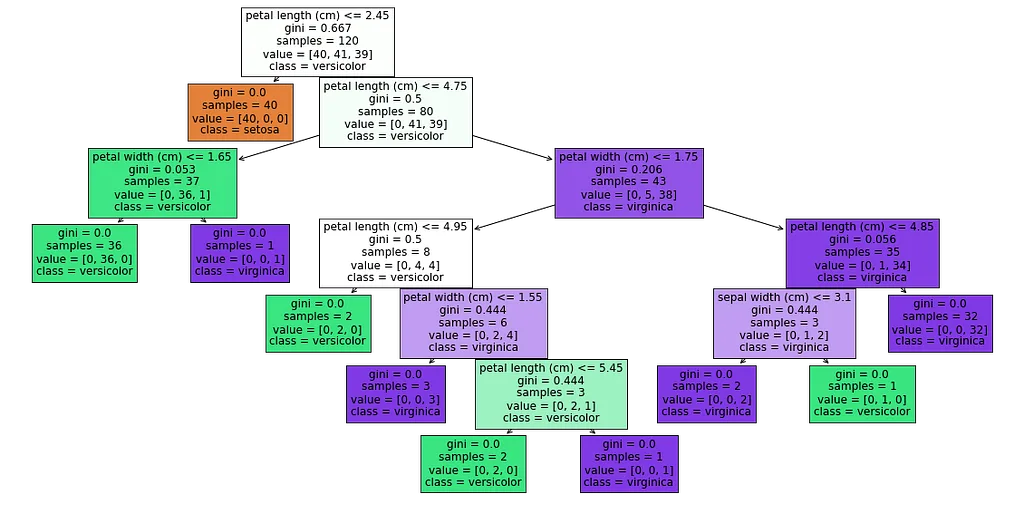
Το διάγραμμα δείχνει το δέντρο αποφάσεων ενός ταξινομητή εκπαιδευμένου στο σύνολο δεδομένων Iris. Με λίγους κανόνες, το δέντρο διαχωρίζει τις κλάσεις setosa, versicolor και virginica:
- Κόμβος ρίζας: συνθήκη petal length ≤ 2,45 cm· Gini 0,667· 120 δείγματα, κατανομή [40, 41, 39]. Εδώ οι κλάσεις είναι περισσότερο ανακατεμένες από οπουδήποτε αλλού.
- Αριστερός θυγατρικός κόμβος: Gini 0,0· και τα 40 δείγματα είναι setosa. Ένας μόνο κανόνας ξεχωρίζει πλήρως τη setosa.
- Δεξιός θυγατρικός κόμβος (petal length > 2,45 cm): Gini 0,5· 80 δείγματα, κατανομή [0, 41, 39]. Η versicolor και η virginica είναι ακόμη ανακατεμένες.
- Λεπτότερος διαχωρισμός: συνθήκη petal length ≤ 4,75 cm· Gini 0,206· 43 δείγματα, κατανομή [0, 5, 38], κυρίως virginica.
- Χαμηλότεροι κόμβοι: συνθήκη petal width ≤ 1,75 cm· Gini 0,0· και τα 35 δείγματα είναι virginica.
Κάθε κόμβος δείχνει τον συντελεστή Gini, τον αριθμό δειγμάτων και την κατανομή των κλάσεων, ώστε να μπορείτε να παρακολουθήσετε ακριβώς ποιο χαρακτηριστικό χρησιμοποιεί το μοντέλο σε κάθε σημείο και πώς αποφασίζει.
Συνδυαστικές μέθοδοι
Οι συνδυαστικές (ensemble) μέθοδοι συνδυάζουν πολλά μοντέλα για να κάνουν ισχυρότερες προβλέψεις. Το Random Forest είναι μία από τις πιο δημοφιλείς.
from sklearn.ensemble import RandomForestClassifier

# Random Forest modeli oluştur ve eğit
rf_model = RandomForestClassifier(n_estimators=100, random_state=42)
rf_model.fit(X_train, y_train)

# Tahmin yap ve doğruluğu ölç
y_pred_rf = rf_model.predict(X_test)
accuracy_rf = accuracy_score(y_test, y_pred_rf)

print(f'Random Forest Model accuracy: {accuracy_rf}')
Random Forest Model accuracy: 1.0Μετρικές αξιολόγησης
Πέρα από την ακρίβεια, σημασία έχουν και άλλες μετρικές αξιολόγησης.
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import classification_report, confusion_matrix

# Veri setini ayır
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)

# Modeli eğit
log_reg = LogisticRegression()
log_reg.fit(X_train, y_train)

# Tahminler yap
y_pred_log = log_reg.predict(X_test)

# Sınıflandırma raporu oluştur
print(classification_report(y_test, y_pred_log, target_names=iris.target_names))

# Confusion matrix oluştur
cm = confusion_matrix(y_test, y_pred_log)
print("Confusion Matrix:\n", cm)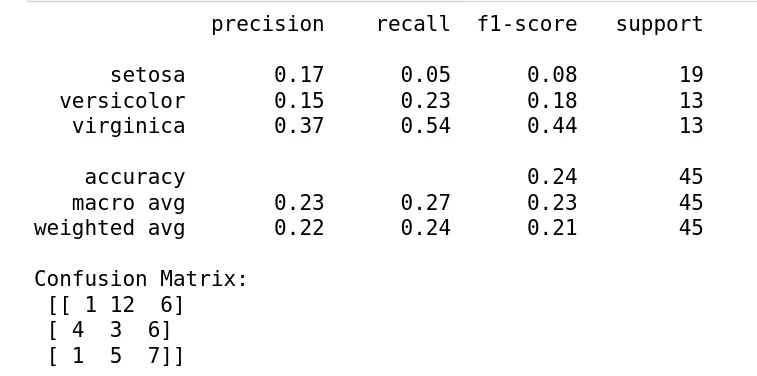
Τα αποτελέσματα αυτά δείχνουν την απόδοση ενός μοντέλου εκπαιδευμένου στα ανακατεμένα δεδομένα που είδαμε παραπάνω:
- Precision, δηλαδή το ποσοστό των θετικών προβλέψεων που είναι σωστές: setosa 17 %, versicolor 15 %, virginica 37 %.
- Ανάκληση (recall), δηλαδή το ποσοστό των πραγματικά θετικών που εντοπίζονται: setosa 5 %, versicolor 23 %, virginica 54 %.
- Σκορ F1, δηλαδή ο αρμονικός μέσος της precision και της ανάκλησης: setosa 0,08, versicolor 0,18, virginica 0,44.
- Συνολική ακρίβεια (accuracy): 24 %.
- Μακρομέσος όρος (macro average): precision 23 %, recall 27 %, F1 23 %. Σταθμισμένος μέσος όρος (weighted average): precision 22 %, recall 24 %, F1 21 %.
Στον πίνακα σύγχυσης, 1 δείγμα setosa προβλέπεται σωστά, 12 ως versicolor και 6 ως virginica· για τη versicolor, 3 σωστά, 4 ως setosa και 6 ως virginica· για τη virginica, 7 σωστά, 1 ως setosa και 5 ως versicolor.
Ερμηνεία και προτάσεις
Η συνολική απόδοση είναι χαμηλή· καλύτερα τα πάει η virginica, αλλά και πάλι όχι αρκετά καλά. Όπως εξηγεί η παραπάνω σημείωση διόρθωσης, η κύρια αιτία είναι οι ανακατεμένες ετικέτες. Πέρα από αυτό, τα εξής βήματα γενικά βελτιώνουν την απόδοση:
- Δοκιμή ισχυρότερων μοντέλων, όπως το Random Forest ή το SVM, και ρύθμιση των υπερπαραμέτρων τους
- Προσθήκη νέων χαρακτηριστικών ή μετασχηματισμός των υπαρχόντων
- Εξισορρόπηση των κλάσεων με μεθόδους όπως το SMOTE, αν δεν είναι ισορροπημένες
- Χρήση διασταυρωμένης επικύρωσης για τον εντοπισμό υπερπροσαρμογής ή υποπροσαρμογής
Μια πραγματική εφαρμογή: τμηματοποίηση πελατών
Ως εφαρμογή από τον πραγματικό κόσμο, ας εξετάσουμε την τμηματοποίηση πελατών μιας εταιρείας ηλεκτρονικού εμπορίου.
from sklearn.preprocessing import StandardScaler
from sklearn.cluster import KMeans

# Örnek veri oluştur (gerçek senaryoda bu veri müşteri veritabanından gelir)
customer_data = np.random.rand(1000, 3)  # 1000 müşteri, 3 özellik (örn: yaş, toplam harcama, ziyaret sıklığı)

# Veriyi ölçeklendir
scaler = StandardScaler()
customer_data_scaled = scaler.fit_transform(customer_data)

# K-Means uygula
kmeans = KMeans(n_clusters=4, random_state=42)
clusters = kmeans.fit_predict(customer_data_scaled)

print("Müşteri segmentleri:", np.unique(clusters))
Müşteri segmentleri: [0 1 2 3]Pipeline στο Scikit-Learn
Ένα pipeline συνδέει αλυσιδωτά τα βήματα προεπεξεργασίας και εκπαίδευσης του μοντέλου, κάνοντας τον κώδικα πιο καθαρό και πιο αποδοτικό.
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler

# Pipeline oluştur
pipeline = Pipeline([
    ('scaler', StandardScaler()),
    ('classifier', LogisticRegression())
])

# Pipeline'ı eğit ve değerlendir
pipeline.fit(X_train, y_train)
accuracy_pipeline = pipeline.score(X_test, y_test)

print(f'Pipeline Model accuracy: {accuracy_pipeline}')
Pipeline Model accuracy: 0.24444444444444444Μελέτη περίπτωσης: ταξινόμηση με το σύνολο δεδομένων Iris
Σε αυτή τη μελέτη περίπτωσης εφαρμόζουμε διάφορους αλγορίθμους μηχανικής μάθησης στο σύνολο δεδομένων Iris και συγκρίνουμε τα αποτελέσματα.
Προετοιμασία των δεδομένων
Πρώτα φορτώνουμε το σύνολο δεδομένων και το χωρίζουμε σε σύνολα εκπαίδευσης και ελέγχου.
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split

# Veri setini yükle
iris = load_iris()
X = iris.data
y = iris.target

# Veriyi eğitim ve test olarak ayır
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
Εφαρμογή και σύγκριση των αλγορίθμων
Τώρα εφαρμόζουμε τη λογιστική παλινδρόμηση, ένα δέντρο αποφάσεων και τον KNN και συγκρίνουμε τα αποτελέσματά τους.
from sklearn.linear_model import LogisticRegression
from sklearn.tree import DecisionTreeClassifier
from sklearn.neighbors import KNeighborsClassifier
from sklearn.metrics import accuracy_score

# Lojistik Regresyon
log_reg = LogisticRegression(max_iter=200)
log_reg.fit(X_train, y_train)
y_pred_log = log_reg.predict(X_test)
accuracy_log = accuracy_score(y_test, y_pred_log)

# Karar Ağaçları
tree_model = DecisionTreeClassifier(random_state=42)
tree_model.fit(X_train, y_train)
y_pred_tree = tree_model.predict(X_test)
accuracy_tree = accuracy_score(y_test, y_pred_tree)

# KNN
knn = KNeighborsClassifier(n_neighbors=3)
knn.fit(X_train, y_train)
y_pred_knn = knn.predict(X_test)
accuracy_knn = accuracy_score(y_test, y_pred_knn)

print(f'Logistic Regression accuracy: {accuracy_log}')
print(f'Decision Tree accuracy: {accuracy_tree}')
print(f'KNN accuracy: {accuracy_knn}')
Logistic Regression accuracy: 1.0
Decision Tree accuracy: 1.0
KNN accuracy: 1.0Συμπέρασμα
Σε αυτό το άρθρο περάσαμε από τα στάδια μιας διαδικασίας μηχανικής μάθησης με το Scikit-Learn και είδαμε πώς εφαρμόζονται. Εφαρμόσαμε επιβλεπόμενους και μη επιβλεπόμενους αλγορίθμους στο σύνολο δεδομένων Iris και, πέρα από τους βασικούς αλγορίθμους, καλύψαμε τη βελτιστοποίηση, την αξιολόγηση και την ερμηνεία, μια πραγματική εφαρμογή και τα pipeline. Με το ευρύ φάσμα εργαλείων του, το Scikit-Learn διευκολύνει την επίλυση σύνθετων προβλημάτων για τους επιστήμονες δεδομένων και τους επαγγελματίες της μηχανικής μάθησης.
Πηγές
- Pedregosa, F. κ.ά. (2011). Scikit-learn: Machine Learning in Python. Journal of Machine Learning Research, 12, 2825–2830.
- Τεκμηρίωση του Scikit-Learn: scikit-learn.org
- Hastie, T., Tibshirani, R. και Friedman, J. (2009). The Elements of Statistical Learning. Springer.
- Kuhn, M. και Johnson, K. (2013). Applied Predictive Modeling. Springer.
- Géron, A. (2019). Hands-On Machine Learning with Scikit-Learn, Keras, and TensorFlow. O’Reilly Media.
- Müller, A. C. και Guido, S. (2016). Introduction to Machine Learning with Python. O’Reilly Media.
- Raschka, S. και Mirjalili, V. (2019). Python Machine Learning. Packt Publishing.
- VanderPlas, J. (2016). Python Data Science Handbook. O’Reilly Media.