

Python pour l’analyse de données : apprentissage automatique avec Scikit-Learn
Par Yasin TANIŞ
Introduction
L’apprentissage automatique est la discipline qui permet aux ordinateurs d’apprendre à partir de données et de faire des prédictions ; il est utilisé aujourd’hui dans de nombreux secteurs. Dans cet article, nous découvrons Scikit-Learn, l’une des bibliothèques Python les plus utilisées pour développer des applications d’apprentissage automatique.
Qu’est-ce que Scikit-Learn ?
Scikit-Learn est une bibliothèque d’apprentissage automatique qui offre des outils simples et efficaces pour Python. Elle comprend des algorithmes d’apprentissage supervisé et non supervisé.
Installation
Avant de commencer, il faut installer la bibliothèque. Si elle n’est pas encore installée sur votre système, installez-la avec cette commande :
pip install scikit-learnRemarque : les exemples présentés ici sont volontairement simples afin d’illustrer les notions ; ils ne constituent pas toujours la meilleure métrique ou la meilleure méthode pour chaque scénario.
Apprentissage supervisé
L’apprentissage supervisé s’appuie sur des données étiquetées : les résultats (étiquettes) des exemples sont connus, ce qui permet au modèle d’apprendre à les prédire.
Régression logistique
La régression logistique est un algorithme très utilisé pour les problèmes de classification.
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import accuracy_score
# Veri setini yükle
iris = load_iris()
X = iris.data
y = iris.target
# Veriyi eğitim ve test olarak ayır
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
# Model oluştur ve eğit
model = LogisticRegression(max_iter=200)
model.fit(X_train, y_train)
# Tahmin yap ve doğruluğu ölç
y_pred = model.predict(X_test)
accuracy = accuracy_score(y_test, y_pred)
print(f'Model accuracy: {accuracy}')
Model Accuracy : 1.0Ce code charge le jeu de données Iris, le sépare en variables explicatives et en variable cible, entraîne le modèle et affiche son exactitude.
Arbres de décision
Les arbres de décision sont un algorithme puissant, utilisable en classification comme en régression.
from sklearn.tree import DecisionTreeClassifier

# Model oluştur ve eğit
tree_model = DecisionTreeClassifier(random_state=42)
tree_model.fit(X_train, y_train)

# Tahmin yap ve doğruluğu ölç
y_pred_tree = tree_model.predict(X_test)
accuracy_tree = accuracy_score(y_test, y_pred_tree)

print(f'Decision Tree Model accuracy: {accuracy_tree}')
Decision Tree Model Accuracy: 1.0Apprentissage non supervisé
L’apprentissage non supervisé n’utilise pas de données étiquetées ; le modèle cherche à apprendre par lui-même la structure des données.
Clustering K-Means
K-Means est un algorithme de clustering courant qui répartit les données en k clusters.
from sklearn.cluster import KMeans
import matplotlib.pyplot as plt

# Örnek veri seti oluştur
from sklearn.datasets import make_blobs
X, _ = make_blobs(n_samples=300, centers=4, random_state=42)

# Model oluştur ve eğit
kmeans = KMeans(n_clusters=4, random_state=42)
kmeans.fit(X)

# Tahmin yap ve kümeleri görselleştir
y_kmeans = kmeans.predict(X)

plt.scatter(X[:, 0], X[:, 1], c=y_kmeans, s=50, cmap='viridis')
centers = kmeans.cluster_centers_
plt.scatter(centers[:, 0], centers[:, 1], c='red', s=200, alpha=0.75)
plt.title('K-Means Clustering')
plt.show()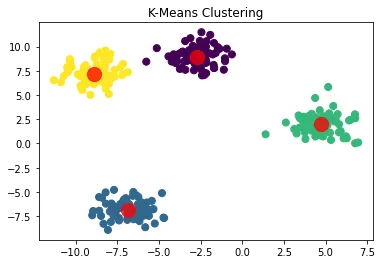
Analyse en composantes principales (ACP)
L’ACP est une technique qui permet de ramener des données de grande dimension à un plus petit nombre de dimensions.
from sklearn.decomposition import PCA

# Model oluştur ve eğit
pca = PCA(n_components=2)
X_pca = pca.fit_transform(X)

plt.scatter(X_pca[:, 0], X_pca[:, 1], c=y_kmeans, s=50, cmap='viridis')
plt.title('PCA Visualization')
plt.show()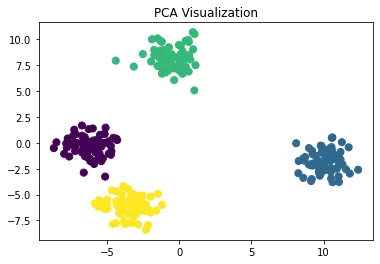
Réglage des hyperparamètres
Le réglage des hyperparamètres est une étape importante pour obtenir les meilleures performances d’un modèle. La classe GridSearchCV de Scikit-Learn facilite cette étape.
from sklearn.model_selection import GridSearchCV
from sklearn.svm import SVC

# Parametre uzayını tanımla
param_grid = {'C': [0.1, 1, 10], 'kernel': ['rbf', 'linear']}

# Grid search nesnesi oluştur
grid_search = GridSearchCV(SVC(), param_grid, cv=5)

# Grid search'ü uygula
grid_search.fit(X_train, y_train)

print("En iyi parametreler:", grid_search.best_params_)
print("En iyi skor:", grid_search.best_score_)
En iyi parametreler: {'C': 1, 'kernel': 'linear'}
En iyi skor: 0.9583333333333334(Les libellés de la sortie sont en turc, car le code d’origine les affiche ainsi : « meilleurs paramètres » et « meilleur score ».)
Validation croisée
La validation croisée est une technique importante pour mesurer la capacité d’un modèle à généraliser à de nouvelles données.
import numpy as np

# Örnek sayısını en küçük olan veri setine eşitleyin
min_samples = min(X.shape[0], y.shape[0])

# Rastgele örnekleme yapın
np.random.seed(42)  # Tekrarlanabilirlik için
indices = np.random.choice(X.shape[0], min_samples, replace=False)
X = X[indices]
y = y[:min_samples]  # y zaten daha küçük

print("New X shape:", X.shape)
print("New y shape:", y.shape)
New X shape: (150, 2)
New y shape: (150,)from sklearn.model_selection import cross_val_score
from sklearn.linear_model import LogisticRegression
# Lojistik regresyon modelini oluştur
log_reg = LogisticRegression()
# 5-fold cross-validation uygula
scores = cross_val_score(log_reg, X, y, cv=5)
print("Cross-validation skorları:", scores)
print("Ortalama skor:", scores.mean())Cross-validation skorları: [0.33333333 0.4 0.26666667 0.36666667 0.3 ]
Ortalama skor: 0.33333333333333337Note de correction : les scores faibles viennent ici de l’étape précédente, pas du modèle. Le code de rééchantillonnage mélange au hasard les lignes de X, mais pas les étiquettes de y de la même façon ; les étiquettes ne correspondent donc plus aux lignes et le modèle tombe au niveau du hasard (environ 0,33 avec trois classes). Si l’on supprime cette étape ou si l’on sélectionne X et y avec les mêmes indices, les scores remontent. Les métriques et le résultat du pipeline plus bas sont faibles pour la même raison, puisqu’ils utilisent les mêmes données.
Sélection et ingénierie des variables
La sélection et l’ingénierie des variables jouent un rôle clé dans la performance du modèle. Scikit-Learn propose des outils qui facilitent ces étapes.
from sklearn.feature_selection import SelectKBest, f_classif

# En iyi 2 özelliği seç
selector = SelectKBest(f_classif, k=2)
X_new = selector.fit_transform(X, y)

print("Seçilen özellikler:", selector.get_support())
Seçilen özellikler: [ True True]Interprétabilité du modèle
Il est important de comprendre comment le modèle prend ses décisions, en particulier pour des modèles comme les arbres de décision.
from sklearn.tree import plot_tree
import matplotlib.pyplot as plt

# Karar ağacını görselleştir
plt.figure(figsize=(20,10))
plot_tree(tree_model, feature_names=iris.feature_names, class_names=iris.target_names, filled=True)
plt.show()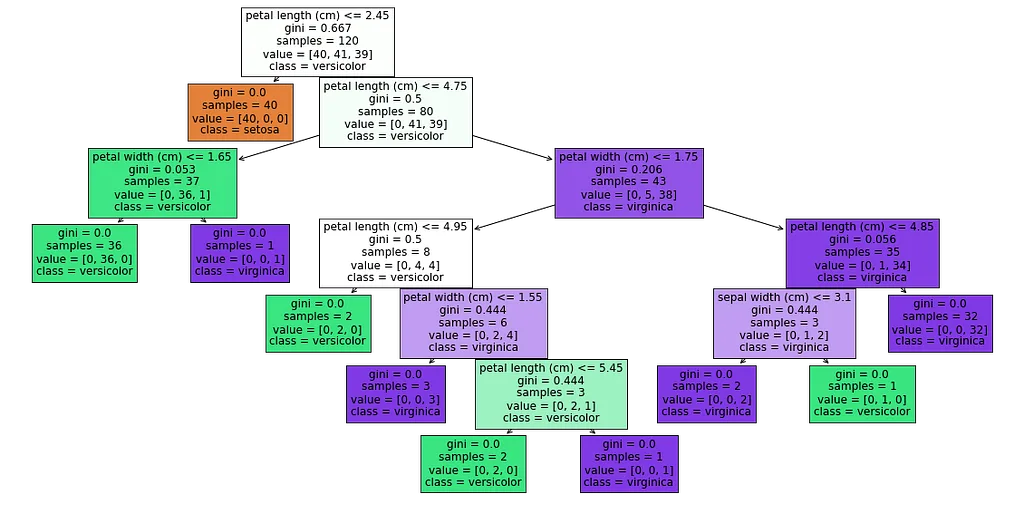
Le schéma montre l’arbre de décision d’un classifieur entraîné sur le jeu de données Iris. En quelques règles, l’arbre sépare les classes setosa, versicolor et virginica :
- Nœud racine : condition petal length ≤ 2,45 cm ; Gini 0,667 ; 120 exemples, répartition [40, 41, 39]. C’est là que les classes sont le plus mélangées.
- Nœud enfant gauche : Gini 0,0 ; les 40 exemples sont tous setosa. Une seule règle isole complètement setosa.
- Nœud enfant droit (petal length > 2,45 cm) : Gini 0,5 ; 80 exemples, répartition [0, 41, 39]. Versicolor et virginica restent mélangées.
- Séparation plus fine : condition petal length ≤ 4,75 cm ; Gini 0,206 ; 43 exemples, répartition [0, 5, 38], majoritairement virginica.
- Nœuds inférieurs : condition petal width ≤ 1,75 cm ; Gini 0,0 ; les 35 exemples sont tous virginica.
Chaque nœud indique le coefficient de Gini, le nombre d’exemples et la répartition des classes, ce qui permet de suivre précisément quelle variable le modèle utilise à quel moment et comment il décide.
Méthodes d’ensemble
Les méthodes d’ensemble combinent plusieurs modèles afin d’obtenir des prédictions plus robustes. Random Forest est l’une des plus populaires.
from sklearn.ensemble import RandomForestClassifier

# Random Forest modeli oluştur ve eğit
rf_model = RandomForestClassifier(n_estimators=100, random_state=42)
rf_model.fit(X_train, y_train)

# Tahmin yap ve doğruluğu ölç
y_pred_rf = rf_model.predict(X_test)
accuracy_rf = accuracy_score(y_test, y_pred_rf)

print(f'Random Forest Model accuracy: {accuracy_rf}')
Random Forest Model accuracy: 1.0Métriques d’évaluation
Au-delà de l’exactitude, d’autres métriques d’évaluation sont également importantes.
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import classification_report, confusion_matrix

# Veri setini ayır
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)

# Modeli eğit
log_reg = LogisticRegression()
log_reg.fit(X_train, y_train)

# Tahminler yap
y_pred_log = log_reg.predict(X_test)

# Sınıflandırma raporu oluştur
print(classification_report(y_test, y_pred_log, target_names=iris.target_names))

# Confusion matrix oluştur
cm = confusion_matrix(y_test, y_pred_log)
print("Confusion Matrix:\n", cm)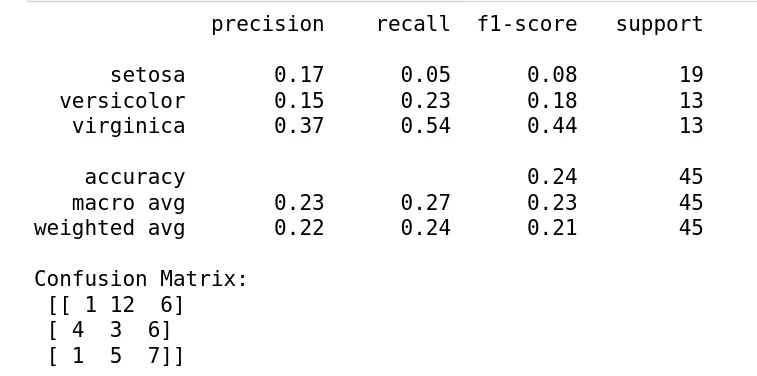
Ces résultats montrent la performance d’un modèle entraîné sur les données mélangées plus haut :
- Précision, la part des prédictions positives correctes : setosa 17 %, versicolor 15 %, virginica 37 %.
- Rappel, la part des positifs réels effectivement détectés : setosa 5 %, versicolor 23 %, virginica 54 %.
- Score F1, la moyenne harmonique de la précision et du rappel : setosa 0,08, versicolor 0,18, virginica 0,44.
- Exactitude globale : 24 %.
- Moyenne macro : précision 23 %, rappel 27 %, F1 23 %. Moyenne pondérée : précision 22 %, rappel 24 %, F1 21 %.
Dans la matrice de confusion, 1 exemple setosa est correctement prédit, 12 sont prédits comme versicolor et 6 comme virginica ; pour versicolor, 3 sont corrects, 4 sont prédits comme setosa et 6 comme virginica ; pour virginica, 7 sont corrects, 1 est prédit comme setosa et 5 comme versicolor.
Interprétation et pistes d’amélioration
La performance globale est faible ; virginica s’en sort le mieux, mais cela reste insuffisant. Comme l’explique la note de correction ci-dessus, la cause principale est le mélange des étiquettes. Au-delà, les étapes suivantes améliorent généralement la performance :
- Essayer des modèles plus puissants comme Random Forest ou SVM, et régler leurs hyperparamètres
- Ajouter de nouvelles variables ou transformer celles qui existent
- Rééquilibrer les classes avec des méthodes comme SMOTE si elles sont déséquilibrées
- Utiliser la validation croisée pour repérer le surapprentissage ou le sous-apprentissage
Une application concrète : la segmentation de la clientèle
Comme application concrète, prenons la segmentation des clients d’une entreprise de commerce en ligne.
from sklearn.preprocessing import StandardScaler
from sklearn.cluster import KMeans

# Örnek veri oluştur (gerçek senaryoda bu veri müşteri veritabanından gelir)
customer_data = np.random.rand(1000, 3)  # 1000 müşteri, 3 özellik (örn: yaş, toplam harcama, ziyaret sıklığı)

# Veriyi ölçeklendir
scaler = StandardScaler()
customer_data_scaled = scaler.fit_transform(customer_data)

# K-Means uygula
kmeans = KMeans(n_clusters=4, random_state=42)
clusters = kmeans.fit_predict(customer_data_scaled)

print("Müşteri segmentleri:", np.unique(clusters))
Müşteri segmentleri: [0 1 2 3]Les pipelines de Scikit-Learn
Un pipeline enchaîne les étapes de prétraitement et d’entraînement du modèle, ce qui rend le code plus propre et plus efficace.
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler

# Pipeline oluştur
pipeline = Pipeline([
    ('scaler', StandardScaler()),
    ('classifier', LogisticRegression())
])

# Pipeline'ı eğit ve değerlendir
pipeline.fit(X_train, y_train)
accuracy_pipeline = pipeline.score(X_test, y_test)

print(f'Pipeline Model accuracy: {accuracy_pipeline}')
Pipeline Model accuracy: 0.24444444444444444Étude de cas : classification avec le jeu de données Iris
Dans cette étude de cas, nous appliquons plusieurs algorithmes d’apprentissage automatique au jeu de données Iris et comparons les résultats.
Préparer les données
Nous commençons par charger le jeu de données et le séparer en ensembles d’entraînement et de test.
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split

# Veri setini yükle
iris = load_iris()
X = iris.data
y = iris.target

# Veriyi eğitim ve test olarak ayır
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
Appliquer et comparer les algorithmes
Nous appliquons maintenant la régression logistique, un arbre de décision et l’algorithme KNN, puis comparons les résultats.
from sklearn.linear_model import LogisticRegression
from sklearn.tree import DecisionTreeClassifier
from sklearn.neighbors import KNeighborsClassifier
from sklearn.metrics import accuracy_score

# Lojistik Regresyon
log_reg = LogisticRegression(max_iter=200)
log_reg.fit(X_train, y_train)
y_pred_log = log_reg.predict(X_test)
accuracy_log = accuracy_score(y_test, y_pred_log)

# Karar Ağaçları
tree_model = DecisionTreeClassifier(random_state=42)
tree_model.fit(X_train, y_train)
y_pred_tree = tree_model.predict(X_test)
accuracy_tree = accuracy_score(y_test, y_pred_tree)

# KNN
knn = KNeighborsClassifier(n_neighbors=3)
knn.fit(X_train, y_train)
y_pred_knn = knn.predict(X_test)
accuracy_knn = accuracy_score(y_test, y_pred_knn)

print(f'Logistic Regression accuracy: {accuracy_log}')
print(f'Decision Tree accuracy: {accuracy_tree}')
print(f'KNN accuracy: {accuracy_knn}')
Logistic Regression accuracy: 1.0
Decision Tree accuracy: 1.0
KNN accuracy: 1.0Conclusion
Dans cet article, nous avons parcouru les étapes d’un processus d’apprentissage automatique avec Scikit-Learn et vu comment les appliquer. Nous avons utilisé des algorithmes supervisés et non supervisés sur le jeu de données Iris et, au-delà des algorithmes de base, abordé l’optimisation, l’évaluation et l’interprétation, une application concrète et les pipelines. Grâce à sa large palette d’outils, Scikit-Learn facilite la résolution de problèmes complexes pour les data scientists et les praticiens de l’apprentissage automatique.
Références
- Pedregosa, F. et al. (2011). Scikit-learn: Machine Learning in Python. Journal of Machine Learning Research, 12, 2825–2830.
- Documentation de Scikit-Learn : scikit-learn.org
- Hastie, T., Tibshirani, R. et Friedman, J. (2009). The Elements of Statistical Learning. Springer.
- Kuhn, M. et Johnson, K. (2013). Applied Predictive Modeling. Springer.
- Géron, A. (2019). Hands-On Machine Learning with Scikit-Learn, Keras, and TensorFlow. O’Reilly Media.
- Müller, A. C. et Guido, S. (2016). Introduction to Machine Learning with Python. O’Reilly Media.
- Raschka, S. et Mirjalili, V. (2019). Python Machine Learning. Packt Publishing.
- VanderPlas, J. (2016). Python Data Science Handbook. O’Reilly Media.