

Python для анализа данных: машинное обучение с помощью Scikit-Learn
Автор: Yasin TANIŞ
Введение
Машинное обучение — это область науки, которая позволяет компьютерам учиться на данных и делать прогнозы; сегодня оно применяется во многих отраслях. В этой статье мы рассмотрим Scikit-Learn, одну из самых популярных библиотек Python для приложений машинного обучения.
Что такое Scikit-Learn
Scikit-Learn — библиотека машинного обучения с простыми и эффективными инструментами для Python. В ней есть алгоритмы обучения с учителем и без учителя.
Установка
Прежде чем начать, библиотеку нужно установить. Если её ещё нет в системе, установите её следующей командой:
pip install scikit-learnПримечание: примеры намеренно упрощены, чтобы проиллюстрировать идеи; выбранные метрики и методы не всегда оптимальны для любого сценария.
Обучение с учителем
Обучение с учителем работает с размеченными данными: результаты (метки) примеров известны, и модель может научиться их предсказывать.
Логистическая регрессия
Логистическая регрессия — широко используемый алгоритм для задач классификации.
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import accuracy_score
# Veri setini yükle
iris = load_iris()
X = iris.data
y = iris.target
# Veriyi eğitim ve test olarak ayır
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
# Model oluştur ve eğit
model = LogisticRegression(max_iter=200)
model.fit(X_train, y_train)
# Tahmin yap ve doğruluğu ölç
y_pred = model.predict(X_test)
accuracy = accuracy_score(y_test, y_pred)
print(f'Model accuracy: {accuracy}')
Model Accuracy : 1.0Этот код загружает набор данных Iris, делит его на признаки и целевую переменную, обучает модель и выводит её долю верных ответов (accuracy).
Деревья решений
Деревья решений — мощный алгоритм как для классификации, так и для регрессии.
from sklearn.tree import DecisionTreeClassifier

# Model oluştur ve eğit
tree_model = DecisionTreeClassifier(random_state=42)
tree_model.fit(X_train, y_train)

# Tahmin yap ve doğruluğu ölç
y_pred_tree = tree_model.predict(X_test)
accuracy_tree = accuracy_score(y_test, y_pred_tree)

print(f'Decision Tree Model accuracy: {accuracy_tree}')
Decision Tree Model Accuracy: 1.0Обучение без учителя
Обучение без учителя не использует размеченные данные; модель сама пытается понять структуру данных.
Кластеризация K-Means
K-Means — распространённый алгоритм кластеризации, который делит данные на k кластеров.
from sklearn.cluster import KMeans
import matplotlib.pyplot as plt

# Örnek veri seti oluştur
from sklearn.datasets import make_blobs
X, _ = make_blobs(n_samples=300, centers=4, random_state=42)

# Model oluştur ve eğit
kmeans = KMeans(n_clusters=4, random_state=42)
kmeans.fit(X)

# Tahmin yap ve kümeleri görselleştir
y_kmeans = kmeans.predict(X)

plt.scatter(X[:, 0], X[:, 1], c=y_kmeans, s=50, cmap='viridis')
centers = kmeans.cluster_centers_
plt.scatter(centers[:, 0], centers[:, 1], c='red', s=200, alpha=0.75)
plt.title('K-Means Clustering')
plt.show()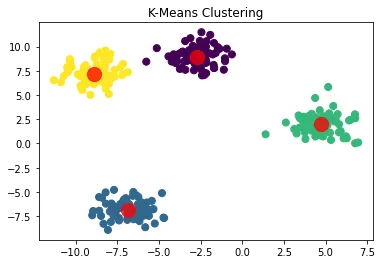
Метод главных компонент (PCA)
PCA — метод, который сводит многомерные данные к меньшему числу измерений.
from sklearn.decomposition import PCA

# Model oluştur ve eğit
pca = PCA(n_components=2)
X_pca = pca.fit_transform(X)

plt.scatter(X_pca[:, 0], X_pca[:, 1], c=y_kmeans, s=50, cmap='viridis')
plt.title('PCA Visualization')
plt.show()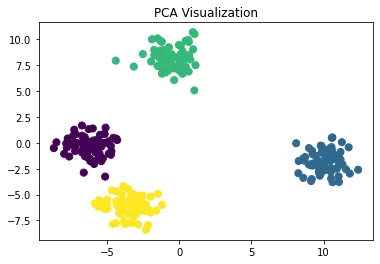
Подбор гиперпараметров
Подбор гиперпараметров — важный шаг, чтобы получить от модели лучший результат. Класс GridSearchCV из Scikit-Learn упрощает эту задачу.
from sklearn.model_selection import GridSearchCV
from sklearn.svm import SVC

# Parametre uzayını tanımla
param_grid = {'C': [0.1, 1, 10], 'kernel': ['rbf', 'linear']}

# Grid search nesnesi oluştur
grid_search = GridSearchCV(SVC(), param_grid, cv=5)

# Grid search'ü uygula
grid_search.fit(X_train, y_train)

print("En iyi parametreler:", grid_search.best_params_)
print("En iyi skor:", grid_search.best_score_)
En iyi parametreler: {'C': 1, 'kernel': 'linear'}
En iyi skor: 0.9583333333333334(Подписи в выводе на турецком, потому что так их печатает исходный код: «лучшие параметры» и «лучший результат».)
Перекрёстная проверка
Перекрёстная проверка — важный приём, чтобы измерить, насколько хорошо модель обобщается на новые данные.
import numpy as np

# Örnek sayısını en küçük olan veri setine eşitleyin
min_samples = min(X.shape[0], y.shape[0])

# Rastgele örnekleme yapın
np.random.seed(42)  # Tekrarlanabilirlik için
indices = np.random.choice(X.shape[0], min_samples, replace=False)
X = X[indices]
y = y[:min_samples]  # y zaten daha küçük

print("New X shape:", X.shape)
print("New y shape:", y.shape)
New X shape: (150, 2)
New y shape: (150,)from sklearn.model_selection import cross_val_score
from sklearn.linear_model import LogisticRegression
# Lojistik regresyon modelini oluştur
log_reg = LogisticRegression()
# 5-fold cross-validation uygula
scores = cross_val_score(log_reg, X, y, cv=5)
print("Cross-validation skorları:", scores)
print("Ortalama skor:", scores.mean())Cross-validation skorları: [0.33333333 0.4 0.26666667 0.36666667 0.3 ]
Ortalama skor: 0.33333333333333337Поправка: низкие оценки здесь вызваны предыдущим шагом, а не моделью. Код повторной выборки случайно перемешивает строки X, но не перемешивает так же метки в y, поэтому метки перестают соответствовать строкам и модель опускается до уровня случайного угадывания (около 0,33 при трёх классах). Если пропустить этот шаг или выбирать X и y по одним и тем же индексам, оценки снова станут высокими. Метрики и результаты пайплайна ниже тоже низкие по той же причине: они используют те же данные.
Отбор и конструирование признаков
Отбор и конструирование признаков играют ключевую роль в качестве модели. В Scikit-Learn есть инструменты, упрощающие эти шаги.
from sklearn.feature_selection import SelectKBest, f_classif

# En iyi 2 özelliği seç
selector = SelectKBest(f_classif, k=2)
X_new = selector.fit_transform(X, y)

print("Seçilen özellikler:", selector.get_support())
Seçilen özellikler: [ True True]Интерпретируемость модели
Особенно для таких моделей, как деревья решений, важно понимать, как модель принимает решения.
from sklearn.tree import plot_tree
import matplotlib.pyplot as plt

# Karar ağacını görselleştir
plt.figure(figsize=(20,10))
plot_tree(tree_model, feature_names=iris.feature_names, class_names=iris.target_names, filled=True)
plt.show()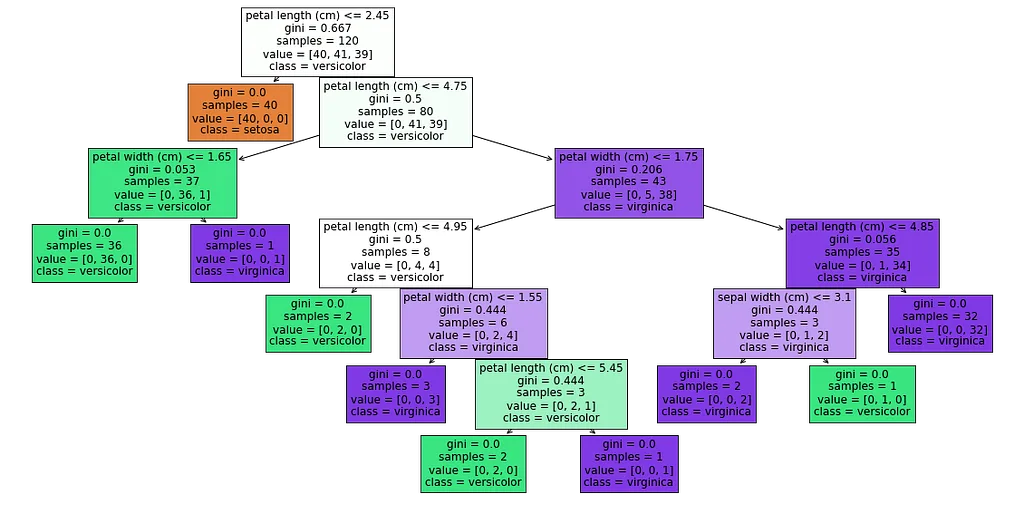
Схема показывает дерево решений классификатора, обученного на наборе Iris. С помощью нескольких правил дерево разделяет классы setosa, versicolor и virginica:
- Корневой узел: условие petal length ≤ 2.45 cm; Gini 0.667; 120 примеров, распределение [40, 41, 39]. Здесь классы смешаны сильнее всего.
- Левый дочерний узел: Gini 0.0; все 40 примеров — setosa. Одно правило полностью отделяет setosa.
- Правый дочерний узел (petal length > 2.45 cm): Gini 0.5; 80 примеров, распределение [0, 41, 39]. Versicolor и virginica ещё смешаны.
- Более тонкое разделение: условие petal length ≤ 4.75 cm; Gini 0.206; 43 примера, распределение [0, 5, 38], в основном virginica.
- Нижние узлы: условие petal width ≤ 1.75 cm; Gini 0.0; все 35 примеров — virginica.
В каждом узле видны коэффициент Джини, число примеров и распределение классов, поэтому можно точно проследить, какой признак модель использует на каждом шаге и как принимает решение.
Ансамблевые методы
Ансамблевые методы объединяют несколько моделей, чтобы получать более надёжные прогнозы. Random Forest — один из самых популярных.
from sklearn.ensemble import RandomForestClassifier

# Random Forest modeli oluştur ve eğit
rf_model = RandomForestClassifier(n_estimators=100, random_state=42)
rf_model.fit(X_train, y_train)

# Tahmin yap ve doğruluğu ölç
y_pred_rf = rf_model.predict(X_test)
accuracy_rf = accuracy_score(y_test, y_pred_rf)

print(f'Random Forest Model accuracy: {accuracy_rf}')
Random Forest Model accuracy: 1.0Метрики оценки
Помимо доли верных ответов (accuracy), важны и другие метрики оценки.
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import classification_report, confusion_matrix

# Veri setini ayır
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)

# Modeli eğit
log_reg = LogisticRegression()
log_reg.fit(X_train, y_train)

# Tahminler yap
y_pred_log = log_reg.predict(X_test)

# Sınıflandırma raporu oluştur
print(classification_report(y_test, y_pred_log, target_names=iris.target_names))

# Confusion matrix oluştur
cm = confusion_matrix(y_test, y_pred_log)
print("Confusion Matrix:\n", cm)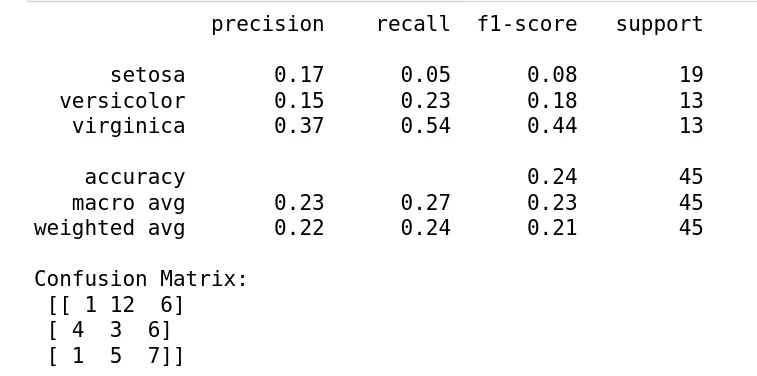
Эти результаты показывают качество модели, обученной на перемешанных ранее данных:
- Точность (precision), доля верных среди положительных прогнозов: setosa 17%, versicolor 15%, virginica 37%.
- Полнота (recall), доля найденных истинно положительных: setosa 5%, versicolor 23%, virginica 54%.
- F1-мера, гармоническое среднее точности и полноты: setosa 0.08, versicolor 0.18, virginica 0.44.
- Общая доля верных ответов: 24%.
- Макросреднее: точность 23%, полнота 27%, F1 23%. Взвешенное среднее: точность 22%, полнота 24%, F1 21%.
В матрице ошибок 1 пример setosa предсказан верно, 12 — как versicolor и 6 — как virginica; у versicolor 3 верных, 4 — как setosa и 6 — как virginica; у virginica 7 верных, 1 — как setosa и 5 — как versicolor.
Интерпретация и рекомендации
Общее качество низкое; лучше всего справляется virginica, но и этого недостаточно. Как объясняет поправка выше, главная причина — перепутанные метки. Кроме того, качество обычно улучшают такие шаги:
- Попробовать более сильные модели, например Random Forest или SVM, и подобрать гиперпараметры
- Добавить новые признаки или преобразовать существующие
- Сбалансировать классы методами вроде SMOTE, если они несбалансированы
- Использовать перекрёстную проверку, чтобы выявить переобучение или недообучение
Практическое применение: сегментация клиентов
В качестве практического примера рассмотрим сегментацию клиентов интернет-магазина.
from sklearn.preprocessing import StandardScaler
from sklearn.cluster import KMeans

# Örnek veri oluştur (gerçek senaryoda bu veri müşteri veritabanından gelir)
customer_data = np.random.rand(1000, 3)  # 1000 müşteri, 3 özellik (örn: yaş, toplam harcama, ziyaret sıklığı)

# Veriyi ölçeklendir
scaler = StandardScaler()
customer_data_scaled = scaler.fit_transform(customer_data)

# K-Means uygula
kmeans = KMeans(n_clusters=4, random_state=42)
clusters = kmeans.fit_predict(customer_data_scaled)

print("Müşteri segmentleri:", np.unique(clusters))
Müşteri segmentleri: [0 1 2 3]Пайплайны в Scikit-Learn
Пайплайн объединяет шаги предобработки и обучения модели, делая код чище и эффективнее.
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler

# Pipeline oluştur
pipeline = Pipeline([
    ('scaler', StandardScaler()),
    ('classifier', LogisticRegression())
])

# Pipeline'ı eğit ve değerlendir
pipeline.fit(X_train, y_train)
accuracy_pipeline = pipeline.score(X_test, y_test)

print(f'Pipeline Model accuracy: {accuracy_pipeline}')
Pipeline Model accuracy: 0.24444444444444444Разбор: классификация на наборе Iris
В этом разборе мы применим несколько алгоритмов машинного обучения к набору Iris и сравним результаты.
Подготовка данных
Сначала загрузим набор данных и разделим его на обучающую и тестовую выборки.
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split

# Veri setini yükle
iris = load_iris()
X = iris.data
y = iris.target

# Veriyi eğitim ve test olarak ayır
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
Применение и сравнение алгоритмов
Теперь применим логистическую регрессию, дерево решений и KNN и сравним результаты.
from sklearn.linear_model import LogisticRegression
from sklearn.tree import DecisionTreeClassifier
from sklearn.neighbors import KNeighborsClassifier
from sklearn.metrics import accuracy_score

# Lojistik Regresyon
log_reg = LogisticRegression(max_iter=200)
log_reg.fit(X_train, y_train)
y_pred_log = log_reg.predict(X_test)
accuracy_log = accuracy_score(y_test, y_pred_log)

# Karar Ağaçları
tree_model = DecisionTreeClassifier(random_state=42)
tree_model.fit(X_train, y_train)
y_pred_tree = tree_model.predict(X_test)
accuracy_tree = accuracy_score(y_test, y_pred_tree)

# KNN
knn = KNeighborsClassifier(n_neighbors=3)
knn.fit(X_train, y_train)
y_pred_knn = knn.predict(X_test)
accuracy_knn = accuracy_score(y_test, y_pred_knn)

print(f'Logistic Regression accuracy: {accuracy_log}')
print(f'Decision Tree accuracy: {accuracy_tree}')
print(f'KNN accuracy: {accuracy_knn}')
Logistic Regression accuracy: 1.0
Decision Tree accuracy: 1.0
KNN accuracy: 1.0Заключение
В этой статье мы прошли этапы процесса машинного обучения в Scikit-Learn и увидели, как их применять. Мы использовали алгоритмы с учителем и без учителя на наборе Iris и, помимо базовых алгоритмов, рассмотрели оптимизацию, оценку и интерпретацию, практическое применение и пайплайны. Благодаря широкому набору инструментов Scikit-Learn упрощает решение сложных задач для специалистов по данным и машинному обучению.
Источники
- Pedregosa, F. и др. (2011). Scikit-learn: Machine Learning in Python. Journal of Machine Learning Research, 12, 2825–2830.
- Документация Scikit-Learn: scikit-learn.org
- Hastie, T., Tibshirani, R. и Friedman, J. (2009). The Elements of Statistical Learning. Springer.
- Kuhn, M. и Johnson, K. (2013). Applied Predictive Modeling. Springer.
- Géron, A. (2019). Hands-On Machine Learning with Scikit-Learn, Keras, and TensorFlow. O’Reilly Media.
- Müller, A. C. и Guido, S. (2016). Introduction to Machine Learning with Python. O’Reilly Media.
- Raschka, S. и Mirjalili, V. (2019). Python Machine Learning. Packt Publishing.
- VanderPlas, J. (2016). Python Data Science Handbook. O’Reilly Media.