

Анализ на данни с Pandas: обработка и визуализация на данни
Автор Yasin TANIŞ
Въведение
Анализът на данни се превърна в неразделна част от вземането на решения. Python се откроява в тази област благодарение на мощните си библиотеки за анализ и обработка на данни. Една от тях, pandas, е незаменима за специалистите по данни, защото е гъвкава и лесна за използване. В тази статия разглеждаме основните възможности на pandas и как се използват в анализа на данни, с практически примери върху реални или синтетични данни.
DataFrame и Series
Pandas работи с две основни структури от данни. DataFrame е двумерна структура от редове и колони. Series е едномерна и представя една колона от данни.
import pandas as pd

# Creating a simple DataFrame
data = {
    'name': ['Alice', 'Bob', 'Charlie'],
    'age': [25, 30, 35],
    'city': ['New York', 'Los Angeles', 'Chicago']
}
df = pd.DataFrame(data)
print(df)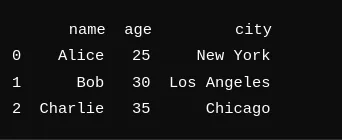
Създаване на DataFrame
DataFrame може да се създаде по много начини. Можете да заредите данни от източници като CSV, Excel и SQL и да ги превърнете в DataFrame.
# Loading data from a CSV file
df = pd.read_csv('data.csv')

# Loading data from an Excel file
df = pd.read_excel('data.xlsx')

# Loading data from an SQL database
import sqlite3
conn = sqlite3.connect('database.db')
df = pd.read_sql_query('SELECT * FROM table', conn)
Зареждане и записване на данни
Pandas улеснява зареждането и записването на данни. Можете да четете и обработвате файлове в много различни формати.
# Saving data
df.to_csv('new_data.csv', index=False)
df.to_excel('new_data.xlsx', index=False)
Почистване и подготовка на данните
Почистването и подготовката са ключови стъпки в анализа на данни. Pandas улеснява работата с липсващи стойности, преобразуването на типове данни и премахването на ненужни данни.
# Checking for missing values
print(df.isnull().sum())

# Filling missing values
df.fillna(0, inplace=True)

# Converting data types
df['date'] = pd.to_datetime(df['date'])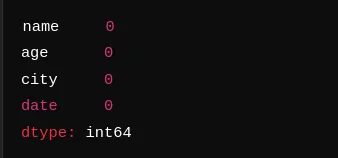
Тук проверяваме дали в DataFrame има липсващи стойности. Резултатът показва, че в нито една колона няма такива.
Статистически обобщения
Pandas предлага много инструменти за бързо обобщаване на данни. Основните статистически показатели и обобщения се получават с едно извикване.
# Basic statistical summaries
print(df.describe())

# Summarizing specific columns
print(df['age'].mean())
print(df['age'].std())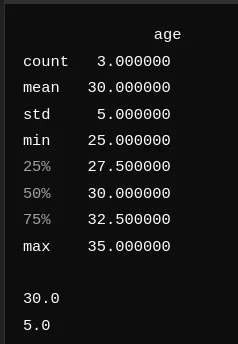
В обобщението средната възраст е 30, а стандартното отклонение е 5; най-малката и най-голямата възраст са 25 и 35. Това дава бърза представа за разпределението на възрастта в данните.
Групиране и обобщаване
Групирането и обобщаването са сред силните страни на pandas. Функциите groupby и pivot_table ги правят лесни.
# Grouping and summarizing
group = df.groupby('city')['age'].mean()
print(group)

# Creating a pivot table
pivot = df.pivot_table(values='age', index='city', columns='gender', aggfunc='mean')
print(pivot)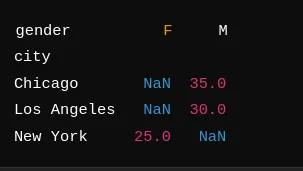
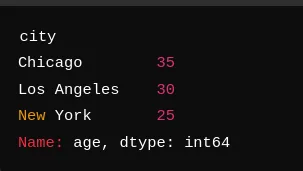
При групиране по град получаваме средната възраст за всеки от тях: Chicago (35), Los Angeles (30) и New York (25). Обобщената таблица дава подобно обобщение, разбито по пол; в нашия пример няма данни за пол, затова тези клетки показват NaN.
Визуализация на данни с pandas
Pandas има прости, но ефективни инструменти за графики. Функции като plot, hist и boxplot бързо създават диаграми.
# Basic plots
df['age'].plot(kind='hist')
df.plot(kind='scatter', x='age', y='income')
Работа със Seaborn и Matplotlib
Данните от pandas могат да се визуализират и със Seaborn и Matplotlib, които позволяват по-персонализирани и подробни графики.
import seaborn as sns
import matplotlib.pyplot as plt

# Visualizing with Seaborn
sns.boxplot(x='city', y='age', data=df)
plt.show()
Анализ на времеви редове
Pandas работи много добре с времеви редове, което улеснява откриването на тенденции и закономерности.
# Handling time series data
df['date'] = pd.to_datetime(df['date'])
df.set_index('date', inplace=True)
print(df.resample('M').mean())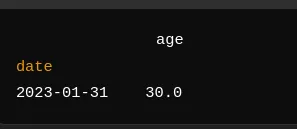
Тук преобразуваме колоната date в datetime и я задаваме като индекс. С ресемплиране по месеци и изчисляване на средната стойност получаваме средна възраст 30 за януари 2023 г.
Сливане и комбиниране на данни
Pandas има много функции за сливане и комбиниране на набори от данни, като merge, join и concat.
# Merging two DataFrames
df1 = pd.DataFrame({'name': ['Alice', 'Bob'], 'age': [25, 30]})
df2 = pd.DataFrame({'name': ['Alice', 'Bob'], 'city': ['New York', 'Los Angeles']})
merged_df = pd.merge(df1, df2, on='name')
print(merged_df)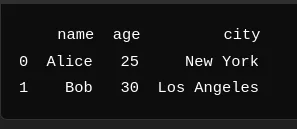
В този пример сливаме два DataFrame по колоната name и обединяваме възрастта и града на всеки човек.
Практически пример: анализ със синтетични данни
Създаване на данните
За практическия пример създаваме синтетични данни, за да покажем какво може pandas.
import pandas as pd
import numpy as np
import seaborn as sns
import matplotlib.pyplot as plt

# Creating synthetic data
np.random.seed(0)
dates = pd.date_range('20230101', periods=100)
df = pd.DataFrame(np.random.randn(100, 4), index=dates, columns=list('ABCD'))
df['Category'] = np.random.choice(['Category1', 'Category2', 'Category3'], size=100)
print(df.head())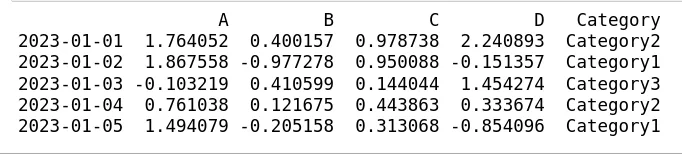
Така се създава DataFrame със 100 реда, колони A, B, C и D и категорийна колона Category. Стойностите са случайни, а Category приема една от три стойности.
Анализ и визуализация
Върху синтетичните данни извършваме основен анализ и чертаем графики.
# Statistical summary
print(df.describe())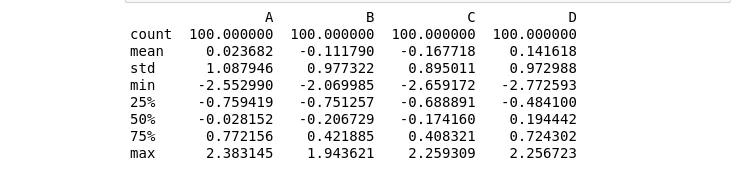
Обобщението дава пълен преглед на данните. Средните стойности на колоните A, B, C и D са близо до нула, както се очаква при случайно нормално разпределение, а стандартните отклонения са близо до 1, което показва колко са разпръснати стойностите около средната.
# Grouping and summarizing
grouped = df.groupby('Category').mean()
print(grouped)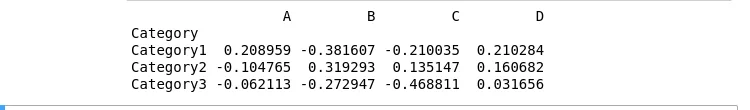
Групирането по Category показва средната стойност на всяка колона за всяка категория и разкрива по какво се различават категориите.
# Visualizing data
df['A'].plot(kind='hist', title='Histogram of A')
plt.show()

sns.boxplot(x='Category', y='B', data=df)
plt.show()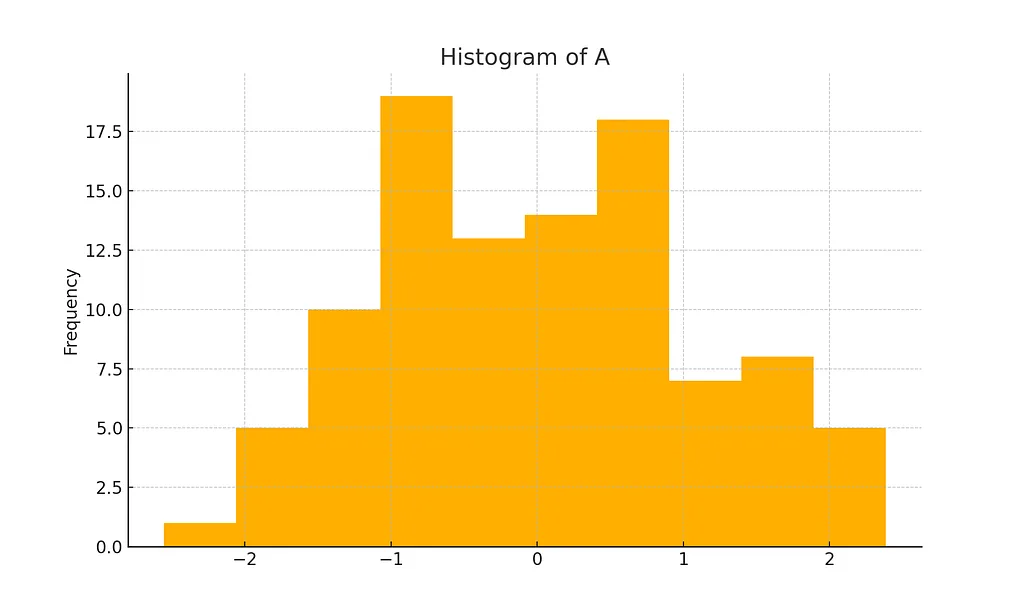
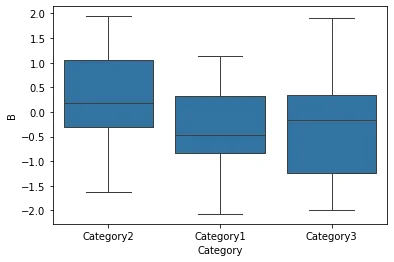
Хистограмата показва разпределението на стойностите в колона A, а диаграмата „кутия с мустаци“ – колона B по категории. Такива графики помагат да разберете разпределението и да забележите извънредни стойности или закономерности.
Заключение
Pandas е универсален и мощен инструмент за анализ на данни; гъвкавостта и лесната употреба го правят незаменим за специалистите по данни. В тази статия разгледахме основните му възможности и мястото им в анализа и показахме практическа употреба върху синтетични данни. С още практика и по-напреднали техники можете да навлезете по-дълбоко в науката за данни и да извличате с pandas повече ценна информация от данните си.
Източници
- McKinney, W. (2010). Data Structures for Statistical Computing in Python. Proceedings of the 9th Python in Science Conference, 51–56.
- McKinney, W. (2017). Python for Data Analysis: Data Wrangling with Pandas, NumPy, and IPython (2-ро изд.). O’Reilly Media.
- Екипът на pandas. Документация на pandas. pandas.pydata.org
- Документация на NumPy. numpy.org
- Документация на Matplotlib. matplotlib.org
- Документация на Seaborn. seaborn.pydata.org