

Datenanalyse mit pandas: Daten bearbeiten und visualisieren
Von Yasin TANIŞ
Einführung
Datenanalyse ist zu einem festen Bestandteil der Entscheidungsfindung geworden. Python sticht in diesem Bereich durch leistungsfähige Bibliotheken für die Analyse und Bearbeitung von Daten hervor. Eine davon, pandas, ist für Data Scientists unverzichtbar, weil sie flexibel und leicht zu bedienen ist. In diesem Beitrag betrachten wir die Grundfunktionen von pandas und ihren Einsatz in der Datenanalyse – mit praktischen Beispielen anhand echter oder synthetischer Daten.
DataFrame und Series
Pandas arbeitet mit zwei zentralen Datenstrukturen. Ein DataFrame ist eine zweidimensionale Struktur aus Zeilen und Spalten. Eine Series ist eindimensional und steht für eine einzelne Datenspalte.
import pandas as pd

# Creating a simple DataFrame
data = {
    'name': ['Alice', 'Bob', 'Charlie'],
    'age': [25, 30, 35],
    'city': ['New York', 'Los Angeles', 'Chicago']
}
df = pd.DataFrame(data)
print(df)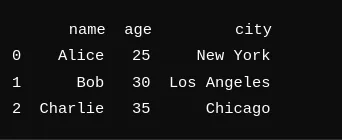
DataFrames erstellen
Es gibt viele Wege, ein DataFrame zu erstellen. Sie können Daten aus Quellen wie CSV, Excel und SQL laden und in ein DataFrame umwandeln.
# Loading data from a CSV file
df = pd.read_csv('data.csv')

# Loading data from an Excel file
df = pd.read_excel('data.xlsx')

# Loading data from an SQL database
import sqlite3
conn = sqlite3.connect('database.db')
df = pd.read_sql_query('SELECT * FROM table', conn)
Daten laden und speichern
Pandas macht das Laden und Speichern von Daten einfach. Sie können Dateien in vielen Formaten lesen und verarbeiten.
# Saving data
df.to_csv('new_data.csv', index=False)
df.to_excel('new_data.xlsx', index=False)
Daten bereinigen und vorbereiten
Bereinigung und Vorbereitung sind entscheidende Schritte der Datenanalyse. Pandas erleichtert den Umgang mit fehlenden Werten, die Umwandlung von Datentypen und das Entfernen unnötiger Daten.
# Checking for missing values
print(df.isnull().sum())

# Filling missing values
df.fillna(0, inplace=True)

# Converting data types
df['date'] = pd.to_datetime(df['date'])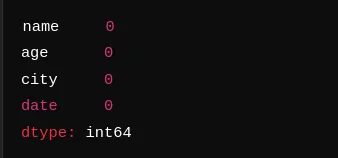
Hier prüfen wir, ob das DataFrame fehlende Werte enthält. Die Ausgabe zeigt, dass in keiner Spalte Werte fehlen.
Statistische Zusammenfassungen
Pandas bietet viele Werkzeuge, um Daten schnell zusammenzufassen. Grundlegende Statistiken und Zusammenfassungen liefert ein einziger Aufruf.
# Basic statistical summaries
print(df.describe())

# Summarizing specific columns
print(df['age'].mean())
print(df['age'].std())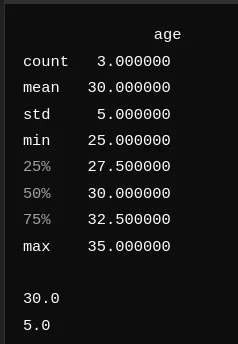
In der Zusammenfassung liegt das Durchschnittsalter bei 30 mit einer Standardabweichung von 5; Mindest- und Höchstalter liegen bei 25 bzw. 35. So erhält man schnell einen Überblick über die Altersverteilung in den Daten.
Gruppieren und zusammenfassen
Gruppieren und Zusammenfassen gehört zu den Stärken von pandas. Die Funktionen groupby und pivot_table machen es einfach.
# Grouping and summarizing
group = df.groupby('city')['age'].mean()
print(group)

# Creating a pivot table
pivot = df.pivot_table(values='age', index='city', columns='gender', aggfunc='mean')
print(pivot)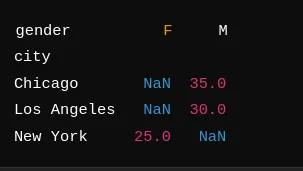
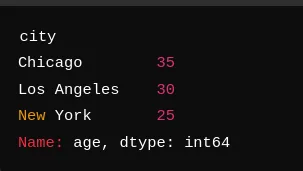
Die Gruppierung nach Stadt liefert das Durchschnittsalter je Stadt: Chicago (35), Los Angeles (30) und New York (25). Die Pivot-Tabelle liefert eine ähnliche Zusammenfassung, aufgeschlüsselt nach Geschlecht; unser Beispiel enthält keine Geschlechtsdaten, daher zeigen diese Zellen NaN.
Visualisierung mit pandas
Pandas bietet einfache, aber wirkungsvolle Werkzeuge zur Visualisierung. Funktionen wie plot, hist und boxplot erzeugen schnell Diagramme.
# Basic plots
df['age'].plot(kind='hist')
df.plot(kind='scatter', x='age', y='income')
Zusammenspiel mit Seaborn und Matplotlib
Daten aus pandas lassen sich auch mit Seaborn und Matplotlib darstellen, die stärker angepasste und detailliertere Diagramme ermöglichen.
import seaborn as sns
import matplotlib.pyplot as plt

# Visualizing with Seaborn
sns.boxplot(x='city', y='age', data=df)
plt.show()
Zeitreihenanalyse
Pandas kommt sehr gut mit Zeitreihen zurecht, sodass sich Trends und Muster leicht finden lassen.
# Handling time series data
df['date'] = pd.to_datetime(df['date'])
df.set_index('date', inplace=True)
print(df.resample('M').mean())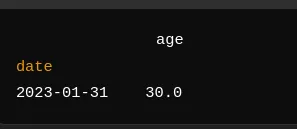
Hier wandeln wir die Spalte date in datetime um und setzen sie als Index. Das monatliche Resampling mit anschließender Mittelwertbildung ergibt für Januar 2023 ein Durchschnittsalter von 30.
Daten zusammenführen und kombinieren
Pandas bietet viele Funktionen zum Zusammenführen und Kombinieren von Datensätzen, etwa merge, join und concat.
# Merging two DataFrames
df1 = pd.DataFrame({'name': ['Alice', 'Bob'], 'age': [25, 30]})
df2 = pd.DataFrame({'name': ['Alice', 'Bob'], 'city': ['New York', 'Los Angeles']})
merged_df = pd.merge(df1, df2, on='name')
print(merged_df)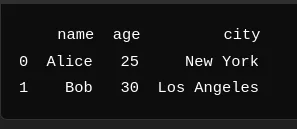
In diesem Beispiel führen wir zwei DataFrames über die Spalte name zusammen und kombinieren Alter und Stadt jeder Person.
Praxisbeispiel: Analyse mit synthetischen Daten
Daten erzeugen
Für ein Praxisbeispiel erzeugen wir synthetische Daten, die zeigen, was pandas kann.
import pandas as pd
import numpy as np
import seaborn as sns
import matplotlib.pyplot as plt

# Creating synthetic data
np.random.seed(0)
dates = pd.date_range('20230101', periods=100)
df = pd.DataFrame(np.random.randn(100, 4), index=dates, columns=list('ABCD'))
df['Category'] = np.random.choice(['Category1', 'Category2', 'Category3'], size=100)
print(df.head())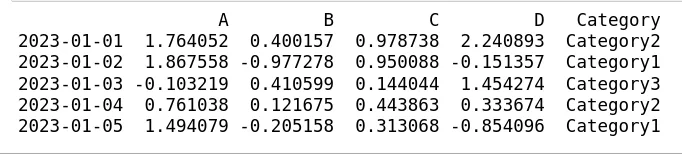
Damit entsteht ein DataFrame mit 100 Zeilen, den Spalten A, B, C und D und einer kategorialen Spalte Category. Die Werte sind zufällig; Category nimmt einen von drei Werten an.
Analyse und Visualisierung
Mit den synthetischen Daten führen wir eine Grundanalyse durch und zeichnen Diagramme.
# Statistical summary
print(df.describe())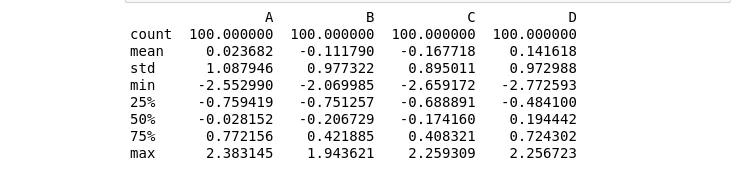
Die Zusammenfassung gibt einen vollständigen Überblick über die Daten. Die Mittelwerte der Spalten A, B, C und D liegen nahe null, wie bei einer zufälligen Normalverteilung zu erwarten ist, und die Standardabweichungen liegen nahe 1, was zeigt, wie stark die Werte um den Mittelwert streuen.
# Grouping and summarizing
grouped = df.groupby('Category').mean()
print(grouped)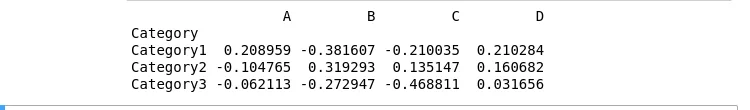
Die Gruppierung nach Category zeigt den Mittelwert jeder Spalte je Kategorie und macht so deutlich, worin sich die Kategorien unterscheiden.
# Visualizing data
df['A'].plot(kind='hist', title='Histogram of A')
plt.show()

sns.boxplot(x='Category', y='B', data=df)
plt.show()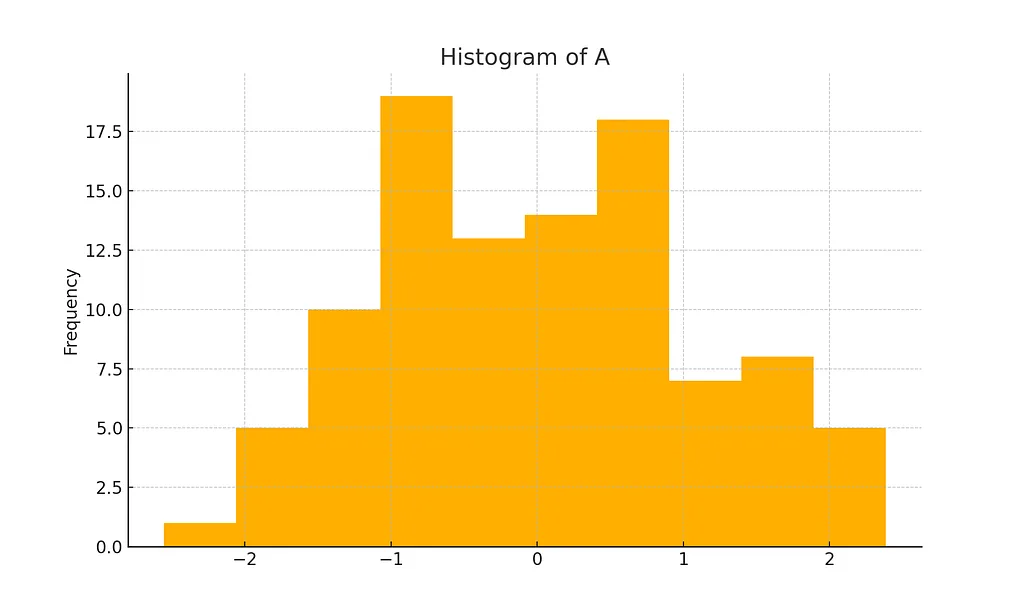
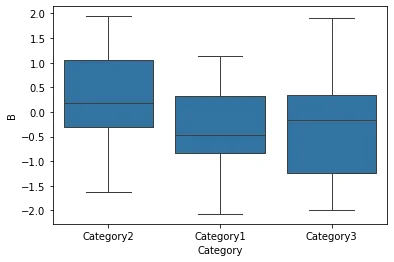
Das Histogramm zeigt die Verteilung der Werte in Spalte A, der Boxplot die Werte der Spalte B in den einzelnen Kategorien. Solche Diagramme helfen, die Verteilung zu verstehen und Ausreißer oder Muster zu erkennen.
Fazit
Pandas ist ein vielseitiges und leistungsfähiges Werkzeug für die Datenanalyse; Flexibilität und einfache Bedienung machen es für Data Scientists unverzichtbar. In diesem Beitrag haben wir die Grundfunktionen von pandas und ihre Rolle in der Datenanalyse behandelt und den praktischen Einsatz anhand synthetischer Daten gezeigt. Mit weiterer Übung und fortgeschritteneren Techniken können Sie tiefer in die Data Science einsteigen und mit pandas mehr Erkenntnisse aus Ihren Daten gewinnen.
Quellen
- McKinney, W. (2010). Data Structures for Statistical Computing in Python. Proceedings of the 9th Python in Science Conference, 51–56.
- McKinney, W. (2017). Python for Data Analysis: Data Wrangling with Pandas, NumPy, and IPython (2. Aufl.). O’Reilly Media.
- The pandas development team. pandas-Dokumentation. pandas.pydata.org
- NumPy-Dokumentation. numpy.org
- Matplotlib-Dokumentation. matplotlib.org
- Seaborn-Dokumentation. seaborn.pydata.org