

Анализа на податоци со Pandas: обработка и визуелизација на податоци
Автор Yasin TANIŞ
Вовед
Анализата на податоци стана неодвоив дел од донесувањето одлуки. Python се истакнува во оваа област благодарение на моќните библиотеки за анализа и обработка на податоци. Една од нив, pandas, е незаменлива за податочните научници бидејќи е флексибилна и лесна за употреба. Во оваа статија ги разгледуваме основните можности на pandas и нејзината употреба во анализата на податоци, со практични примери на вистински или синтетички податоци.
DataFrame и Series
Pandas работи со две основни структури на податоци. DataFrame е дводимензионална структура од редови и колони. Series е еднодимензионална и претставува една колона податоци.
import pandas as pd

# Creating a simple DataFrame
data = {
    'name': ['Alice', 'Bob', 'Charlie'],
    'age': [25, 30, 35],
    'city': ['New York', 'Los Angeles', 'Chicago']
}
df = pd.DataFrame(data)
print(df)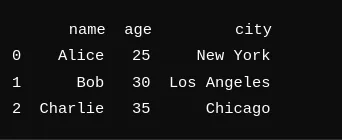
Создавање DataFrame
DataFrame може да се создаде на многу начини. Податоците можете да ги вчитате од извори како CSV, Excel и SQL и да ги претворите во DataFrame.
# Loading data from a CSV file
df = pd.read_csv('data.csv')

# Loading data from an Excel file
df = pd.read_excel('data.xlsx')

# Loading data from an SQL database
import sqlite3
conn = sqlite3.connect('database.db')
df = pd.read_sql_query('SELECT * FROM table', conn)
Вчитување и зачувување податоци
Pandas го поедноставува вчитувањето и зачувувањето податоци. Можете да читате и обработувате датотеки во многу различни формати.
# Saving data
df.to_csv('new_data.csv', index=False)
df.to_excel('new_data.xlsx', index=False)
Чистење и подготовка на податоците
Чистењето и подготовката се клучни чекори во анализата. Pandas ја олеснува работата со недостасувачки вредности, претворањето типови податоци и отстранувањето непотребни податоци.
# Checking for missing values
print(df.isnull().sum())

# Filling missing values
df.fillna(0, inplace=True)

# Converting data types
df['date'] = pd.to_datetime(df['date'])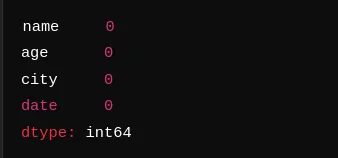
Овде проверуваме дали во DataFrame има недостасувачки вредности. Излезот покажува дека ги нема во ниедна колона.
Статистички резимеа
Pandas нуди многу алатки за брзо сумирање на податоците. Основните статистики и резимеа се добиваат со еден повик.
# Basic statistical summaries
print(df.describe())

# Summarizing specific columns
print(df['age'].mean())
print(df['age'].std())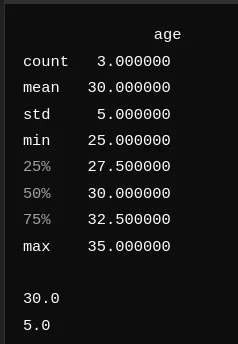
Во резимето просечната возраст е 30, а стандардната девијација 5; најмалата и најголемата возраст се 25 и 35. Тоа дава брз увид во распределбата на возраста во податоците.
Групирање и сумирање
Групирањето и сумирањето се една од силните страни на pandas. Функциите groupby и pivot_table го прават тоа едноставно.
# Grouping and summarizing
group = df.groupby('city')['age'].mean()
print(group)

# Creating a pivot table
pivot = df.pivot_table(values='age', index='city', columns='gender', aggfunc='mean')
print(pivot)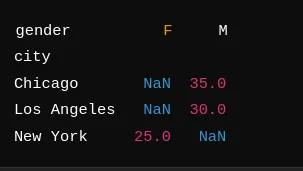
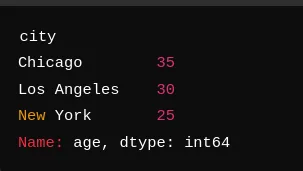
Со групирање по град ја добиваме просечната возраст за секој од нив: Chicago (35), Los Angeles (30) и New York (25). Пивот табелата дава слично резиме поделено по пол; нашиот пример нема податоци за пол, па во тие ќелии стои NaN.
Визуелизација со pandas
Pandas има едноставни, но ефикасни алатки за графикони. Функции како plot, hist и boxplot брзо создаваат графикони.
# Basic plots
df['age'].plot(kind='hist')
df.plot(kind='scatter', x='age', y='income')
Работа со Seaborn и Matplotlib
Податоците од pandas можете да ги визуелизирате и со Seaborn и Matplotlib, кои овозможуваат поприлагодени и подетални графикони.
import seaborn as sns
import matplotlib.pyplot as plt

# Visualizing with Seaborn
sns.boxplot(x='city', y='age', data=df)
plt.show()
Анализа на временски серии
Pandas многу добро работи со временски серии, па трендовите и шемите лесно се откриваат.
# Handling time series data
df['date'] = pd.to_datetime(df['date'])
df.set_index('date', inplace=True)
print(df.resample('M').mean())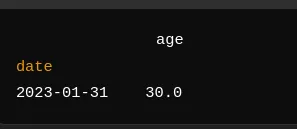
Овде колоната date ја претвораме во datetime и ја поставуваме како индекс. Со месечно повторно земање примероци (resampling) и пресметување на просекот добиваме просечна возраст од 30 години за јануари 2023.
Спојување и комбинирање податоци
Pandas има многу функции за спојување и комбинирање збирки податоци, како merge, join и concat.
# Merging two DataFrames
df1 = pd.DataFrame({'name': ['Alice', 'Bob'], 'age': [25, 30]})
df2 = pd.DataFrame({'name': ['Alice', 'Bob'], 'city': ['New York', 'Los Angeles']})
merged_df = pd.merge(df1, df2, on='name')
print(merged_df)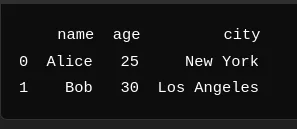
Во овој пример спојуваме два DataFrame по колоната name и ги обединуваме возраста и градот на секое лице.
Практичен пример: анализа со синтетички податоци
Создавање на податоците
За практичен пример создаваме синтетички податоци за да покажеме што може pandas.
import pandas as pd
import numpy as np
import seaborn as sns
import matplotlib.pyplot as plt

# Creating synthetic data
np.random.seed(0)
dates = pd.date_range('20230101', periods=100)
df = pd.DataFrame(np.random.randn(100, 4), index=dates, columns=list('ABCD'))
df['Category'] = np.random.choice(['Category1', 'Category2', 'Category3'], size=100)
print(df.head())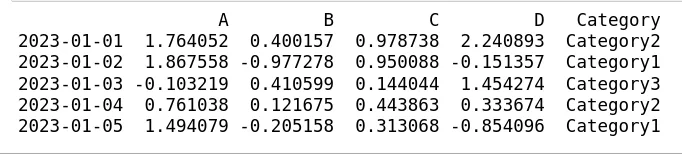
Ова создава DataFrame од 100 редови со колоните A, B, C и D и категориска колона Category. Вредностите се случајни, а Category зема една од три вредности.
Анализа и визуелизација
Со синтетичките податоци правиме основна анализа и цртаме графикони.
# Statistical summary
print(df.describe())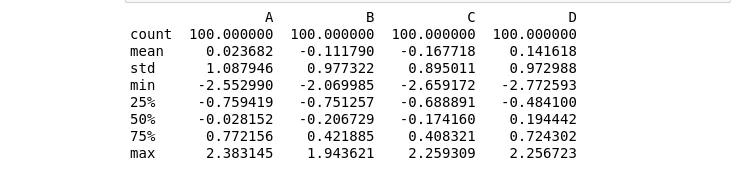
Резимето дава целосен преглед на податоците. Просеците на колоните A, B, C и D се блиску до нула, како што се очекува од случајна нормална распределба, а стандардните девијации се блиску до 1 и покажуваат колку се расфрлани вредностите околу просекот.
# Grouping and summarizing
grouped = df.groupby('Category').mean()
print(grouped)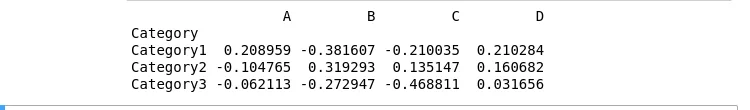
Групирањето по Category го покажува просекот на секоја колона за секоја категорија и открива по што се разликуваат категориите.
# Visualizing data
df['A'].plot(kind='hist', title='Histogram of A')
plt.show()

sns.boxplot(x='Category', y='B', data=df)
plt.show()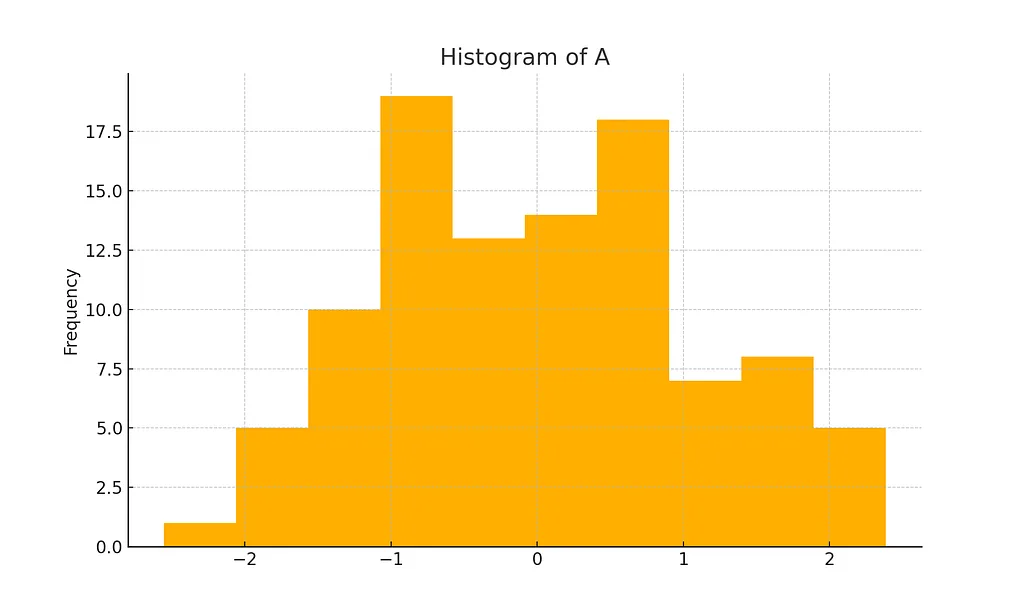
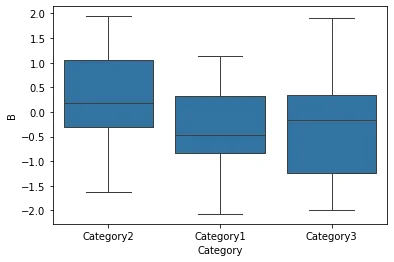
Хистограмот ја покажува распределбата на вредностите во колоната A, а кутиестиот дијаграм колоната B по категории. Ваквите графикони помагаат да ја разберете распределбата и да забележите екстремни вредности или шеми.
Заклучок
Pandas е сестрана и моќна алатка за анализа на податоци; флексибилноста и лесната употреба ја прават незаменлива за податочните научници. Во оваа статија ги обработивме нејзините основни можности и нивното место во анализата и покажавме практична употреба на синтетички податоци. Со повеќе вежбање и понапредни техники можете подлабоко да навлезете во науката за податоци и со pandas да извлечете повеќе увид од своите податоци.
Извори
- McKinney, W. (2010). Data Structures for Statistical Computing in Python. Proceedings of the 9th Python in Science Conference, 51–56.
- McKinney, W. (2017). Python for Data Analysis: Data Wrangling with Pandas, NumPy, and IPython (2. изд.). O’Reilly Media.
- Развојниот тим на pandas. Документација на pandas. pandas.pydata.org
- Документација на NumPy. numpy.org
- Документација на Matplotlib. matplotlib.org
- Документација на Seaborn. seaborn.pydata.org