

Ανάλυση δεδομένων με Pandas: επεξεργασία και οπτικοποίηση δεδομένων
Γράφει Yasin TANIŞ
Εισαγωγή
Η ανάλυση δεδομένων έχει γίνει αναπόσπαστο μέρος της λήψης αποφάσεων. Η Python ξεχωρίζει σε αυτό το πεδίο χάρη στις ισχυρές βιβλιοθήκες της για ανάλυση και επεξεργασία δεδομένων. Μία από αυτές, η pandas, είναι απαραίτητη για τους επιστήμονες δεδομένων, επειδή είναι ευέλικτη και εύκολη στη χρήση. Σε αυτό το άρθρο εξετάζουμε τις βασικές δυνατότητες της pandas και τη χρήση της στην ανάλυση δεδομένων, με πρακτικά παραδείγματα σε πραγματικά ή συνθετικά δεδομένα.
DataFrame και Series
Η pandas δουλεύει με δύο βασικές δομές δεδομένων. Το DataFrame είναι μια δισδιάστατη δομή από γραμμές και στήλες. Η Series είναι μονοδιάστατη και αναπαριστά μία στήλη δεδομένων.
import pandas as pd

# Creating a simple DataFrame
data = {
    'name': ['Alice', 'Bob', 'Charlie'],
    'age': [25, 30, 35],
    'city': ['New York', 'Los Angeles', 'Chicago']
}
df = pd.DataFrame(data)
print(df)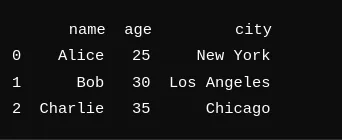
Δημιουργία DataFrame
Ένα DataFrame μπορεί να δημιουργηθεί με πολλούς τρόπους. Μπορείτε να φορτώσετε δεδομένα από πηγές όπως CSV, Excel και SQL και να τα μετατρέψετε σε DataFrame.
# Loading data from a CSV file
df = pd.read_csv('data.csv')

# Loading data from an Excel file
df = pd.read_excel('data.xlsx')

# Loading data from an SQL database
import sqlite3
conn = sqlite3.connect('database.db')
df = pd.read_sql_query('SELECT * FROM table', conn)
Φόρτωση και αποθήκευση δεδομένων
Η pandas κάνει απλή τη φόρτωση και την αποθήκευση δεδομένων. Μπορείτε να διαβάζετε και να επεξεργάζεστε αρχεία σε πολλές διαφορετικές μορφές.
# Saving data
df.to_csv('new_data.csv', index=False)
df.to_excel('new_data.xlsx', index=False)
Καθαρισμός και προετοιμασία δεδομένων
Ο καθαρισμός και η προετοιμασία είναι κρίσιμα βήματα της ανάλυσης δεδομένων. Η pandas διευκολύνει τον χειρισμό των ελλειπουσών τιμών, τη μετατροπή τύπων δεδομένων και την αφαίρεση δεδομένων που δεν χρειάζεστε.
# Checking for missing values
print(df.isnull().sum())

# Filling missing values
df.fillna(0, inplace=True)

# Converting data types
df['date'] = pd.to_datetime(df['date'])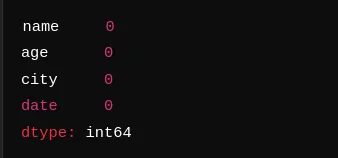
Εδώ ελέγχουμε αν το DataFrame έχει ελλείπουσες τιμές. Η έξοδος δείχνει ότι δεν υπάρχουν σε καμία στήλη.
Στατιστικές συνόψεις
Η pandas προσφέρει πολλά εργαλεία για τη γρήγορη σύνοψη δεδομένων. Τα βασικά στατιστικά μέτρα και οι συνόψεις λαμβάνονται με μία μόνο κλήση.
# Basic statistical summaries
print(df.describe())

# Summarizing specific columns
print(df['age'].mean())
print(df['age'].std())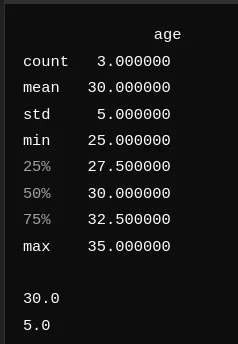
Στη σύνοψη η μέση ηλικία είναι 30 με τυπική απόκλιση 5· η μικρότερη και η μεγαλύτερη ηλικία είναι 25 και 35. Έτσι παίρνουμε μια γρήγορη εικόνα της κατανομής των ηλικιών στα δεδομένα.
Ομαδοποίηση και σύνοψη
Η ομαδοποίηση και η σύνοψη είναι από τα δυνατά σημεία της pandas. Οι συναρτήσεις groupby και pivot_table την κάνουν απλή υπόθεση.
# Grouping and summarizing
group = df.groupby('city')['age'].mean()
print(group)

# Creating a pivot table
pivot = df.pivot_table(values='age', index='city', columns='gender', aggfunc='mean')
print(pivot)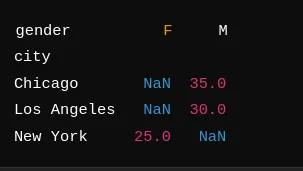
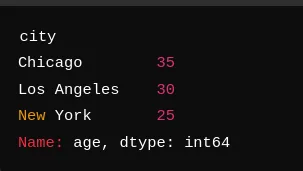
Ομαδοποιώντας ανά πόλη παίρνουμε τη μέση ηλικία για καθεμία: Chicago (35), Los Angeles (30) και New York (25). Ο συγκεντρωτικός πίνακας δίνει παρόμοια σύνοψη, αναλυμένη ανά φύλο· το παράδειγμά μας δεν περιέχει δεδομένα φύλου, γι’ αυτό τα αντίστοιχα κελιά δείχνουν NaN.
Οπτικοποίηση δεδομένων με την pandas
Η pandas διαθέτει απλά αλλά αποτελεσματικά εργαλεία γραφημάτων. Συναρτήσεις όπως plot, hist και boxplot φτιάχνουν γρήγορα γραφήματα.
# Basic plots
df['age'].plot(kind='hist')
df.plot(kind='scatter', x='age', y='income')
Χρήση της Seaborn και της Matplotlib
Μπορείτε επίσης να οπτικοποιήσετε δεδομένα της pandas με τη Seaborn και τη Matplotlib, οι οποίες επιτρέπουν πιο προσαρμοσμένα και λεπτομερή γραφήματα.
import seaborn as sns
import matplotlib.pyplot as plt

# Visualizing with Seaborn
sns.boxplot(x='city', y='age', data=df)
plt.show()
Ανάλυση χρονοσειρών
Η pandas χειρίζεται πολύ καλά τα δεδομένα χρονοσειρών, γεγονός που διευκολύνει τον εντοπισμό τάσεων και μοτίβων.
# Handling time series data
df['date'] = pd.to_datetime(df['date'])
df.set_index('date', inplace=True)
print(df.resample('M').mean())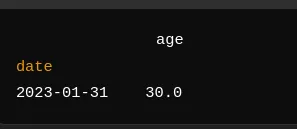
Εδώ μετατρέπουμε τη στήλη date σε datetime και την ορίζουμε ως δείκτη. Με επαναδειγματοληψία ανά μήνα και υπολογισμό του μέσου όρου παίρνουμε μέση ηλικία 30 για τον Ιανουάριο του 2023.
Συγχώνευση και συνδυασμός δεδομένων
Η pandas διαθέτει πολλές συναρτήσεις για τη συγχώνευση και τον συνδυασμό συνόλων δεδομένων, όπως merge, join και concat.
# Merging two DataFrames
df1 = pd.DataFrame({'name': ['Alice', 'Bob'], 'age': [25, 30]})
df2 = pd.DataFrame({'name': ['Alice', 'Bob'], 'city': ['New York', 'Los Angeles']})
merged_df = pd.merge(df1, df2, on='name')
print(merged_df)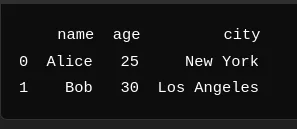
Σε αυτό το παράδειγμα συγχωνεύουμε δύο DataFrame με βάση τη στήλη name, συνδυάζοντας την ηλικία και την πόλη κάθε ατόμου.
Πρακτικό παράδειγμα: ανάλυση με συνθετικά δεδομένα
Δημιουργία των δεδομένων
Για ένα πρακτικό παράδειγμα δημιουργούμε συνθετικά δεδομένα, για να δείξουμε τι μπορεί να κάνει η pandas.
import pandas as pd
import numpy as np
import seaborn as sns
import matplotlib.pyplot as plt

# Creating synthetic data
np.random.seed(0)
dates = pd.date_range('20230101', periods=100)
df = pd.DataFrame(np.random.randn(100, 4), index=dates, columns=list('ABCD'))
df['Category'] = np.random.choice(['Category1', 'Category2', 'Category3'], size=100)
print(df.head())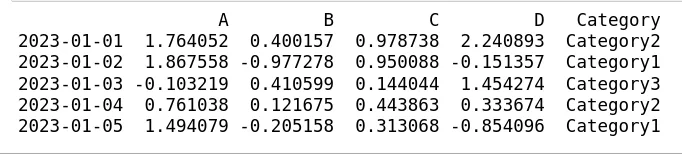
Έτσι δημιουργείται ένα DataFrame 100 γραμμών με στήλες A, B, C και D και μια κατηγορική στήλη Category. Οι τιμές είναι τυχαίες και η Category παίρνει μία από τρεις τιμές.
Ανάλυση και οπτικοποίηση
Με τα συνθετικά δεδομένα κάνουμε ορισμένες βασικές αναλύσεις και σχεδιάζουμε γραφήματα.
# Statistical summary
print(df.describe())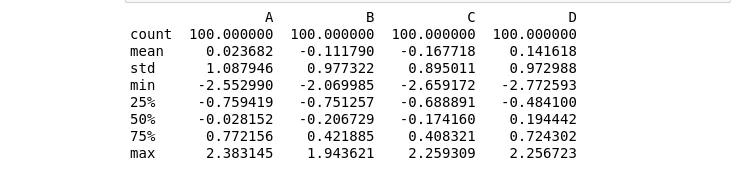
Η σύνοψη δίνει πλήρη εικόνα των δεδομένων. Οι μέσοι όροι των στηλών A, B, C και D είναι κοντά στο μηδέν, όπως αναμένεται από μια τυχαία κανονική κατανομή, και οι τυπικές αποκλίσεις είναι κοντά στο 1, δείχνοντας πόσο διασπείρονται οι τιμές γύρω από τον μέσο όρο.
# Grouping and summarizing
grouped = df.groupby('Category').mean()
print(grouped)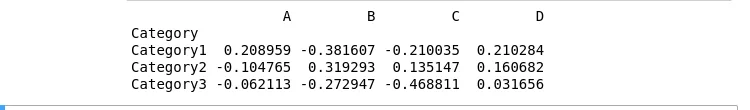
Η ομαδοποίηση ανά Category δείχνει τον μέσο όρο κάθε στήλης για κάθε κατηγορία, κάτι που αποκαλύπτει πώς διαφέρουν οι κατηγορίες.
# Visualizing data
df['A'].plot(kind='hist', title='Histogram of A')
plt.show()

sns.boxplot(x='Category', y='B', data=df)
plt.show()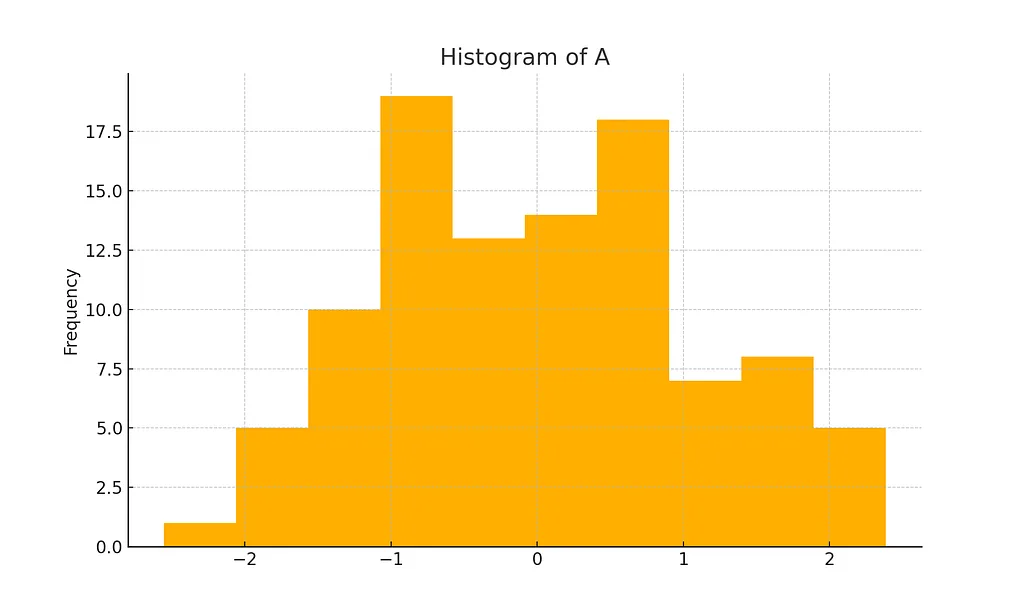
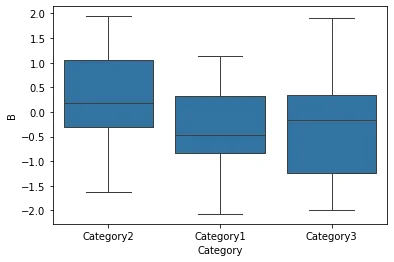
Το ιστόγραμμα δείχνει την κατανομή των τιμών της στήλης A, ενώ το θηκόγραμμα δείχνει τη στήλη B στις διάφορες κατηγορίες. Τέτοια γραφήματα σας βοηθούν να κατανοήσετε την κατανομή και να εντοπίσετε ακραίες τιμές ή μοτίβα.
Συμπέρασμα
Η pandas είναι ένα ευέλικτο και ισχυρό εργαλείο ανάλυσης δεδομένων· η ευελιξία και η ευκολία χρήσης της την κάνουν απαραίτητη για τους επιστήμονες δεδομένων. Σε αυτό το άρθρο καλύψαμε τις βασικές της δυνατότητες και πώς εντάσσονται σε μια ανάλυση και δείξαμε την πρακτική χρήση τους σε συνθετικά δεδομένα. Με περισσότερη εξάσκηση και πιο προχωρημένες τεχνικές, μπορείτε να εμβαθύνετε στην επιστήμη δεδομένων και να αντλείτε περισσότερα συμπεράσματα από τα δεδομένα σας με την pandas.
Πηγές
- McKinney, W. (2010). Data Structures for Statistical Computing in Python. Proceedings of the 9th Python in Science Conference, 51–56.
- McKinney, W. (2017). Python for Data Analysis: Data Wrangling with Pandas, NumPy, and IPython (2η έκδ.). O’Reilly Media.
- Η ομάδα ανάπτυξης της pandas. Τεκμηρίωση της pandas. pandas.pydata.org
- Τεκμηρίωση του NumPy. numpy.org
- Τεκμηρίωση της Matplotlib. matplotlib.org
- Τεκμηρίωση της Seaborn. seaborn.pydata.org