

Анализ данных с помощью pandas: обработка и визуализация данных
Автор: Yasin TANIŞ
Введение
Анализ данных стал неотъемлемой частью принятия решений. Python выделяется в этой области благодаря мощным библиотекам для анализа и обработки данных. Одна из них, pandas, незаменима для специалистов по данным, благодаря гибкости и простоте использования. В этой статье мы рассмотрим основные возможности pandas и их применение в анализе данных на практических примерах с реальными или синтетическими данными.
DataFrame и Series
Pandas работает с двумя основными структурами данных. DataFrame — двумерная структура из строк и столбцов. Series — одномерная структура, представляющая один столбец данных.
import pandas as pd

# Creating a simple DataFrame
data = {
    'name': ['Alice', 'Bob', 'Charlie'],
    'age': [25, 30, 35],
    'city': ['New York', 'Los Angeles', 'Chicago']
}
df = pd.DataFrame(data)
print(df)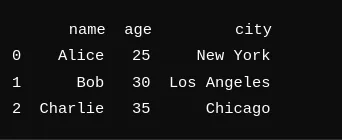
Создание DataFrame
Создать DataFrame можно многими способами. Данные можно загрузить из таких источников, как CSV, Excel и SQL, и превратить их в DataFrame.
# Loading data from a CSV file
df = pd.read_csv('data.csv')

# Loading data from an Excel file
df = pd.read_excel('data.xlsx')

# Loading data from an SQL database
import sqlite3
conn = sqlite3.connect('database.db')
df = pd.read_sql_query('SELECT * FROM table', conn)
Загрузка и сохранение данных
Pandas упрощает загрузку и сохранение данных. Можно читать и обрабатывать файлы во многих форматах.
# Saving data
df.to_csv('new_data.csv', index=False)
df.to_excel('new_data.xlsx', index=False)
Очистка и подготовка данных
Очистка и подготовка — ключевые этапы анализа данных. Pandas упрощает работу с пропущенными значениями, преобразование типов данных и удаление ненужных данных.
# Checking for missing values
print(df.isnull().sum())

# Filling missing values
df.fillna(0, inplace=True)

# Converting data types
df['date'] = pd.to_datetime(df['date'])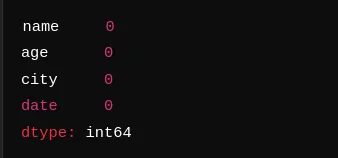
Здесь мы проверяем, есть ли в DataFrame пропущенные значения. Вывод показывает, что их нет ни в одном столбце.
Статистические сводки
В pandas много инструментов для быстрого получения сводок по данным. Базовую статистику можно получить одним вызовом.
# Basic statistical summaries
print(df.describe())

# Summarizing specific columns
print(df['age'].mean())
print(df['age'].std())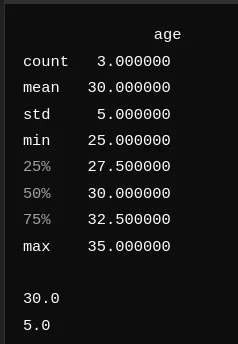
В сводке средний возраст — 30 лет при стандартном отклонении 5; минимальный и максимальный возраст — 25 и 35 лет. Это даёт быстрое представление о распределении возраста.
Группировка и агрегирование
Группировка и агрегирование — одна из сильных сторон pandas. Функции groupby и pivot_table заметно упрощают эту задачу.
# Grouping and summarizing
group = df.groupby('city')['age'].mean()
print(group)

# Creating a pivot table
pivot = df.pivot_table(values='age', index='city', columns='gender', aggfunc='mean')
print(pivot)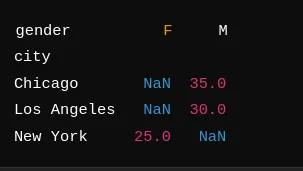
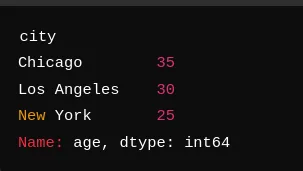
Группировка по городу даёт средний возраст для каждого: Chicago (35), Los Angeles (30) и New York (25). Сводная таблица показывает аналогичные данные с разбивкой по полу; в нашем примере нет данных о поле, поэтому в этих ячейках стоит NaN.
Визуализация данных в pandas
В pandas есть простые, но эффективные инструменты построения графиков. Функции plot, hist и boxplot быстро строят графики.
# Basic plots
df['age'].plot(kind='hist')
df.plot(kind='scatter', x='age', y='income')
Работа с Seaborn и Matplotlib
Данные pandas можно визуализировать и с помощью Seaborn и Matplotlib, которые дают более гибкие и подробные графики.
import seaborn as sns
import matplotlib.pyplot as plt

# Visualizing with Seaborn
sns.boxplot(x='city', y='age', data=df)
plt.show()
Анализ временных рядов
Pandas отлично справляется с временными рядами, поэтому в них легко находить тренды и закономерности.
# Handling time series data
df['date'] = pd.to_datetime(df['date'])
df.set_index('date', inplace=True)
print(df.resample('M').mean())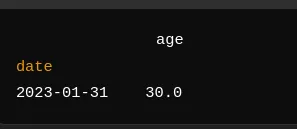
Здесь мы преобразуем столбец date в datetime и делаем его индексом. Ресемплинг по месяцам с усреднением даёт средний возраст 30 лет за январь 2023 года.
Объединение данных
В pandas много функций для объединения наборов данных, например merge, join и concat.
# Merging two DataFrames
df1 = pd.DataFrame({'name': ['Alice', 'Bob'], 'age': [25, 30]})
df2 = pd.DataFrame({'name': ['Alice', 'Bob'], 'city': ['New York', 'Los Angeles']})
merged_df = pd.merge(df1, df2, on='name')
print(merged_df)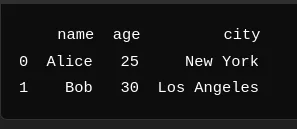
В этом примере мы объединяем два DataFrame по столбцу name, сводя возраст и город каждого человека.
Практический пример: анализ синтетических данных
Создание данных
Для практического примера создадим синтетические данные, которые покажут возможности pandas.
import pandas as pd
import numpy as np
import seaborn as sns
import matplotlib.pyplot as plt

# Creating synthetic data
np.random.seed(0)
dates = pd.date_range('20230101', periods=100)
df = pd.DataFrame(np.random.randn(100, 4), index=dates, columns=list('ABCD'))
df['Category'] = np.random.choice(['Category1', 'Category2', 'Category3'], size=100)
print(df.head())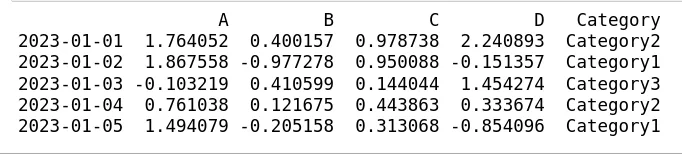
Так создаётся DataFrame из 100 строк со столбцами A, B, C и D и категориальным столбцом Category. Значения случайны, а Category принимает одно из трёх значений.
Анализ и визуализация
На синтетических данных проведём базовый анализ и построим графики.
# Statistical summary
print(df.describe())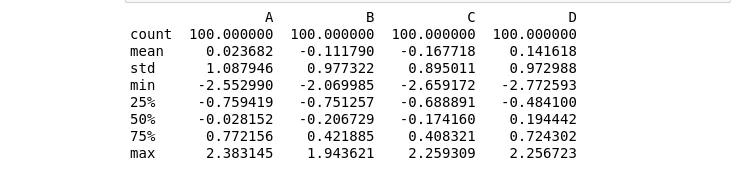
Сводка даёт полный обзор данных. Средние столбцов A, B, C и D близки к нулю, как и ожидается для случайного нормального распределения, а стандартные отклонения близки к 1 и показывают разброс значений вокруг среднего.
# Grouping and summarizing
grouped = df.groupby('Category').mean()
print(grouped)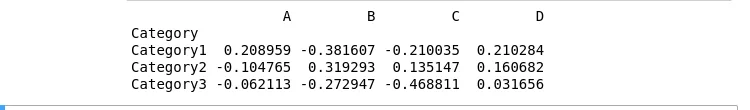
Группировка по Category показывает среднее каждого столбца по категориям и позволяет увидеть, чем они отличаются.
# Visualizing data
df['A'].plot(kind='hist', title='Histogram of A')
plt.show()

sns.boxplot(x='Category', y='B', data=df)
plt.show()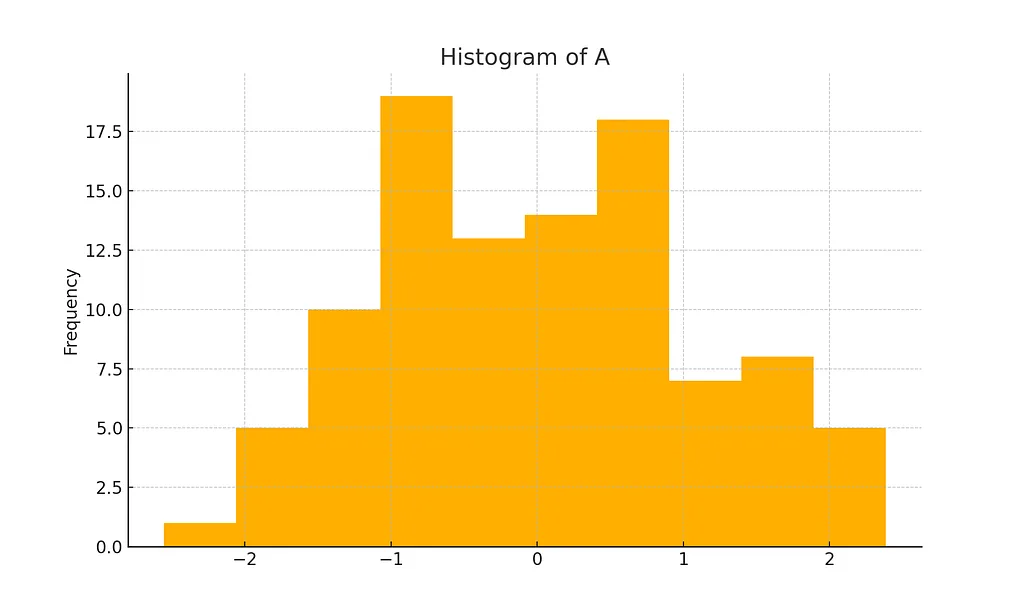
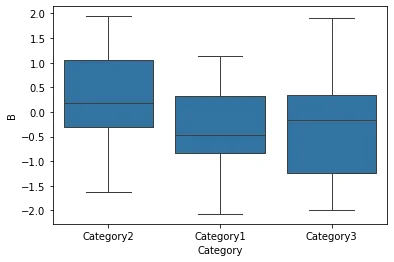
Гистограмма показывает распределение значений в столбце A, а ящичковая диаграмма — столбец B по категориям. Такие графики помогают понять распределение и заметить выбросы или закономерности.
Заключение
Pandas — универсальный и мощный инструмент анализа данных; гибкость и простота делают его незаменимым для специалистов по данным. В этой статье мы рассмотрели его основные возможности и их роль в анализе, а также показали практическое применение на синтетических данных. С практикой и более продвинутыми приёмами вы сможете глубже погрузиться в науку о данных и с помощью pandas извлекать из данных больше полезных выводов.
Источники
- McKinney, W. (2010). Data Structures for Statistical Computing in Python. Proceedings of the 9th Python in Science Conference, 51–56.
- McKinney, W. (2017). Python for Data Analysis: Data Wrangling with Pandas, NumPy, and IPython (2-е изд.). O’Reilly Media.
- Команда разработчиков pandas. Документация pandas. pandas.pydata.org
- Документация NumPy. numpy.org
- Документация Matplotlib. matplotlib.org
- Документация Seaborn. seaborn.pydata.org