

Analiza e të dhënave me Pandas: përpunimi dhe vizualizimi i të dhënave
Shkruar nga Yasin TANIŞ
Hyrje
Analiza e të dhënave është bërë pjesë e pandarë e vendimmarrjes. Python dallohet në këtë fushë falë bibliotekave të fuqishme për analizën dhe përpunimin e të dhënave. Njëra prej tyre, pandas, është e domosdoshme për shkencëtarët e të dhënave, sepse është fleksibile dhe e lehtë për t’u përdorur. Në këtë artikull shohim veçoritë bazë të pandas dhe si përdoret ajo në analizën e të dhënave, me shembuj praktikë mbi të dhëna reale ose sintetike.
DataFrame dhe Series
Pandas punon me dy struktura kryesore të dhënash. DataFrame është një strukturë dydimensionale me rreshta dhe kolona. Series është njëdimensionale dhe përfaqëson një kolonë të vetme të dhënash.
import pandas as pd

# Creating a simple DataFrame
data = {
    'name': ['Alice', 'Bob', 'Charlie'],
    'age': [25, 30, 35],
    'city': ['New York', 'Los Angeles', 'Chicago']
}
df = pd.DataFrame(data)
print(df)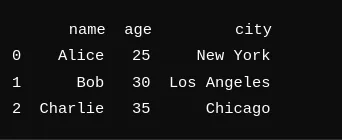
Krijimi i DataFrame-ve
Një DataFrame mund të krijohet në shumë mënyra. Mund të ngarkoni të dhëna nga burime si CSV, Excel dhe SQL dhe t’i ktheni në DataFrame.
# Loading data from a CSV file
df = pd.read_csv('data.csv')

# Loading data from an Excel file
df = pd.read_excel('data.xlsx')

# Loading data from an SQL database
import sqlite3
conn = sqlite3.connect('database.db')
df = pd.read_sql_query('SELECT * FROM table', conn)
Ngarkimi dhe ruajtja e të dhënave
Pandas e thjeshton ngarkimin dhe ruajtjen e të dhënave. Mund të lexoni dhe të përpunoni skedarë në shumë formate të ndryshme.
# Saving data
df.to_csv('new_data.csv', index=False)
df.to_excel('new_data.xlsx', index=False)
Pastrimi dhe përgatitja e të dhënave
Pastrimi dhe përgatitja janë hapa kritikë në analizën e të dhënave. Pandas e lehtëson trajtimin e vlerave që mungojnë, konvertimin e llojeve të të dhënave dhe heqjen e të dhënave që nuk ju nevojiten.
# Checking for missing values
print(df.isnull().sum())

# Filling missing values
df.fillna(0, inplace=True)

# Converting data types
df['date'] = pd.to_datetime(df['date'])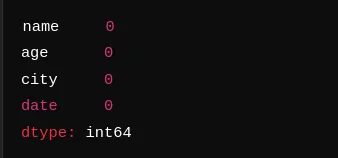
Këtu kontrollojmë nëse DataFrame-i ka vlera që mungojnë. Rezultati tregon se asnjë kolonë nuk ka vlera që mungojnë.
Përmbledhjet statistikore
Pandas ofron shumë mjete për të përmbledhur shpejt të dhënat. Statistikat dhe përmbledhjet bazë merren me një thirrje të vetme.
# Basic statistical summaries
print(df.describe())

# Summarizing specific columns
print(df['age'].mean())
print(df['age'].std())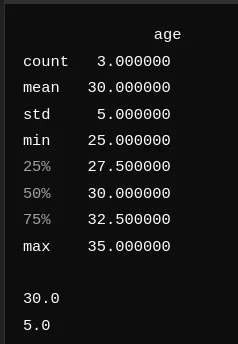
Në përmbledhje, mosha mesatare është 30 dhe devijimi standard 5; mosha minimale dhe maksimale janë 25 dhe 35. Kjo jep një pamje të shpejtë të shpërndarjes së moshës në të dhëna.
Grupimi dhe përmbledhja
Grupimi dhe përmbledhja janë ndër pikat e forta të pandas. Funksionet groupby dhe pivot_table e bëjnë këtë të thjeshtë.
# Grouping and summarizing
group = df.groupby('city')['age'].mean()
print(group)

# Creating a pivot table
pivot = df.pivot_table(values='age', index='city', columns='gender', aggfunc='mean')
print(pivot)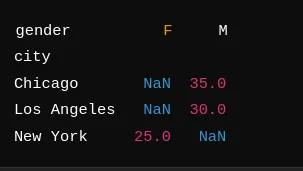
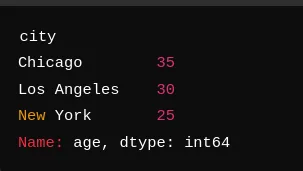
Duke grupuar sipas qytetit marrim moshën mesatare për secilin: Chicago (35), Los Angeles (30) dhe New York (25). Tabela pivot jep një përmbledhje të ngjashme sipas gjinisë; shembulli ynë nuk ka të dhëna për gjininë, ndaj ato qeliza tregojnë NaN.
Vizualizimi i të dhënave me pandas
Pandas ka mjete të thjeshta, por efektive për grafikë. Funksione si plot, hist dhe boxplot krijojnë grafikë shpejt.
# Basic plots
df['age'].plot(kind='hist')
df.plot(kind='scatter', x='age', y='income')
Puna me Seaborn dhe Matplotlib
Të dhënat e pandas mund t’i vizualizoni edhe me Seaborn dhe Matplotlib, që lejojnë grafikë më të përshtatur dhe më të detajuar.
import seaborn as sns
import matplotlib.pyplot as plt

# Visualizing with Seaborn
sns.boxplot(x='city', y='age', data=df)
plt.show()
Analiza e serive kohore
Pandas punon shumë mirë me të dhëna të serive kohore, gjë që i bën prirjet dhe modelet të lehta për t’u gjetur.
# Handling time series data
df['date'] = pd.to_datetime(df['date'])
df.set_index('date', inplace=True)
print(df.resample('M').mean())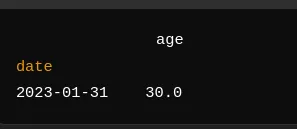
Këtu e kthejmë kolonën date në datetime dhe e vendosim si indeks. Duke rimostruar sipas muajit dhe duke marrë mesataren, marrim një moshë mesatare prej 30 për janarin 2023.
Bashkimi dhe kombinimi i të dhënave
Pandas ka shumë funksione për bashkimin dhe kombinimin e grupeve të të dhënave, si merge, join dhe concat.
# Merging two DataFrames
df1 = pd.DataFrame({'name': ['Alice', 'Bob'], 'age': [25, 30]})
df2 = pd.DataFrame({'name': ['Alice', 'Bob'], 'city': ['New York', 'Los Angeles']})
merged_df = pd.merge(df1, df2, on='name')
print(merged_df)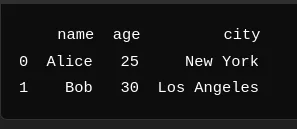
Në këtë shembull bashkojmë dy DataFrame sipas kolonës name, duke kombinuar moshën dhe qytetin e secilit person.
Shembull praktik: analizë me të dhëna sintetike
Krijimi i të dhënave
Për një shembull praktik krijojmë të dhëna sintetike, për të treguar çfarë mund të bëjë pandas.
import pandas as pd
import numpy as np
import seaborn as sns
import matplotlib.pyplot as plt

# Creating synthetic data
np.random.seed(0)
dates = pd.date_range('20230101', periods=100)
df = pd.DataFrame(np.random.randn(100, 4), index=dates, columns=list('ABCD'))
df['Category'] = np.random.choice(['Category1', 'Category2', 'Category3'], size=100)
print(df.head())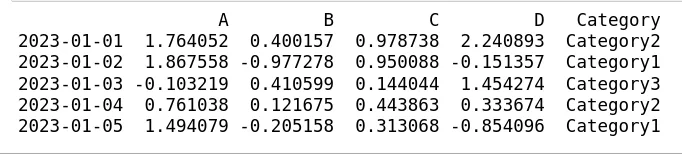
Kjo krijon një DataFrame me 100 rreshta, me kolonat A, B, C dhe D dhe kolonën kategorike Category. Vlerat janë të rastësishme dhe Category merr një nga tri vlera.
Analiza dhe vizualizimi
Me të dhënat sintetike bëjmë disa analiza bazë dhe vizatojmë grafikë.
# Statistical summary
print(df.describe())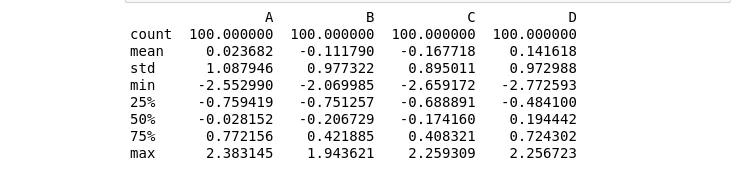
Përmbledhja jep një pamje të plotë të të dhënave. Mesataret e kolonave A, B, C dhe D janë afër zeros, siç pritet nga një shpërndarje normale e rastësishme, dhe devijimet standarde janë afër 1, gjë që tregon sa gjerësisht shpërndahen vlerat rreth mesatares.
# Grouping and summarizing
grouped = df.groupby('Category').mean()
print(grouped)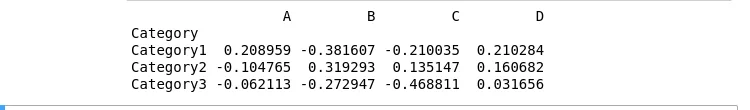
Grupimi sipas Category tregon mesataren e çdo kolone për secilën kategori, gjë që zbulon si ndryshojnë kategoritë mes tyre.
# Visualizing data
df['A'].plot(kind='hist', title='Histogram of A')
plt.show()

sns.boxplot(x='Category', y='B', data=df)
plt.show()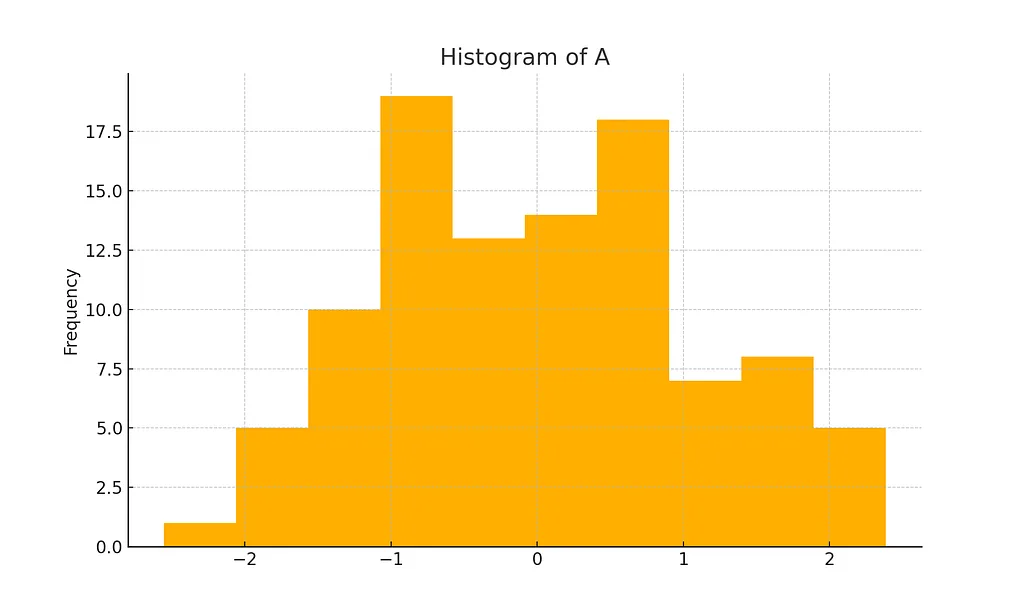
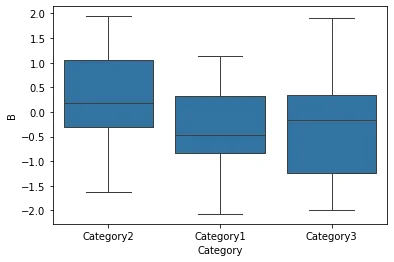
Histogrami tregon si shpërndahen vlerat në kolonën A, ndërsa grafiku me kuti tregon kolonën B sipas kategorive. Grafikë të tillë ju ndihmojnë të kuptoni shpërndarjen dhe të dalloni vlera të skajshme (outliers) ose modele.
Përfundim
Pandas është një mjet i gjithanshëm dhe i fuqishëm për analizën e të dhënave; fleksibiliteti dhe lehtësia e përdorimit e bëjnë të domosdoshëm për shkencëtarët e të dhënave. Në këtë artikull trajtuam veçoritë e tij bazë dhe vendin e tyre në një analizë, si dhe treguam përdorimin praktik me të dhëna sintetike. Me më shumë praktikë dhe me teknika më të avancuara, mund të futeni më thellë në shkencën e të dhënave dhe të nxirrni më shumë njohuri nga të dhënat tuaja me pandas.
Burimet
- McKinney, W. (2010). Data Structures for Statistical Computing in Python. Proceedings of the 9th Python in Science Conference, 51–56.
- McKinney, W. (2017). Python for Data Analysis: Data Wrangling with Pandas, NumPy, and IPython (bot. 2). O’Reilly Media.
- Ekipi i zhvillimit të pandas. Dokumentacioni i pandas. pandas.pydata.org
- Dokumentacioni i NumPy. numpy.org
- Dokumentacioni i Matplotlib. matplotlib.org
- Dokumentacioni i Seaborn. seaborn.pydata.org