

Analyse de données avec pandas : manipuler et visualiser les données
Par Yasin TANIŞ
Introduction
L’analyse de données fait désormais partie intégrante de la prise de décision. Python se distingue dans ce domaine grâce à de puissantes bibliothèques d’analyse et de manipulation de données. L’une d’elles, pandas, est indispensable aux data scientists, car elle est souple et facile à utiliser. Dans cet article, nous présentons les fonctionnalités essentielles de pandas et leur utilisation en analyse de données, avec des exemples pratiques sur des données réelles ou synthétiques.
DataFrame et Series
Pandas repose sur deux structures de données principales. Un DataFrame est une structure bidimensionnelle composée de lignes et de colonnes. Une Series est unidimensionnelle et représente une seule colonne de données.
import pandas as pd

# Creating a simple DataFrame
data = {
    'name': ['Alice', 'Bob', 'Charlie'],
    'age': [25, 30, 35],
    'city': ['New York', 'Los Angeles', 'Chicago']
}
df = pd.DataFrame(data)
print(df)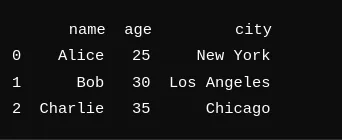
Créer des DataFrames
Il existe de nombreuses façons de créer un DataFrame. Vous pouvez charger des données depuis des sources comme CSV, Excel ou SQL, puis les convertir en DataFrame.
# Loading data from a CSV file
df = pd.read_csv('data.csv')

# Loading data from an Excel file
df = pd.read_excel('data.xlsx')

# Loading data from an SQL database
import sqlite3
conn = sqlite3.connect('database.db')
df = pd.read_sql_query('SELECT * FROM table', conn)
Charger et enregistrer des données
Pandas simplifie le chargement et l’enregistrement des données. Vous pouvez lire et traiter des fichiers dans de nombreux formats différents.
# Saving data
df.to_csv('new_data.csv', index=False)
df.to_excel('new_data.xlsx', index=False)
Nettoyer et préparer les données
Le nettoyage et la préparation sont des étapes cruciales de l’analyse de données. Pandas facilite la gestion des valeurs manquantes, la conversion des types de données et la suppression des données superflues.
# Checking for missing values
print(df.isnull().sum())

# Filling missing values
df.fillna(0, inplace=True)

# Converting data types
df['date'] = pd.to_datetime(df['date'])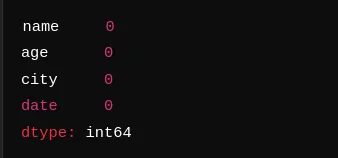
Ici, nous vérifions si le DataFrame contient des valeurs manquantes. La sortie montre qu’aucune colonne n’en contient.
Résumés statistiques
Pandas offre de nombreux outils pour résumer rapidement les données. Statistiques de base et résumés s’obtiennent en un seul appel.
# Basic statistical summaries
print(df.describe())

# Summarizing specific columns
print(df['age'].mean())
print(df['age'].std())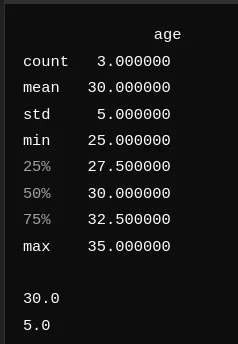
Dans ce résumé, l’âge moyen est de 30 ans avec un écart type de 5 ; les âges minimum et maximum sont 25 et 35 ans. Cela donne un aperçu rapide de la répartition des âges dans les données.
Regrouper et résumer
Le regroupement et la synthèse font partie des points forts de pandas. Les fonctions groupby et pivot_table rendent ces opérations simples.
# Grouping and summarizing
group = df.groupby('city')['age'].mean()
print(group)

# Creating a pivot table
pivot = df.pivot_table(values='age', index='city', columns='gender', aggfunc='mean')
print(pivot)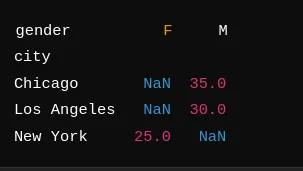
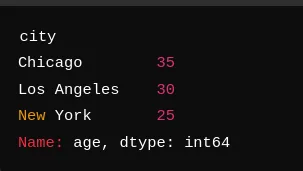
En regroupant par ville, on obtient l’âge moyen de chacune : Chicago (35), Los Angeles (30) et New York (25). Le tableau croisé donne une synthèse similaire ventilée par genre ; notre exemple ne contenant aucune donnée de genre, ces cellules affichent NaN.
Visualiser des données avec pandas
Pandas propose des outils graphiques simples mais efficaces. Des fonctions comme plot, hist et boxplot produisent rapidement des graphiques.
# Basic plots
df['age'].plot(kind='hist')
df.plot(kind='scatter', x='age', y='income')
Utiliser Seaborn et Matplotlib
Vous pouvez aussi visualiser les données de pandas avec Seaborn et Matplotlib, qui permettent des graphiques plus personnalisés et plus détaillés.
import seaborn as sns
import matplotlib.pyplot as plt

# Visualizing with Seaborn
sns.boxplot(x='city', y='age', data=df)
plt.show()
Analyse de séries temporelles
Pandas gère très bien les données de séries temporelles, ce qui facilite la détection de tendances et de motifs.
# Handling time series data
df['date'] = pd.to_datetime(df['date'])
df.set_index('date', inplace=True)
print(df.resample('M').mean())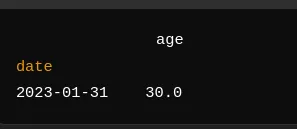
Ici, nous convertissons la colonne date au format datetime et la définissons comme index. Un rééchantillonnage par mois suivi du calcul de la moyenne donne un âge moyen de 30 ans pour janvier 2023.
Fusionner et combiner des données
Pandas propose de nombreuses fonctions pour fusionner et combiner des jeux de données, comme merge, join et concat.
# Merging two DataFrames
df1 = pd.DataFrame({'name': ['Alice', 'Bob'], 'age': [25, 30]})
df2 = pd.DataFrame({'name': ['Alice', 'Bob'], 'city': ['New York', 'Los Angeles']})
merged_df = pd.merge(df1, df2, on='name')
print(merged_df)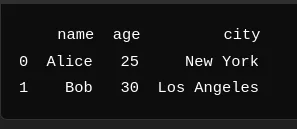
Dans cet exemple, nous fusionnons deux DataFrames sur la colonne name pour réunir l’âge et la ville de chaque personne.
Exemple pratique : analyse de données synthétiques
Créer les données
Pour un exemple pratique, nous créons des données synthétiques afin de montrer ce que pandas sait faire.
import pandas as pd
import numpy as np
import seaborn as sns
import matplotlib.pyplot as plt

# Creating synthetic data
np.random.seed(0)
dates = pd.date_range('20230101', periods=100)
df = pd.DataFrame(np.random.randn(100, 4), index=dates, columns=list('ABCD'))
df['Category'] = np.random.choice(['Category1', 'Category2', 'Category3'], size=100)
print(df.head())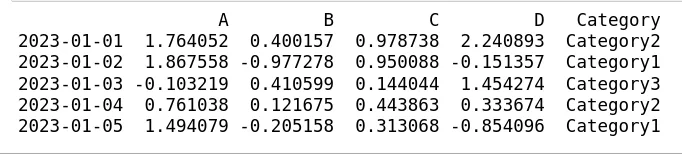
Cela crée un DataFrame de 100 lignes avec les colonnes A, B, C et D et une colonne catégorielle Category. Les valeurs sont aléatoires et Category prend une valeur parmi trois.
Analyse et visualisation
Avec les données synthétiques, nous effectuons quelques analyses de base et traçons des graphiques.
# Statistical summary
print(df.describe())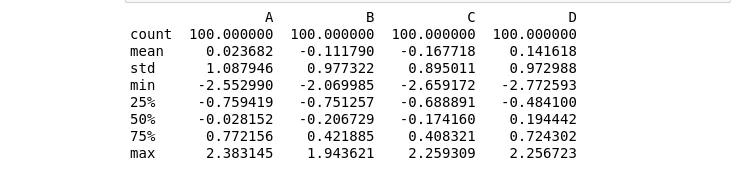
La synthèse donne une vue complète des données. Les moyennes des colonnes A, B, C et D sont proches de zéro, comme on peut s’y attendre avec des valeurs aléatoires issues d’une loi normale, et les écarts types sont proches de 1, ce qui indique la dispersion des valeurs autour de la moyenne.
# Grouping and summarizing
grouped = df.groupby('Category').mean()
print(grouped)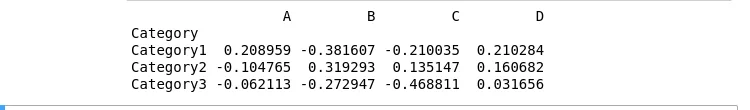
Le regroupement par Category montre la moyenne de chaque colonne pour chaque catégorie, ce qui révèle en quoi les catégories diffèrent.
# Visualizing data
df['A'].plot(kind='hist', title='Histogram of A')
plt.show()

sns.boxplot(x='Category', y='B', data=df)
plt.show()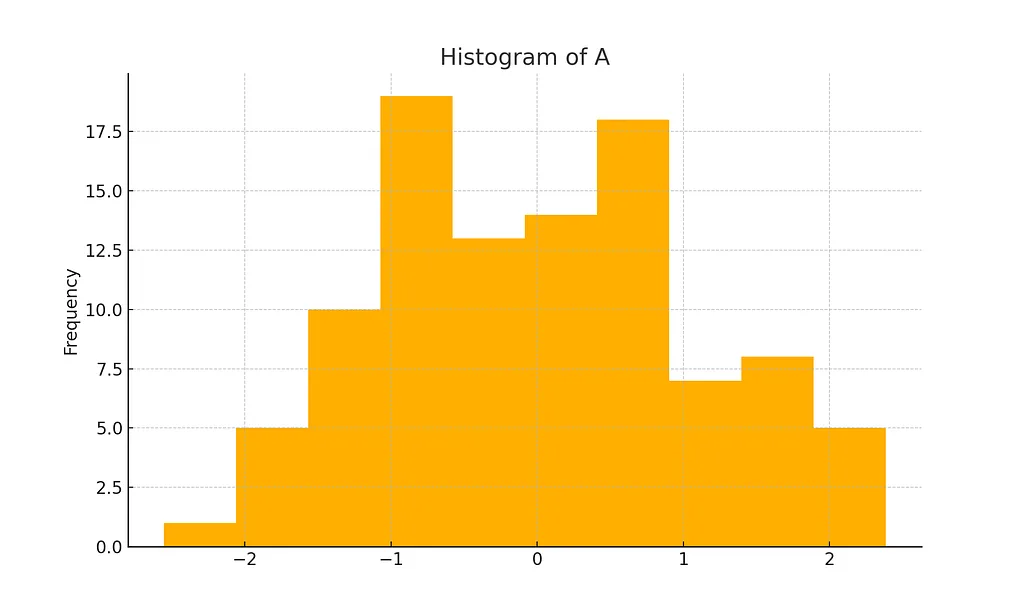
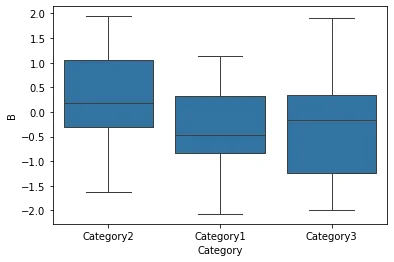
L’histogramme montre la distribution des valeurs de la colonne A, la boîte à moustaches celle de la colonne B selon les catégories. Ce type de graphique aide à comprendre la distribution des données et à repérer des valeurs aberrantes ou des motifs.
Conclusion
Pandas est un outil polyvalent et puissant d’analyse de données ; sa souplesse et sa simplicité le rendent indispensable aux data scientists. Dans cet article, nous avons présenté ses fonctionnalités essentielles et leur rôle dans une analyse, puis montré une utilisation pratique sur des données synthétiques. En pratiquant davantage et en abordant des techniques plus avancées, vous pourrez aller plus loin en science des données et tirer davantage d’enseignements de vos données avec pandas.
Références
- McKinney, W. (2010). Data Structures for Statistical Computing in Python. Proceedings of the 9th Python in Science Conference, 51–56.
- McKinney, W. (2017). Python for Data Analysis: Data Wrangling with Pandas, NumPy, and IPython (2ᵉ éd.). O’Reilly Media.
- L’équipe de développement de pandas. Documentation de pandas. pandas.pydata.org
- Documentation de NumPy. numpy.org
- Documentation de Matplotlib. matplotlib.org
- Documentation de Seaborn. seaborn.pydata.org