

Analisi dei dati con Pandas: manipolare e visualizzare i dati
Scritto da Yasin TANIŞ
Introduzione
L’analisi dei dati è diventata parte integrante dei processi decisionali. Python spicca in questo campo grazie a potenti librerie per analizzare e manipolare i dati. Una di queste, pandas, è indispensabile per i data scientist perché è flessibile e facile da usare. In questo articolo vediamo le funzionalità principali di pandas e il loro impiego nell’analisi dei dati, con esempi pratici su dati reali o sintetici.
DataFrame e Series
Pandas lavora con due strutture dati principali. Un DataFrame è una struttura bidimensionale di righe e colonne. Una Series è monodimensionale e rappresenta una singola colonna di dati.
import pandas as pd

# Creating a simple DataFrame
data = {
    'name': ['Alice', 'Bob', 'Charlie'],
    'age': [25, 30, 35],
    'city': ['New York', 'Los Angeles', 'Chicago']
}
df = pd.DataFrame(data)
print(df)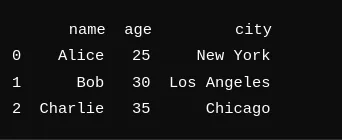
Creare i DataFrame
Ci sono molti modi per creare un DataFrame. Puoi caricare dati da fonti come CSV, Excel e SQL e trasformarli in DataFrame.
# Loading data from a CSV file
df = pd.read_csv('data.csv')

# Loading data from an Excel file
df = pd.read_excel('data.xlsx')

# Loading data from an SQL database
import sqlite3
conn = sqlite3.connect('database.db')
df = pd.read_sql_query('SELECT * FROM table', conn)
Caricare e salvare i dati
Pandas rende semplice caricare e salvare i dati. Puoi leggere ed elaborare file in molti formati diversi.
# Saving data
df.to_csv('new_data.csv', index=False)
df.to_excel('new_data.xlsx', index=False)
Pulire e preparare i dati
Pulizia e preparazione sono passaggi fondamentali dell’analisi dei dati. Pandas facilita la gestione dei valori mancanti, la conversione dei tipi di dati e la rimozione dei dati superflui.
# Checking for missing values
print(df.isnull().sum())

# Filling missing values
df.fillna(0, inplace=True)

# Converting data types
df['date'] = pd.to_datetime(df['date'])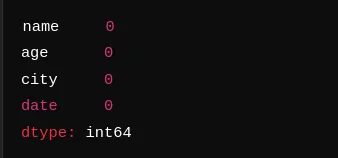
Qui controlliamo se il DataFrame ha valori mancanti. L’output mostra che nessuna colonna ne ha.
Riepiloghi statistici
Pandas offre molti strumenti per riassumere rapidamente i dati. Le statistiche di base si ottengono con una sola chiamata.
# Basic statistical summaries
print(df.describe())

# Summarizing specific columns
print(df['age'].mean())
print(df['age'].std())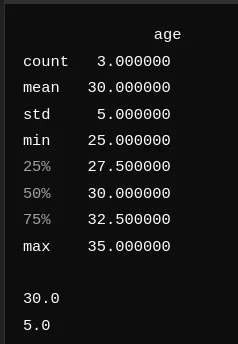
Nel riepilogo l’età media è 30 con una deviazione standard di 5; l’età minima e quella massima sono rispettivamente 25 e 35. Questo offre un quadro rapido della distribuzione delle età nei dati.
Raggruppare e riassumere
Raggruppare e riassumere è uno dei punti di forza di pandas. Le funzioni groupby e pivot_table lo rendono semplice.
# Grouping and summarizing
group = df.groupby('city')['age'].mean()
print(group)

# Creating a pivot table
pivot = df.pivot_table(values='age', index='city', columns='gender', aggfunc='mean')
print(pivot)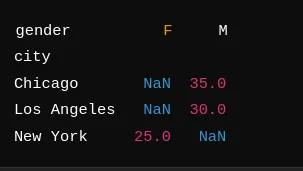
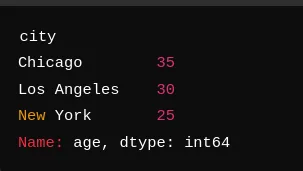
Raggruppando per città otteniamo l’età media di ciascuna: Chicago (35), Los Angeles (30) e New York (25). La tabella pivot dà un riepilogo simile suddiviso per genere; il nostro esempio non ha dati sul genere, quindi quelle celle mostrano NaN.
Visualizzare i dati con pandas
Pandas ha strumenti grafici semplici ma efficaci. Funzioni come plot, hist e boxplot producono grafici rapidamente.
# Basic plots
df['age'].plot(kind='hist')
df.plot(kind='scatter', x='age', y='income')
Lavorare con Seaborn e Matplotlib
Puoi visualizzare i dati di pandas anche con Seaborn e Matplotlib, che permettono grafici più personalizzati e dettagliati.
import seaborn as sns
import matplotlib.pyplot as plt

# Visualizing with Seaborn
sns.boxplot(x='city', y='age', data=df)
plt.show()
Analisi delle serie temporali
Pandas gestisce molto bene le serie temporali, il che rende facile individuare tendenze e pattern.
# Handling time series data
df['date'] = pd.to_datetime(df['date'])
df.set_index('date', inplace=True)
print(df.resample('M').mean())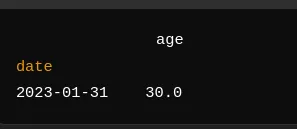
Qui convertiamo la colonna date in datetime e la impostiamo come indice. Ricampionando per mese e facendo la media otteniamo un’età media di 30 per gennaio 2023.
Unire e combinare i dati
Pandas offre molte funzioni per unire e combinare set di dati, come merge, join e concat.
# Merging two DataFrames
df1 = pd.DataFrame({'name': ['Alice', 'Bob'], 'age': [25, 30]})
df2 = pd.DataFrame({'name': ['Alice', 'Bob'], 'city': ['New York', 'Los Angeles']})
merged_df = pd.merge(df1, df2, on='name')
print(merged_df)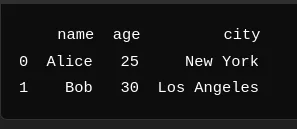
In questo esempio uniamo due DataFrame sulla colonna name, combinando età e città di ogni persona.
Esempio pratico: analisi con dati sintetici
Creare i dati
Per un esempio pratico creiamo dei dati sintetici per mostrare cosa sa fare pandas.
import pandas as pd
import numpy as np
import seaborn as sns
import matplotlib.pyplot as plt

# Creating synthetic data
np.random.seed(0)
dates = pd.date_range('20230101', periods=100)
df = pd.DataFrame(np.random.randn(100, 4), index=dates, columns=list('ABCD'))
df['Category'] = np.random.choice(['Category1', 'Category2', 'Category3'], size=100)
print(df.head())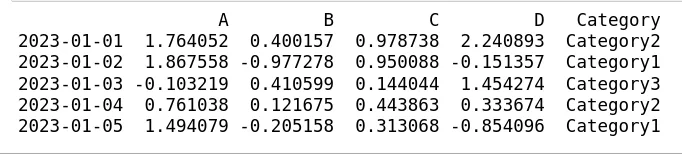
Così si crea un DataFrame di 100 righe con le colonne A, B, C e D e una colonna categorica Category. I valori sono casuali e Category assume uno di tre valori.
Analisi e visualizzazione
Con i dati sintetici eseguiamo alcune analisi di base e creiamo dei grafici.
# Statistical summary
print(df.describe())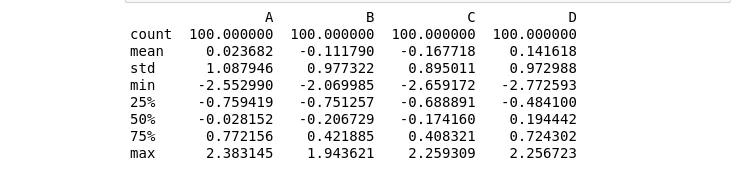
Il riepilogo offre una visione completa dei dati. Le medie delle colonne A, B, C e D sono vicine a zero, come ci si aspetta da una distribuzione normale casuale, e le deviazioni standard sono vicine a 1, a indicare quanto i valori si disperdano attorno alla media.
# Grouping and summarizing
grouped = df.groupby('Category').mean()
print(grouped)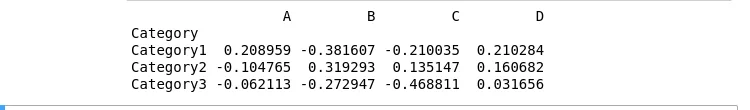
Raggruppare per Category mostra la media di ogni colonna per ogni categoria, il che rivela in che modo le categorie differiscono tra loro.
# Visualizing data
df['A'].plot(kind='hist', title='Histogram of A')
plt.show()

sns.boxplot(x='Category', y='B', data=df)
plt.show()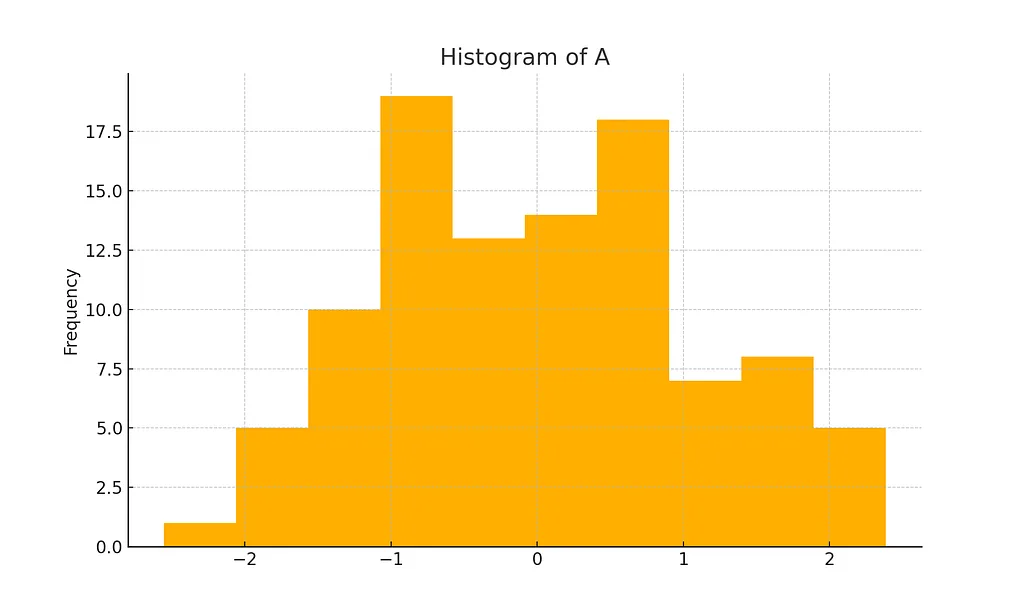
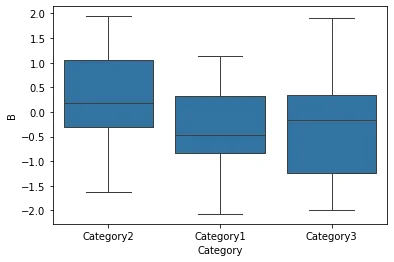
L’istogramma mostra la distribuzione dei valori della colonna A, il box plot la colonna B per categoria. Grafici come questi ti aiutano a capire la distribuzione e a individuare valori anomali o pattern.
Conclusione
Pandas è uno strumento versatile e potente per l’analisi dei dati; flessibilità e facilità d’uso lo rendono indispensabile per i data scientist. In questo articolo abbiamo visto le sue funzionalità principali e il loro ruolo in un’analisi, e ne abbiamo mostrato l’uso pratico su dati sintetici. Con ulteriore pratica e tecniche più avanzate puoi approfondire la data science e ricavare più informazioni dai tuoi dati con pandas.
Fonti
- McKinney, W. (2010). Data Structures for Statistical Computing in Python. Proceedings of the 9th Python in Science Conference, 51–56.
- McKinney, W. (2017). Python for Data Analysis: Data Wrangling with Pandas, NumPy, and IPython (2ª ed.). O’Reilly Media.
- Il team di sviluppo di pandas. Documentazione di pandas. pandas.pydata.org
- Documentazione di NumPy. numpy.org
- Documentazione di Matplotlib. matplotlib.org
- Documentazione di Seaborn. seaborn.pydata.org