

Analiza podatkov s pandas: obdelava in vizualizacija podatkov
Avtor Yasin TANIŞ
Uvod
Analiza podatkov je postala sestavni del odločanja. Python na tem področju izstopa zaradi zmogljivih knjižnic za analizo in obdelavo podatkov. Ena od njih, pandas, je za podatkovne znanstvenike nepogrešljiva, ker je prilagodljiva in enostavna za uporabo. V tem članku si bomo ogledali osnovne zmožnosti knjižnice pandas in njeno uporabo pri analizi podatkov, s praktičnimi primeri na resničnih ali sintetičnih podatkih.
DataFrame in Series
Pandas dela z dvema osnovnima podatkovnima strukturama. DataFrame je dvodimenzionalna struktura iz vrstic in stolpcev. Series je enodimenzionalna in predstavlja en stolpec podatkov.
import pandas as pd

# Creating a simple DataFrame
data = {
    'name': ['Alice', 'Bob', 'Charlie'],
    'age': [25, 30, 35],
    'city': ['New York', 'Los Angeles', 'Chicago']
}
df = pd.DataFrame(data)
print(df)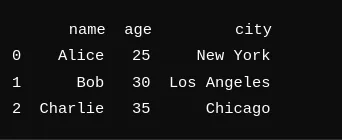
Ustvarjanje DataFrama
DataFrame lahko ustvarite na veliko načinov. Podatke lahko naložite iz virov, kot so CSV, Excel in SQL, in jih pretvorite v DataFrame.
# Loading data from a CSV file
df = pd.read_csv('data.csv')

# Loading data from an Excel file
df = pd.read_excel('data.xlsx')

# Loading data from an SQL database
import sqlite3
conn = sqlite3.connect('database.db')
df = pd.read_sql_query('SELECT * FROM table', conn)
Nalaganje in shranjevanje podatkov
Pandas poenostavi nalaganje in shranjevanje podatkov. Berete in obdelujete lahko datoteke v številnih oblikah.
# Saving data
df.to_csv('new_data.csv', index=False)
df.to_excel('new_data.xlsx', index=False)
Čiščenje in priprava podatkov
Čiščenje in priprava sta ključna koraka analize podatkov. Pandas olajša delo z manjkajočimi vrednostmi, pretvorbo podatkovnih tipov in odstranjevanje nepotrebnih podatkov.
# Checking for missing values
print(df.isnull().sum())

# Filling missing values
df.fillna(0, inplace=True)

# Converting data types
df['date'] = pd.to_datetime(df['date'])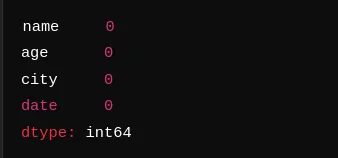
Tu preverimo, ali ima DataFrame manjkajoče vrednosti. Izpis pokaže, da jih ni v nobenem stolpcu.
Statistični povzetki
Pandas ponuja veliko orodij za hitro povzemanje podatkov. Osnovne statistike in povzetke dobite z enim samim klicem.
# Basic statistical summaries
print(df.describe())

# Summarizing specific columns
print(df['age'].mean())
print(df['age'].std())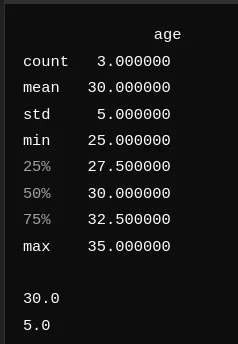
V povzetku je povprečna starost 30, standardni odklon pa 5; najnižja in najvišja starost sta 25 in 35. To da hiter vpogled v porazdelitev starosti v podatkih.
Združevanje in povzemanje
Združevanje in povzemanje je ena od močnih strani knjižnice pandas. Funkciji groupby in pivot_table to poenostavita.
# Grouping and summarizing
group = df.groupby('city')['age'].mean()
print(group)

# Creating a pivot table
pivot = df.pivot_table(values='age', index='city', columns='gender', aggfunc='mean')
print(pivot)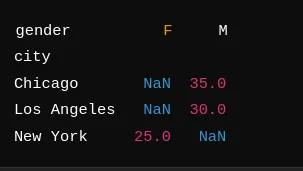
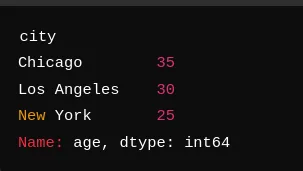
Z združevanjem po mestih dobimo povprečno starost za vsako mesto: Chicago (35), Los Angeles (30) in New York (25). Vrtilna tabela da podoben povzetek, razdeljen po spolu; naš primer nima podatkov o spolu, zato te celice kažejo NaN.
Vizualizacija podatkov s pandas
Pandas ima preprosta, a učinkovita orodja za risanje grafov. Funkcije, kot so plot, hist in boxplot, hitro izrišejo grafe.
# Basic plots
df['age'].plot(kind='hist')
df.plot(kind='scatter', x='age', y='income')
Delo s Seabornom in Matplotlibom
Podatke iz pandas lahko vizualizirate tudi s Seabornom in Matplotlibom, ki omogočata bolj prilagojene in podrobnejše grafe.
import seaborn as sns
import matplotlib.pyplot as plt

# Visualizing with Seaborn
sns.boxplot(x='city', y='age', data=df)
plt.show()
Analiza časovnih vrst
Pandas zelo dobro dela s časovnimi vrstami, zato je v njih lahko poiskati trende in vzorce.
# Handling time series data
df['date'] = pd.to_datetime(df['date'])
df.set_index('date', inplace=True)
print(df.resample('M').mean())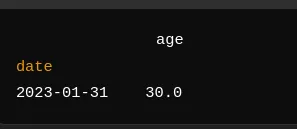
Tu stolpec date pretvorimo v datetime in ga nastavimo kot indeks. Z mesečnim ponovnim vzorčenjem in povprečjem dobimo povprečno starost 30 za januar 2023.
Spajanje in združevanje podatkov
Pandas ima veliko funkcij za spajanje in združevanje podatkovnih zbirk, na primer merge, join in concat.
# Merging two DataFrames
df1 = pd.DataFrame({'name': ['Alice', 'Bob'], 'age': [25, 30]})
df2 = pd.DataFrame({'name': ['Alice', 'Bob'], 'city': ['New York', 'Los Angeles']})
merged_df = pd.merge(df1, df2, on='name')
print(merged_df)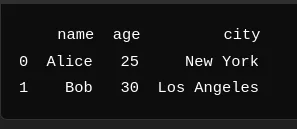
V tem primeru spojimo dva DataFrama po stolpcu name ter tako združimo starost in mesto vsake osebe.
Praktični primer: analiza sintetičnih podatkov
Ustvarjanje podatkov
Za praktični primer ustvarimo sintetične podatke, ki pokažejo, kaj zmore pandas.
import pandas as pd
import numpy as np
import seaborn as sns
import matplotlib.pyplot as plt

# Creating synthetic data
np.random.seed(0)
dates = pd.date_range('20230101', periods=100)
df = pd.DataFrame(np.random.randn(100, 4), index=dates, columns=list('ABCD'))
df['Category'] = np.random.choice(['Category1', 'Category2', 'Category3'], size=100)
print(df.head())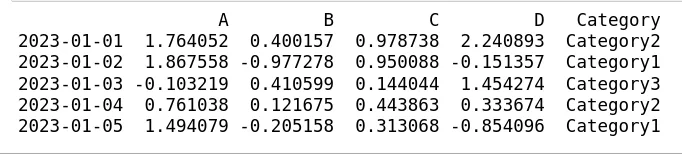
To ustvari DataFrame s 100 vrsticami, stolpci A, B, C in D ter kategorialnim stolpcem Category. Vrednosti so naključne, Category pa zavzame eno od treh vrednosti.
Analiza in vizualizacija
S sintetičnimi podatki opravimo osnovno analizo in narišemo grafe.
# Statistical summary
print(df.describe())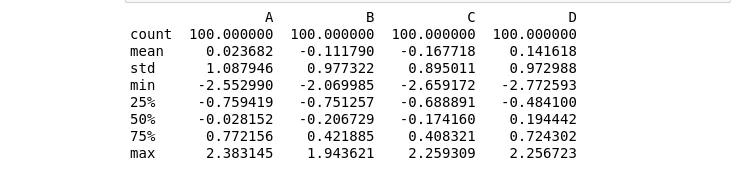
Povzetek da celovit pregled podatkov. Povprečja stolpcev A, B, C in D so blizu nič, kot je pričakovati pri naključni normalni porazdelitvi, standardni odkloni pa so blizu 1 in kažejo, kako močno so vrednosti razpršene okoli povprečja.
# Grouping and summarizing
grouped = df.groupby('Category').mean()
print(grouped)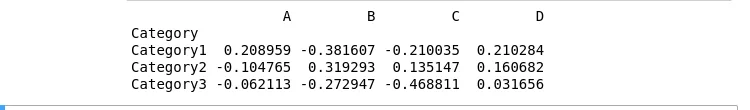
Združevanje po Category pokaže povprečje vsakega stolpca za vsako kategorijo in razkrije, v čem se kategorije razlikujejo.
# Visualizing data
df['A'].plot(kind='hist', title='Histogram of A')
plt.show()

sns.boxplot(x='Category', y='B', data=df)
plt.show()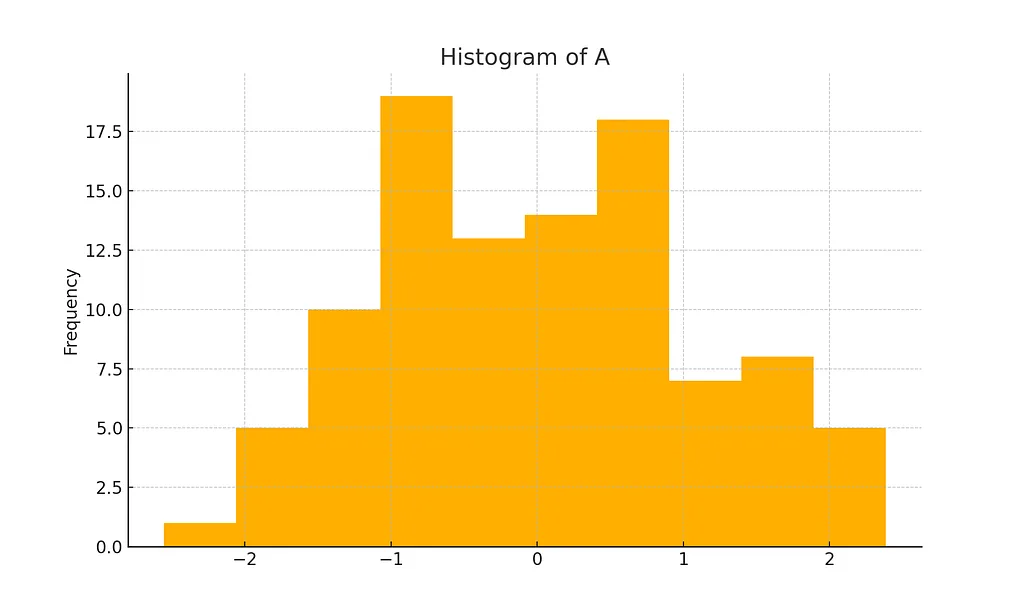
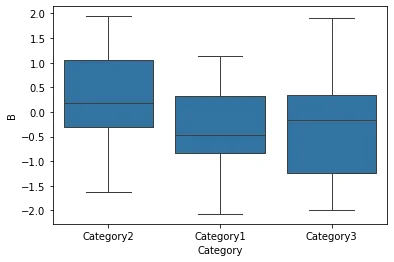
Histogram prikazuje porazdelitev vrednosti v stolpcu A, diagram škatla z brki pa stolpec B po kategorijah. Takšni grafi pomagajo razumeti porazdelitev in opaziti osamelce ali vzorce.
Sklep
Pandas je vsestransko in zmogljivo orodje za analizo podatkov; zaradi prilagodljivosti in enostavne uporabe je nepogrešljivo za podatkovne znanstvenike. V tem članku smo obravnavali njegove osnovne zmožnosti in njihovo mesto v analizi ter pokazali praktično uporabo na sintetičnih podatkih. Z več vaje in naprednejšimi tehnikami se lahko poglobite v podatkovno znanost in s pandas iz svojih podatkov izluščite več spoznanj.
Viri
- McKinney, W. (2010). Data Structures for Statistical Computing in Python. Proceedings of the 9th Python in Science Conference, 51–56.
- McKinney, W. (2017). Python for Data Analysis: Data Wrangling with Pandas, NumPy, and IPython (2. izd.). O’Reilly Media.
- Razvojna ekipa pandas. Dokumentacija pandas. pandas.pydata.org
- Dokumentacija NumPy. numpy.org
- Dokumentacija Matplotlib. matplotlib.org
- Dokumentacija Seaborn. seaborn.pydata.org