

Šta je neuravnotežen skup podataka i kako se nositi s njim?
Autor Yasin TANIŞ
Šta je neuravnotežen skup podataka
Pravite klasifikacijski model za neku kompaniju i on postiže tačnost od 95 %. Sve izgleda u redu. Model ulazi u upotrebu, a ubrzo neko primijeti da uvijek predviđa istu klasu. Kad ponovo pogledate podatke, vidite da klasa koju nikad ne prepoznaje čini svega 5 % podataka. Uzrok neuspjeha modela je neuravnotežen skup podataka.
Neuravnoteženi skupovi podataka javljaju se u problemima klasifikacije kada klase nisu ni približno ravnomjerno raspoređene. Problem je što većinska klasa nadjačava manjinsku: model naginje većini i loše klasificira manjinu.
Kad se suočimo s neuravnoteženim podacima, ovo su metode pomoću kojih možemo ispravno sagledati stanje i ponovo uspostaviti ravnotežu:
- Odabir pravih metrika: precision, recall, F1 rezultat, ROC kriva i AUC
- Ponovno uzorkovanje: oversampling (nasumični i SMOTE) i undersampling (nasumični, NearMiss, Tomek veze, centroidi klastera)
- Prikupljanje više podataka
- Korištenje parametra
class_weightklasifikacijskih modela kako bi model jednako učio iz manjinske i većinske klase - Praćenje performansi drugih modela umjesto oslanjanja na jedan
- Drugačiji pristup, poput detekcije anomalija ili promjena
Prvo ispitujemo skup podataka Credit Card Fraud Detection, koji je neuravnotežen, a zatim primjenjujemo nekoliko metoda kako bismo se nosili s tom neravnotežom.
Ispitivanje skupa podataka
Otkrivanje prevara važno je kompanijama koje izdaju kreditne kartice: ne žele da se kupcima naplaćuju kupovine koje nisu obavili.
Skup podataka: creditcard.csv (Kaggle)
Pomoću ovog skupa podataka želimo napraviti model koji otkriva prevarantske transakcije. Podaci potiču od transakcija karticama obavljenih u Evropi u septembru 2013; svaka transakcija označena je sa 1 ako je prevara, a sa 0 ako nije. Zbog zaštite privatnosti dostupno je malo pozadinskih informacija, a sve varijable osim Time i Amount transformirane su metodom PCA (analiza glavnih komponenti).
Time: broj sekundi proteklih između prve transakcije i svake pojedine transakcijeAmount: iznos transakcije
Prvo čitamo podatke, provjeravamo nedostajuće vrijednosti i gledamo raspodjelu varijable Class. Zatim standardiziramo Amount i Time, dijelimo podatke hold-out metodom i pravimo klasifikacijski model logističkom regresijom. Radit ćemo s jednim modelom.
# Gerekli kütüphaneler
import pandas as pd
import numpy as np
from sklearn.preprocessing import RobustScaler
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score
from sklearn.metrics import confusion_matrix, classification_report,f1_score,recall_score,roc_auc_score, roc_curve
import matplotlib.pyplot as plt
import seaborn as sns
from matplotlib import rc,rcParams
import itertools

import warnings
warnings.filterwarnings("ignore", category=DeprecationWarning)
warnings.filterwarnings("ignore", category=FutureWarning)
warnings.filterwarnings("ignore", category=UserWarning)
# Veri setinin okutulması
df = pd.read_csv("creditcard.csv")
df.head()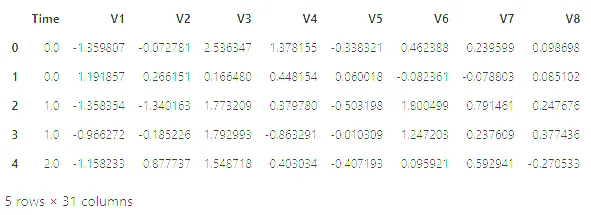
# Veri setindeki değişken ve gözlem sayısı
print("Gözlem sayısı : " ,len(df))
print("Değişken sayısı : ", len(df.columns))
Gözlem sayısı : 284807
Değişken sayısı : 31(Kod ispisuje oznake na turskom: broj opažanja i broj varijabli.)
# veri setindeki değişkenlerin tiplerini ve boş değer içerip içermediğini gözlemlemek istiyoruz
df.info()
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 284807 entries, 0 to 284806
Data columns (total 31 columns):
# Column Non-Null Count Dtype
--- ------ -------------- -----
0 Time 284807 non-null float64
1 V1 284807 non-null float64
2 V2 284807 non-null float64
3 V3 284807 non-null float64
4 V4 284807 non-null float64
5 V5 284807 non-null float64
6 V6 284807 non-null float64
7 V7 284807 non-null float64
8 V8 284807 non-null float64
9 V9 284807 non-null float64
10 V10 284807 non-null float64
11 V11 284807 non-null float64
12 V12 284807 non-null float64
13 V13 284807 non-null float64
14 V14 284807 non-null float64
15 V15 284807 non-null float64
16 V16 284807 non-null float64
17 V17 284807 non-null float64
18 V18 284807 non-null float64
19 V19 284807 non-null float64
20 V20 284807 non-null float64
21 V21 284807 non-null float64
22 V22 284807 non-null float64
23 V23 284807 non-null float64
24 V24 284807 non-null float64
25 V25 284807 non-null float64
26 V26 284807 non-null float64
27 V27 284807 non-null float64
28 V28 284807 non-null float64
29 Amount 284807 non-null float64
30 Class 284807 non-null int64
dtypes: float64(30), int64(1)
memory usage: 67.4 MB# 1 sınıfının veri setinde bulunma oranı %0.2, 0 sınıfının ise %99.8
f, ax = plt.subplots(1, 2, figsize=(18, 8))
# Sınıf dağılımı
class_counts = df['Class'].value_counts().sort_values(ascending=False)
# Sınıf sayısına göre patlamayı belirleyin
explode = [0.1] * len(class_counts)
# Sınıf dağılımı için pasta grafik
ax[0].pie(class_counts, labels=class_counts.index, autopct='%1.1f%%', explode=explode, shadow=True)
ax[0].set_title('Dağılım')
ax[0].set_ylabel('')
# Sınıf dağılımı için sayım grafiği (seaborn kullanarak)
sns.countplot(x='Class', data=df, ax=ax[1])
ax[1].set_title('Sınıf Sayısı')
plt.show()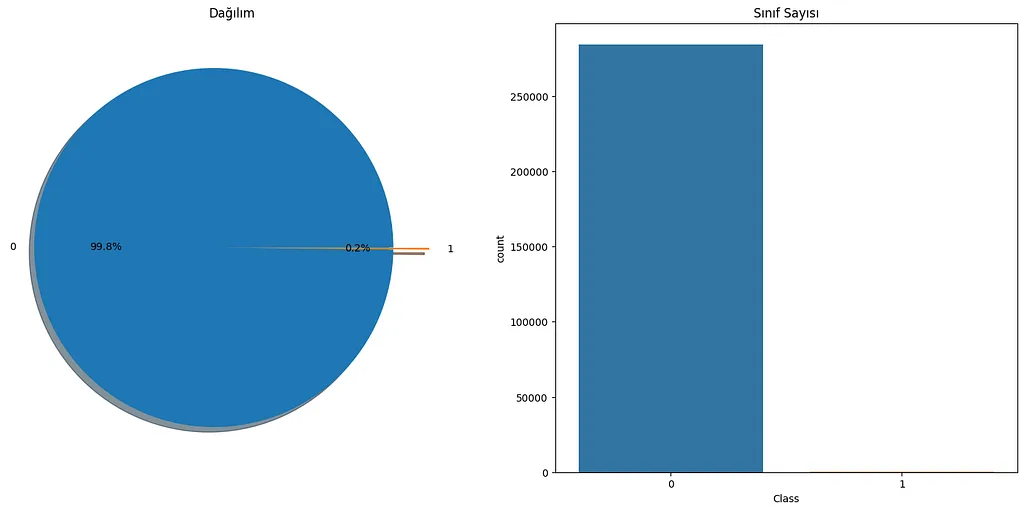
# Time ve Amount değişkenlerini standartlaştırma
rob_scaler = RobustScaler()
df['Amount'] = rob_scaler.fit_transform(df['Amount'].values.reshape(-1,1))
df['Time'] = rob_scaler.fit_transform(df['Time'].values.reshape(-1,1))
df.head()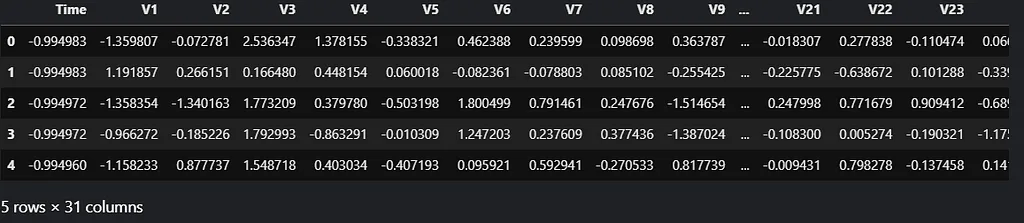
# Hold out yöntemi uygulayıp veri setini eğitim ve test olarak ikiye ayırıyoruz.(%80,%20)
X = df.drop("Class", axis=1)
y = df["Class"]
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.20, random_state=123456)
# modelin tanımlanıp, eğitilmesi ve başarı skoru
model = LogisticRegression(random_state=123456)
model.fit(X_train, y_train)
y_pred = model.predict(X_test)
accuracy = accuracy_score(y_test, y_pred)
print("Accuracy: %.3f"%(accuracy))Accuracy: 0.999Tačnost je udio tačnih predviđanja u ukupnom broju predviđanja. Naš model postiže 0,999. Mogli bismo reći da radi savršeno, zar ne? Pogledajmo i matricu konfuzije.
Matrica konfuzije
Matrica konfuzije je tabela koja sažeto prikazuje uspješnost klasifikacijskog modela na testnim podacima. Sadrži četiri kombinacije predviđenih i stvarnih vrijednosti. Ovdje prevaru smatramo pozitivnom klasom:
- Stvarno pozitivni (TP): predviđeno pozitivno, i to tačno.
- Stvarno negativni (TN): predviđeno negativno, i to tačno.
- Lažno pozitivni (FP): predviđeno pozitivno, ali pogrešno.
- Lažno negativni (FN): predviđeno negativno, ali pogrešno.
def plot_confusion_matrix(cm, classes,
                          title='Confusion matrix',
                          cmap=plt.cm.Blues):

    plt.rcParams.update({'font.size': 19})
    plt.imshow(cm, interpolation='nearest', cmap=cmap)
    plt.title(title,fontdict={'size':'16'})
    plt.colorbar()
    tick_marks = np.arange(len(classes))
    plt.xticks(tick_marks, classes, rotation=45,fontsize=12,color="blue")
    plt.yticks(tick_marks, classes,fontsize=12,color="blue")
    rc('font', weight='bold')
    fmt = '.1f'
    thresh = cm.max()
    for i, j in itertools.product(range(cm.shape[0]), range(cm.shape[1])):
        plt.text(j, i, format(cm[i, j], fmt),
                 horizontalalignment="center",
                 color="red")

    plt.ylabel('True label',fontdict={'size':'16'})
    plt.xlabel('Predicted label',fontdict={'size':'16'})
    plt.tight_layout()

plot_confusion_matrix(confusion_matrix(y_test, y_pred=y_pred), classes=['Non Fraud','Fraud'],
                      title='Confusion matrix')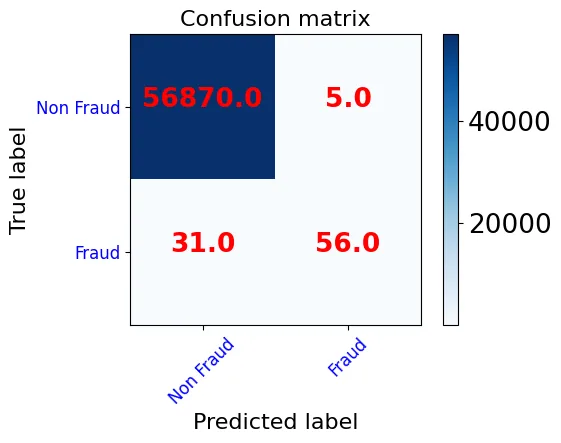
- Od 56875 transakcija koje su stvarno normalne, 56870 je tačno predviđeno, a 5 je pogrešno označeno kao prevara (FP).
- Od 87 transakcija koje su stvarno prevare, 56 je otkriveno (TP), a 31 je propuštena (FN).
Model iskazuje tačnost od 0,999, ali matrica konfuzije pokazuje visoku stopu grešaka u klasi prevara. Model dobro predviđa većinsku, a loše manjinsku klasu. Budući da normalnih transakcija ima mnogo više od prevarantskih, model izgleda uspješno samim tim što predviđa normalnu klasu.
Pouka: tačnost nije dobra mjera performansi klasifikacijskih modela, naročito kad su podaci neuravnoteženi kao što su naši. Pogledajmo kako se nositi s neravnotežom, koje metode primijeniti i kojim metrikama mjeriti performanse.
Odabir pravih metrika
Vidjeli smo da tačnost nije dovoljna; za mjerenje performansi potrebne su druge metrike.
Precision (preciznost): udio predviđenih pozitivnih koji su stvarno pozitivni. Niska preciznost znači mnogo lažno pozitivnih. Precision = TP / (TP + FP).
Recall (odziv): udio stvarno pozitivnih koje smo predvidjeli kao pozitivne. Nizak odziv znači mnogo lažno negativnih; odziv treba biti što viši. Recall = TP / (TP + FN).
F1 rezultat: teško je porediti model niske preciznosti i visokog odziva s modelom kod kojeg je obrnuto. F1 rezultat mjeri obje vrijednosti zajedno kao harmonijsku sredinu preciznosti i odziva. F1 = 2 × (Precision × Recall) / (Precision + Recall).
Pogledajmo ove metrike za naš model. Izvještaj o klasifikaciji prikazuje glavne metrike po klasama.
#sınıflandırma raporu
print(classification_report(y_test, y_pred))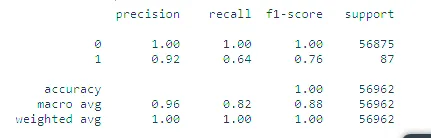
Preciznost po klasama:
- Klasa 0 (normalno): 56870 + 31 = 56901 transakcija predviđena je kao normalna, od toga 56870 tačno. Precision ≈ 1,00 (56870 / 56901).
- Klasa 1 (prevara): 5 + 56 = 61 transakcija predviđena je kao prevara, od toga 56 tačno. Precision ≈ 0,92 (56 / 61).
Odziv po klasama:
- Klasa 0 (normalno): od 56870 + 5 = 56875 normalnih transakcija, 56870 je tačno predviđeno. Recall ≈ 1,00.
- Klasa 1 (prevara): od 31 + 56 = 87 prevarantskih transakcija, 56 je tačno predviđeno. Recall = 56 / 87 ≈ 0,64.
Vrijednosti odziva jasno pokazuju neuspjeh na klasi 1. F1 rezultat je harmonijska sredina odziva i preciznosti. Support je stvarni broj primjera u svakoj klasi; razlika između klasa ukazuje na strukturnu slabost mjerenja, jer sama neravnoteža utječe na njih.
ROC kriva
ROC kriva je grafikon koji prikazuje performanse klasifikacijskog modela na svim pragovima odlučivanja. Na njemu su prikazane dvije vrijednosti:
- Stopa stvarno pozitivnih (TPR), tj. odziv: TPR = TP / (TP + FN)
- Stopa lažno pozitivnih (FPR), tj. stopa lažnih uzbuna na normalnim transakcijama: FPR = FP / (FP + TN)
Kriva prikazuje TPR naspram FPR na različitim pragovima; počinje u (0,0), a završava u (1,1). Dobar model daje krivu koja brzo raste od 0 do 1.
AUC (površina ispod ROC krive)
AUC sažima ROC krivu jednim brojem: mjeri cijelu površinu ispod krive od (0,0) do (1,1). Najbolja vrijednost je 1; nasumično pogađanje daje 0,5.
# Auc Roc Curve
def generate_auc_roc_curve(clf, X_test):
    y_pred_proba = clf.predict_proba(X_test)[:, 1]
    fpr, tpr, thresholds = roc_curve(y_test,  y_pred_proba)
    auc = roc_auc_score(y_test, y_pred_proba)
    plt.plot(fpr,tpr)
    plt.show()
    pass

generate_auc_roc_curve(model, X_test)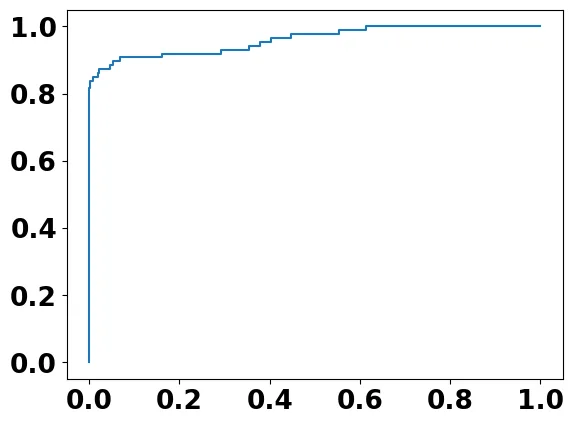
y_pred_proba = model.predict_proba(X_test)[:, 1]
auc = roc_auc_score(y_test, y_pred_proba)
print("AUC ROC Curve with Area Under the curve = %.3f"%auc)
AUC ROC Curve with Area Under the curve = 0.961Napomena: AUC ocjenjuje ukupne performanse klasifikacije. Budući da nijednoj klasi ne daje veću težinu, ne odražava dobro performanse na manjinskoj klasi.
Primijenimo sada nekoliko metoda na skup podataka kako bismo otklonili neravnotežu.
Važno: ove metode primjenjuju se samo na skup za obuku. Ako se primijene na test skup, ispravna procjena postaje nemoguća.
Ponovno uzorkovanje
Ponovno uzorkovanje (resampling) uravnotežuje skup podataka dodavanjem novih primjera manjinskoj klasi ili uklanjanjem primjera iz većinske klase. Undersampling uklanja primjere većine; oversampling umnožava primjere manjine.
Oversampling
Oversampling uravnotežuje podatke umnožavanjem primjera manjinske klase.
Nasumični oversampling:
- Nasumično odabrani primjeri manjinske klase dodaju se kako bi se skup uravnotežio.
- Može se koristiti kad je skup podataka mali.
- Može dovesti do preprilagođavanja (overfitting).
RandomOverSampler prima argument sampling_strategy. Uz sampling_strategy='minority' manjinska klasa se umnožava dok ne dostigne većinsku. Argument prima i decimalni broj: ako većinska klasa ima 1000 primjera, a manjinska 100, sampling_strategy=0.5 podiže manjinsku na 500.
# random oversampling önce eğitim setindeki sınıf sayısı
y_train.value_counts()
0 227440
1 405
Name: Class, dtype: int64# RandomOver Sampling uygulanması (Eğitim setine uygulanıyor)
from imblearn.over_sampling import RandomOverSampler
oversample = RandomOverSampler(sampling_strategy='minority')
X_randomover, y_randomover = oversample.fit_resample(X_train, y_train)# random oversampling den sonra eğitim setinin sınıf sayısı
y_randomover.value_counts()1 227440
0 227440
Name: Class, dtype: int64# modelin eğitilmesi ve başarı oranı
model.fit(X_randomover, y_randomover)
y_pred = model.predict(X_test)
accuracy = accuracy_score(y_test, y_pred)
print("Accuracy: %.3f%%" % (accuracy))Accuracy: 0.977plot_confusion_matrix(confusion_matrix(y_test, y_pred=y_pred), classes=['Non Fraud','Fraud'],
title='Confusion matrix')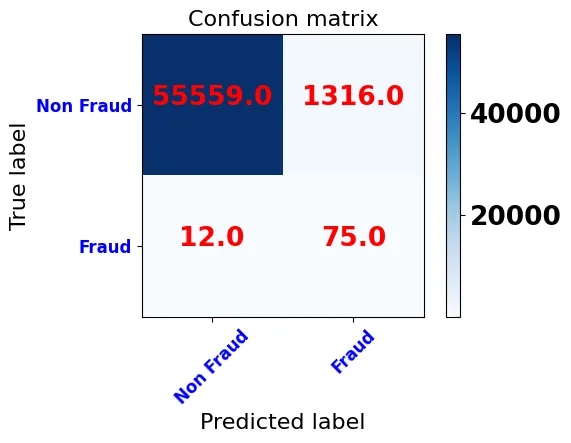
#sınıflandırma raporu
print(classification_report(y_test, y_pred)) precision recall f1-score support
0 1.00 0.98 0.99 56875
1 0.05 0.86 0.10 87
accuracy 0.98 56962
macro avg 0.53 0.92 0.55 56962
weighted avg 1.00 0.98 0.99 56962Nakon nasumičnog oversamplinga tačnost modela pada na 0,977. Matrica konfuzije i izvještaj o klasifikaciji pokazuju da je većina transakcija označenih kao prevara lažna uzbuna, što preciznost klase 1 spušta na 0,05. Zauzvrat, odziv klase 1 raste na 0,86: otkriveno je 75 od 87 prevara. Normalne transakcije predviđaju se nešto lošije nego kod prvog modela, ali ovaj skok u otkrivanju prevara snažan je razlog da se prednost da modelu obučenom nakon nasumičnog oversamplinga.
SMOTE oversampling:
Da bi se izbjeglo preprilagođavanje, umjesto kopija generiraju se sintetički primjeri manjinske klase:
- Nasumično se bira jedan primjer manjinske klase.
- Pronalazi se njegovih k najbližih susjeda.
- Jedan susjed bira se nasumično; u prostoru obilježja povlači se duž između primjera i tog susjeda, a sintetički primjer nastaje na toj duži.
# smote dan önce eğitim setindeki sınıf sayısı
y_train.value_counts()0 227440
1 405
Name: Class, dtype: int64# Smote uygulanması (Eğitim setine uygulanıyor)
from imblearn.over_sampling import SMOTE
oversample = SMOTE()
X_smote, y_smote = oversample.fit_resample(X_train, y_train)# smote dan sonra eğitim setinin sınıf sayısı
y_smote.value_counts()1 227440
0 227440
Name: Class, dtype: int64# modelin eğitilmesi ve başarı oranı
model.fit(X_smote, y_smote)
y_pred = model.predict(X_test)
accuracy = accuracy_score(y_test, y_pred)
print("Accuracy: %.3f%%" % (accuracy))Accuracy: 0.975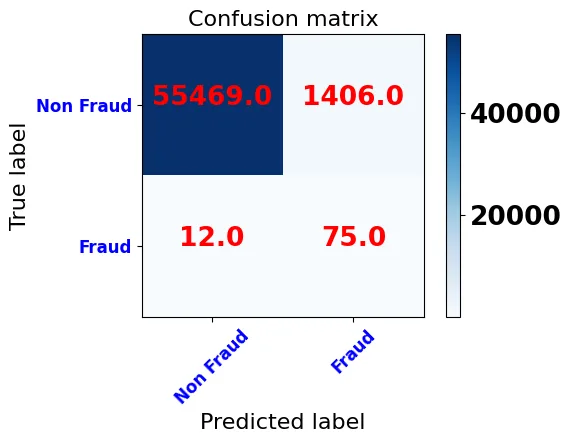
plot_confusion_matrix(confusion_matrix(y_test, y_pred=y_pred), classes=['Non Fraud','Fraud'],
                      title='Confusion matrix')
#sınıflandırma raporu
print(classification_report(y_test, y_pred)) precision recall f1-score support
0 1.00 0.98 0.99 56875
1 0.05 0.86 0.10 87
accuracy 0.98 56962
macro avg 0.53 0.92 0.54 56962
weighted avg 1.00 0.98 0.99 56962Rezultati nakon SMOTE-a slični su nasumičnom oversamplingu: ponovo je otkriveno 75 od 87 prevara, dok broj lažnih uzbuna raste na 1406.
Undersampling
Undersampling uravnotežuje podatke uklanjanjem primjera iz većinske klase i pogodan je za velike skupove. Naš skup nije dovoljno velik da bi ova metoda dala dobre rezultate, ali objašnjavamo metode i pokazujemo kako se neke primjenjuju.
Nasumični undersampling:
- Primjeri za uklanjanje biraju se nasumično.
- Može se koristiti ako imate velik skup podataka.
- Nasumični odabir može dovesti do gubitka informacija.
# random undersampling den önce eğitim setindeki sınıf sayısı
y_train.value_counts()
0 227440
1 405
Name: Class, dtype: int64from imblearn.under_sampling import RandomUnderSampler
# transform the dataset
ranUnSample = RandomUnderSampler()
X_ranUnSample, y_ranUnSample = ranUnSample.fit_resample(X_train, y_train)# Random undersampling sonra
y_ranUnSample.value_counts()1 405
0 405
Name: Class, dtype: int64NearMiss undersampling:
- Smanjuje gubitak informacija.
- Zasniva se na algoritmu KNN.
- Računa udaljenost primjera većinske klase od primjera manjinske.
- Zadržava primjere većinske klase najbliže manjinskoj, prema zadanom k.
Tomek veze: za svaki par najbližih primjera iz različitih klasa uklanja se primjer većinske klase, čime se povećava razmak između klasa.
Centroidi klastera: nevažni primjeri uklanjaju se iz skupa; da li je primjer važan određuje se klasteriranjem.
Undersampling i oversampling mogu se kombinirati kako bi se dobili uravnoteženiji skupovi podataka.
Druge metode
- Prikupljanje više podataka
- Korištenje parametra
class_weightkako bi model jednako učio iz manjinske i većinske klase - Praćenje performansi drugih modela, ne samo jednog
- Drugačiji pristup, poput detekcije anomalija ili promjena
Koja metoda najbolje funkcionira zavisi od konkretnog skupa podataka. Najbolje je isprobati metode i odabrati onu koja odgovara vašim podacima.
Izvori
- Kaggle: O neuravnoteženim skupovima podataka (Yasin Tanış, na turskom)
- Miuul: Šta je neuravnotežen skup podataka (na turskom)
- Machine Learning Mastery: Random oversampling and undersampling
- Machine Learning Mastery: SMOTE oversampling
- Towards Data Science: Understanding the confusion matrix
- Towards Data Science: Understanding the AUC-ROC curve
- Machine Learning Mastery: Tactics to combat imbalanced classes