

Qu’est-ce qu’un jeu de données déséquilibré et comment le traiter ?
Par Yasin TANIŞ
Qu’est-ce qu’un jeu de données déséquilibré ?
Vous construisez un modèle de classification pour une entreprise et il atteint 95 % d’exactitude. Tout semble aller bien. Le modèle est mis en service, et l’on s’aperçoit vite qu’il prédit toujours la même classe. En revoyant les données, vous constatez que la classe qu’il ne détecte jamais ne représente que 5 % des données. L’échec du modèle vient d’un jeu de données déséquilibré.
Les jeux de données déséquilibrés apparaissent dans les problèmes de classification lorsque les classes sont loin d’être réparties équitablement. Le problème est que la classe majoritaire écrase la classe minoritaire : le modèle privilégie la classe majoritaire et classe mal la classe minoritaire.
Face à des données déséquilibrées, voici les méthodes auxquelles nous pouvons recourir pour observer correctement la situation et rétablir l’équilibre :
- Choisir les bonnes métriques : précision, rappel, score F1, courbe ROC et AUC
- Rééchantillonner : suréchantillonnage (aléatoire et SMOTE) et sous-échantillonnage (aléatoire, NearMiss, liens de Tomek, centroïdes de clusters)
- Collecter davantage de données
- Utiliser le paramètre
class_weightdes modèles de classification, pour que le modèle apprenne autant de la classe minoritaire que de la classe majoritaire - Examiner la performance d’autres modèles plutôt que de s’en remettre à un seul
- Changer d’approche, par exemple avec la détection d’anomalies ou de changements
Nous examinons d’abord le jeu de données Credit Card Fraud Detection, qui est déséquilibré, puis nous appliquons plusieurs méthodes pour traiter ce déséquilibre.
Examen du jeu de données
La détection de la fraude est essentielle pour les émetteurs de cartes bancaires : ils ne veulent pas que leurs clients soient débités pour des achats qu’ils n’ont pas effectués.
Jeu de données : creditcard.csv (Kaggle)
Avec ce jeu de données, nous voulons construire un modèle qui détecte les transactions frauduleuses. Les données proviennent de transactions par carte effectuées en Europe en septembre 2013 ; chaque transaction est étiquetée 1 s’il s’agit d’une fraude, 0 sinon. Pour des raisons de confidentialité, les informations de contexte sont limitées, et toutes les variables sauf Time et Amount ont été transformées par ACP (analyse en composantes principales).
Time: secondes écoulées entre la première transaction et chaque transactionAmount: montant de la transaction
Nous lisons d’abord les données, vérifions les valeurs manquantes et regardons la distribution de la variable Class. Nous standardisons ensuite Amount et Time, séparons les données par la méthode hold-out et construisons un modèle de classification par régression logistique. Nous travaillerons avec un seul modèle.
# Gerekli kütüphaneler
import pandas as pd
import numpy as np
from sklearn.preprocessing import RobustScaler
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score
from sklearn.metrics import confusion_matrix, classification_report,f1_score,recall_score,roc_auc_score, roc_curve
import matplotlib.pyplot as plt
import seaborn as sns
from matplotlib import rc,rcParams
import itertools

import warnings
warnings.filterwarnings("ignore", category=DeprecationWarning)
warnings.filterwarnings("ignore", category=FutureWarning)
warnings.filterwarnings("ignore", category=UserWarning)
# Veri setinin okutulması
df = pd.read_csv("creditcard.csv")
df.head()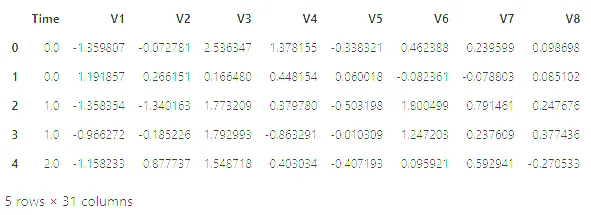
# Veri setindeki değişken ve gözlem sayısı
print("Gözlem sayısı : " ,len(df))
print("Değişken sayısı : ", len(df.columns))
Gözlem sayısı : 284807
Değişken sayısı : 31(Le code affiche ses libellés en turc : nombre d’observations et nombre de variables.)
# veri setindeki değişkenlerin tiplerini ve boş değer içerip içermediğini gözlemlemek istiyoruz
df.info()
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 284807 entries, 0 to 284806
Data columns (total 31 columns):
# Column Non-Null Count Dtype
--- ------ -------------- -----
0 Time 284807 non-null float64
1 V1 284807 non-null float64
2 V2 284807 non-null float64
3 V3 284807 non-null float64
4 V4 284807 non-null float64
5 V5 284807 non-null float64
6 V6 284807 non-null float64
7 V7 284807 non-null float64
8 V8 284807 non-null float64
9 V9 284807 non-null float64
10 V10 284807 non-null float64
11 V11 284807 non-null float64
12 V12 284807 non-null float64
13 V13 284807 non-null float64
14 V14 284807 non-null float64
15 V15 284807 non-null float64
16 V16 284807 non-null float64
17 V17 284807 non-null float64
18 V18 284807 non-null float64
19 V19 284807 non-null float64
20 V20 284807 non-null float64
21 V21 284807 non-null float64
22 V22 284807 non-null float64
23 V23 284807 non-null float64
24 V24 284807 non-null float64
25 V25 284807 non-null float64
26 V26 284807 non-null float64
27 V27 284807 non-null float64
28 V28 284807 non-null float64
29 Amount 284807 non-null float64
30 Class 284807 non-null int64
dtypes: float64(30), int64(1)
memory usage: 67.4 MB# 1 sınıfının veri setinde bulunma oranı %0.2, 0 sınıfının ise %99.8
f, ax = plt.subplots(1, 2, figsize=(18, 8))
# Sınıf dağılımı
class_counts = df['Class'].value_counts().sort_values(ascending=False)
# Sınıf sayısına göre patlamayı belirleyin
explode = [0.1] * len(class_counts)
# Sınıf dağılımı için pasta grafik
ax[0].pie(class_counts, labels=class_counts.index, autopct='%1.1f%%', explode=explode, shadow=True)
ax[0].set_title('Dağılım')
ax[0].set_ylabel('')
# Sınıf dağılımı için sayım grafiği (seaborn kullanarak)
sns.countplot(x='Class', data=df, ax=ax[1])
ax[1].set_title('Sınıf Sayısı')
plt.show()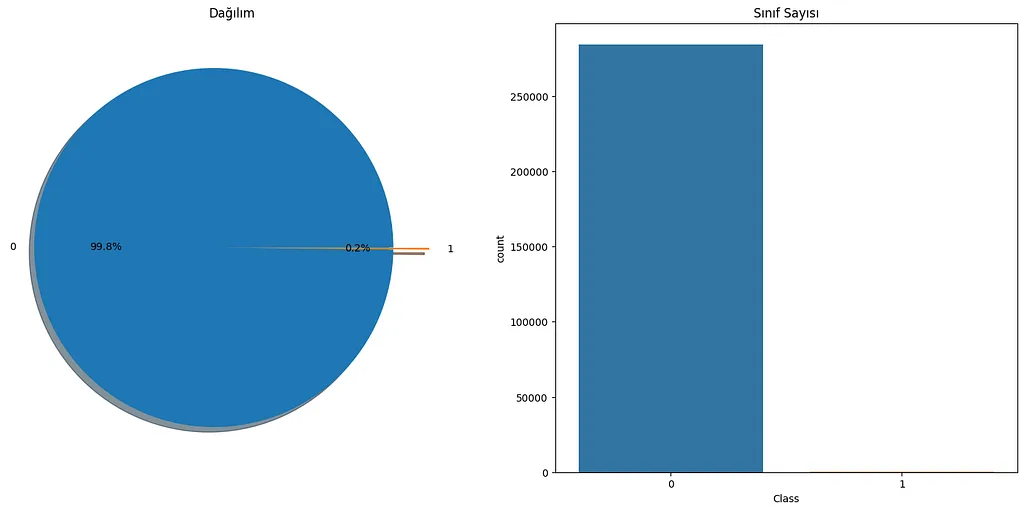
# Time ve Amount değişkenlerini standartlaştırma
rob_scaler = RobustScaler()
df['Amount'] = rob_scaler.fit_transform(df['Amount'].values.reshape(-1,1))
df['Time'] = rob_scaler.fit_transform(df['Time'].values.reshape(-1,1))
df.head()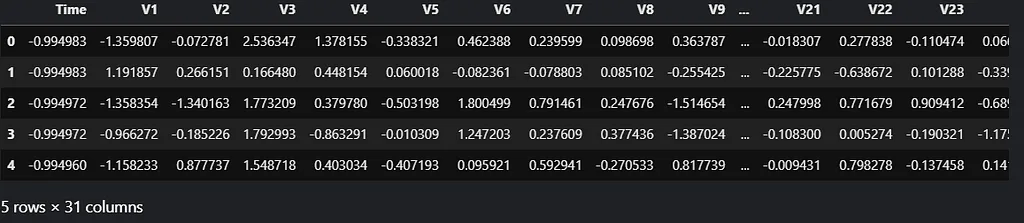
# Hold out yöntemi uygulayıp veri setini eğitim ve test olarak ikiye ayırıyoruz.(%80,%20)
X = df.drop("Class", axis=1)
y = df["Class"]
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.20, random_state=123456)
# modelin tanımlanıp, eğitilmesi ve başarı skoru
model = LogisticRegression(random_state=123456)
model.fit(X_train, y_train)
y_pred = model.predict(X_test)
accuracy = accuracy_score(y_test, y_pred)
print("Accuracy: %.3f"%(accuracy))Accuracy: 0.999L’exactitude (accuracy) est la part des prédictions correctes parmi toutes les prédictions. Notre modèle atteint 0,999. On pourrait dire qu’il fonctionne parfaitement, non ? Regardons aussi la matrice de confusion.
La matrice de confusion
La matrice de confusion est un tableau qui résume la performance d’un modèle de classification sur les données de test. Elle contient les quatre combinaisons de valeurs prédites et réelles. Ici, la fraude est la classe positive :
- Vrai positif (TP) : prédit positif, à raison.
- Vrai négatif (TN) : prédit négatif, à raison.
- Faux positif (FP) : prédit positif, à tort.
- Faux négatif (FN) : prédit négatif, à tort.
def plot_confusion_matrix(cm, classes,
                          title='Confusion matrix',
                          cmap=plt.cm.Blues):

    plt.rcParams.update({'font.size': 19})
    plt.imshow(cm, interpolation='nearest', cmap=cmap)
    plt.title(title,fontdict={'size':'16'})
    plt.colorbar()
    tick_marks = np.arange(len(classes))
    plt.xticks(tick_marks, classes, rotation=45,fontsize=12,color="blue")
    plt.yticks(tick_marks, classes,fontsize=12,color="blue")
    rc('font', weight='bold')
    fmt = '.1f'
    thresh = cm.max()
    for i, j in itertools.product(range(cm.shape[0]), range(cm.shape[1])):
        plt.text(j, i, format(cm[i, j], fmt),
                 horizontalalignment="center",
                 color="red")

    plt.ylabel('True label',fontdict={'size':'16'})
    plt.xlabel('Predicted label',fontdict={'size':'16'})
    plt.tight_layout()

plot_confusion_matrix(confusion_matrix(y_test, y_pred=y_pred), classes=['Non Fraud','Fraud'],
                      title='Confusion matrix')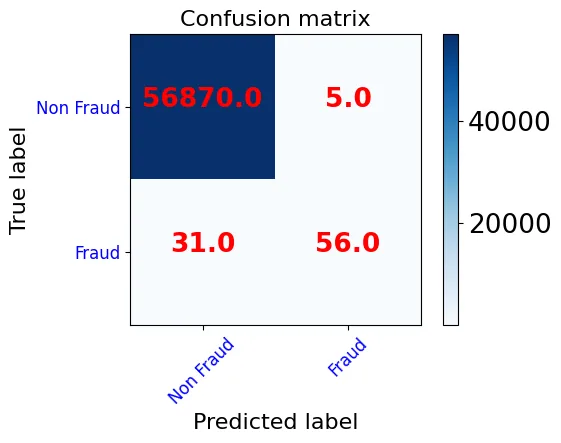
- Sur les 56 875 transactions réellement normales, 56 870 sont bien prédites et 5 sont signalées à tort comme fraude (FP).
- Sur les 87 fraudes réelles, 56 sont détectées (TP) et 31 manquées (FN).
Le modèle annonce 0,999 d’exactitude, mais la matrice de confusion montre un taux d’erreur élevé dans la classe fraude. Le modèle prédit bien la classe majoritaire et mal la minoritaire. Comme les transactions normales sont bien plus nombreuses que les transactions frauduleuses, le modèle semble performant simplement parce qu’il prédit la classe normale.
La leçon : l’exactitude n’est pas une bonne mesure de performance pour les modèles de classification, surtout quand les données sont aussi déséquilibrées que les nôtres. Voyons comment traiter le déséquilibre, quelles méthodes appliquer et avec quelles métriques mesurer la performance.
Choisir les bonnes métriques
Nous avons vu que l’exactitude ne suffit pas ; il nous faut d’autres métriques pour mesurer la performance.
Précision : la part des prédictions positives qui sont réellement positives. Une précision faible signifie beaucoup de faux positifs. Précision = TP / (TP + FP).
Rappel (recall) : la part des positifs réels que nous avons prédits comme positifs. Un rappel faible signifie beaucoup de faux négatifs ; il doit être le plus élevé possible. Rappel = TP / (TP + FN).
Score F1 : il est difficile de comparer un modèle à faible précision et fort rappel avec un modèle présentant le profil inverse. Le score F1 mesure les deux à la fois, comme moyenne harmonique de la précision et du rappel. F1 = 2 × (Précision × Rappel) / (Précision + Rappel).
Regardons ces métriques pour notre modèle. Le rapport de classification présente les principales métriques par classe.
#sınıflandırma raporu
print(classification_report(y_test, y_pred))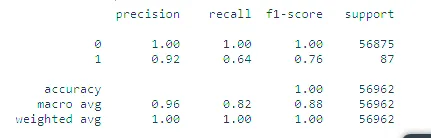
Précision par classe :
- Classe 0 (normale) : 56 870 + 31 = 56 901 transactions prédites normales, dont 56 870 à raison. Précision ≈ 1,00 (56 870 / 56 901).
- Classe 1 (fraude) : 5 + 56 = 61 transactions prédites frauduleuses, dont 56 à raison. Précision ≈ 0,92 (56 / 61).
Rappel par classe :
- Classe 0 (normale) : sur 56 870 + 5 = 56 875 transactions normales, 56 870 sont bien prédites. Rappel ≈ 1,00.
- Classe 1 (fraude) : sur 31 + 56 = 87 transactions frauduleuses, 56 sont bien prédites. Rappel = 56 / 87 ≈ 0,64.
Les valeurs de rappel montrent clairement l’échec sur la classe 1. Le score F1 est la moyenne harmonique du rappel et de la précision. Le support est le nombre réel d’exemples par classe ; l’écart entre les classes révèle une faiblesse structurelle des mesures, puisque le déséquilibre lui-même les influence.
La courbe ROC
La courbe ROC est un graphique qui représente la performance d’un modèle de classification pour l’ensemble des seuils de décision. Elle met en relation deux valeurs :
- Le taux de vrais positifs (TPR), c’est-à-dire le rappel : TPR = TP / (TP + FN)
- Le taux de faux positifs (FPR), c’est-à-dire le taux de fausses alertes sur les transactions normales : FPR = FP / (FP + TN)
La courbe trace le TPR en fonction du FPR pour différents seuils ; elle part de (0,0) et finit en (1,1). Un bon modèle produit une courbe qui monte rapidement de 0 à 1.
L’AUC (aire sous la courbe ROC)
L’AUC résume la courbe ROC en un seul nombre : elle mesure l’aire totale sous la courbe, de (0,0) à (1,1). La meilleure valeur est 1 ; le hasard donne 0,5.
# Auc Roc Curve
def generate_auc_roc_curve(clf, X_test):
    y_pred_proba = clf.predict_proba(X_test)[:, 1]
    fpr, tpr, thresholds = roc_curve(y_test,  y_pred_proba)
    auc = roc_auc_score(y_test, y_pred_proba)
    plt.plot(fpr,tpr)
    plt.show()
    pass

generate_auc_roc_curve(model, X_test)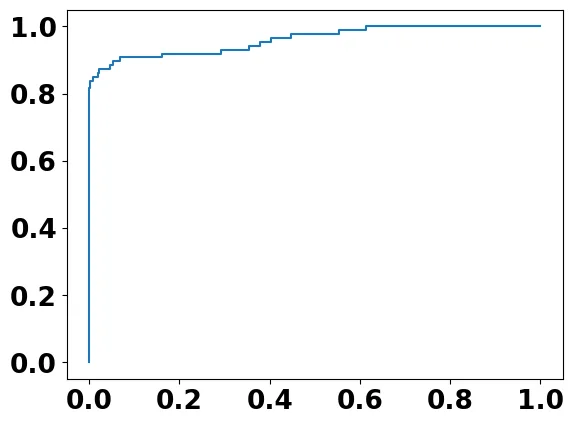
y_pred_proba = model.predict_proba(X_test)[:, 1]
auc = roc_auc_score(y_test, y_pred_proba)
print("AUC ROC Curve with Area Under the curve = %.3f"%auc)
AUC ROC Curve with Area Under the curve = 0.961Remarque : l’AUC évalue la performance globale de classification. Comme elle ne donne pas plus de poids à une classe qu’à l’autre, elle reflète mal la performance sur la classe minoritaire.
Appliquons maintenant plusieurs méthodes au jeu de données pour corriger le déséquilibre.
Important : ces méthodes doivent être appliquées uniquement au jeu d’entraînement. Appliquées au jeu de test, elles rendent toute évaluation correcte impossible.
Le rééchantillonnage
Le rééchantillonnage (resampling) équilibre un jeu de données en ajoutant des exemples à la classe minoritaire ou en retirant des exemples de la classe majoritaire. Le sous-échantillonnage retire des exemples majoritaires ; le suréchantillonnage multiplie les exemples minoritaires.
Suréchantillonnage
Le suréchantillonnage (oversampling) équilibre les données en dupliquant des exemples de la classe minoritaire.
Suréchantillonnage aléatoire :
- Des exemples minoritaires choisis au hasard sont ajoutés pour équilibrer le jeu de données.
- Utilisable quand le jeu de données est petit.
- Peut entraîner du surapprentissage (overfitting).
RandomOverSampler prend un argument sampling_strategy. Avec sampling_strategy='minority', la classe minoritaire est multipliée jusqu’à égaler la classe majoritaire. L’argument accepte aussi une valeur décimale : si la classe majoritaire compte 1 000 exemples et la classe minoritaire 100, sampling_strategy=0.5 porte la classe minoritaire à 500.
# random oversampling önce eğitim setindeki sınıf sayısı
y_train.value_counts()
0 227440
1 405
Name: Class, dtype: int64# RandomOver Sampling uygulanması (Eğitim setine uygulanıyor)
from imblearn.over_sampling import RandomOverSampler
oversample = RandomOverSampler(sampling_strategy='minority')
X_randomover, y_randomover = oversample.fit_resample(X_train, y_train)# random oversampling den sonra eğitim setinin sınıf sayısı
y_randomover.value_counts()1 227440
0 227440
Name: Class, dtype: int64# modelin eğitilmesi ve başarı oranı
model.fit(X_randomover, y_randomover)
y_pred = model.predict(X_test)
accuracy = accuracy_score(y_test, y_pred)
print("Accuracy: %.3f%%" % (accuracy))Accuracy: 0.977plot_confusion_matrix(confusion_matrix(y_test, y_pred=y_pred), classes=['Non Fraud','Fraud'],
title='Confusion matrix')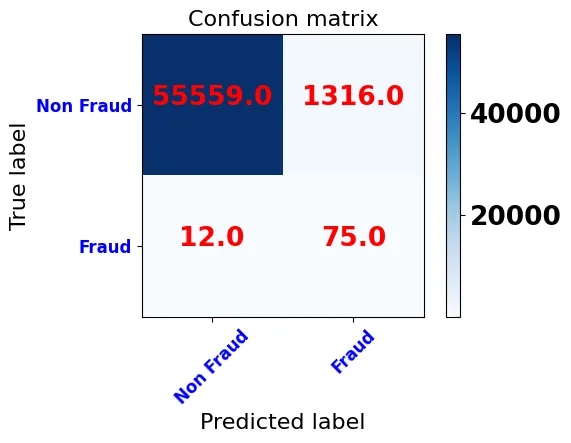
#sınıflandırma raporu
print(classification_report(y_test, y_pred)) precision recall f1-score support
0 1.00 0.98 0.99 56875
1 0.05 0.86 0.10 87
accuracy 0.98 56962
macro avg 0.53 0.92 0.55 56962
weighted avg 1.00 0.98 0.99 56962Après le suréchantillonnage aléatoire, l’exactitude du modèle tombe à 0,977. La matrice de confusion et le rapport de classification montrent que la plupart des transactions signalées comme fraude sont de fausses alertes, ce qui fait chuter la précision de la classe 1 à 0,05. En contrepartie, le rappel de la classe 1 monte à 0,86 : 75 des 87 fraudes sont détectées. Les transactions normales sont un peu moins bien prédites qu’avec le premier modèle, mais ce bond dans la détection de la fraude est une raison solide de préférer le modèle entraîné après suréchantillonnage aléatoire.
Suréchantillonnage SMOTE :
Pour éviter le surapprentissage, on génère des exemples minoritaires synthétiques plutôt que des copies :
- On choisit au hasard un exemple de la classe minoritaire.
- On détermine ses k plus proches voisins.
- On choisit un voisin au hasard ; on trace dans l’espace des variables un segment entre l’exemple et ce voisin, et l’exemple synthétique est créé sur ce segment.
# smote dan önce eğitim setindeki sınıf sayısı
y_train.value_counts()0 227440
1 405
Name: Class, dtype: int64# Smote uygulanması (Eğitim setine uygulanıyor)
from imblearn.over_sampling import SMOTE
oversample = SMOTE()
X_smote, y_smote = oversample.fit_resample(X_train, y_train)# smote dan sonra eğitim setinin sınıf sayısı
y_smote.value_counts()1 227440
0 227440
Name: Class, dtype: int64# modelin eğitilmesi ve başarı oranı
model.fit(X_smote, y_smote)
y_pred = model.predict(X_test)
accuracy = accuracy_score(y_test, y_pred)
print("Accuracy: %.3f%%" % (accuracy))Accuracy: 0.975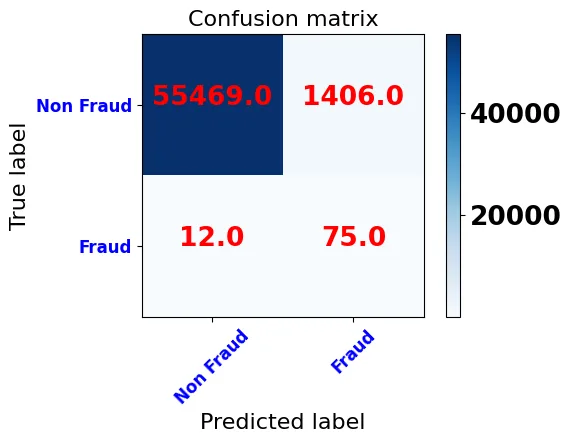
plot_confusion_matrix(confusion_matrix(y_test, y_pred=y_pred), classes=['Non Fraud','Fraud'],
                      title='Confusion matrix')
#sınıflandırma raporu
print(classification_report(y_test, y_pred)) precision recall f1-score support
0 1.00 0.98 0.99 56875
1 0.05 0.86 0.10 87
accuracy 0.98 56962
macro avg 0.53 0.92 0.54 56962
weighted avg 1.00 0.98 0.99 56962Les résultats après SMOTE ressemblent à ceux du suréchantillonnage aléatoire : de nouveau, 75 des 87 fraudes sont détectées, tandis que les fausses alertes montent à 1406.
Sous-échantillonnage
Le sous-échantillonnage (undersampling) équilibre les données en retirant des exemples de la classe majoritaire et convient aux grands jeux de données. Le nôtre n’est pas assez grand pour que cette approche donne de bons résultats, mais nous expliquons les méthodes et montrons comment en appliquer certaines.
Sous-échantillonnage aléatoire :
- Les exemples à retirer sont choisis au hasard.
- Utilisable si vous disposez d’un grand jeu de données.
- Le choix aléatoire peut faire perdre de l’information.
# random undersampling den önce eğitim setindeki sınıf sayısı
y_train.value_counts()
0 227440
1 405
Name: Class, dtype: int64from imblearn.under_sampling import RandomUnderSampler
# transform the dataset
ranUnSample = RandomUnderSampler()
X_ranUnSample, y_ranUnSample = ranUnSample.fit_resample(X_train, y_train)# Random undersampling sonra
y_ranUnSample.value_counts()1 405
0 405
Name: Class, dtype: int64Sous-échantillonnage NearMiss :
- Limite la perte d’information.
- Repose sur l’algorithme KNN.
- Calcule la distance des exemples majoritaires aux exemples minoritaires.
- Conserve les exemples majoritaires les plus proches de la classe minoritaire, selon un k donné.
Liens de Tomek : pour chaque paire d’exemples les plus proches issus de classes différentes, on retire l’exemple majoritaire, ce qui élargit l’écart entre les deux classes.
Centroïdes de clusters : les exemples peu importants sont retirés du jeu de données ; l’importance d’un exemple est déterminée par clustering.
Sous-échantillonnage et suréchantillonnage peuvent être combinés pour obtenir des jeux de données plus équilibrés.
Autres méthodes
- Collecter davantage de données
- Utiliser le paramètre
class_weight, pour que le modèle apprenne autant de la classe minoritaire que de la classe majoritaire - Examiner la performance d’autres modèles, sans se limiter à un seul
- Changer d’approche, par exemple avec la détection d’anomalies ou de changements
La méthode la plus efficace dépend du jeu de données étudié. C’est en essayant les différentes méthodes et en retenant celle qui convient à vos données que l’on obtient le meilleur résultat.
Références
- Kaggle : sur les jeux de données déséquilibrés (Yasin Tanış, en turc)
- Miuul : qu’est-ce qu’un jeu de données déséquilibré (en turc)
- Machine Learning Mastery : Random oversampling and undersampling
- Machine Learning Mastery : SMOTE oversampling
- Towards Data Science : Understanding the confusion matrix
- Towards Data Science : Understanding the AUC-ROC curve
- Machine Learning Mastery : Tactics to combat imbalanced classes