

Ce este un set de date dezechilibrat și cum îl gestionăm?
Scris de Yasin TANIŞ
Ce este un set de date dezechilibrat
Construiți un model de clasificare pentru o afacere, iar acesta obține o acuratețe de 95 %. Totul pare în regulă. Modelul este pus în funcțiune și curând cineva observă că prezice mereu aceeași clasă. Privind din nou datele, constatați că clasa pe care nu o detectează niciodată reprezintă doar 5 % din date. Eșecul modelului vine dintr-un set de date dezechilibrat.
Seturile de date dezechilibrate apar în problemele de clasificare atunci când clasele sunt departe de a fi distribuite uniform. Problema este că clasa majoritară o copleșește pe cea minoritară: modelul înclină spre majoritate și clasifică prost minoritatea.
Când avem date dezechilibrate, putem observa corect și restabili echilibrul cu aceste metode:
- Alegerea metricilor potrivite: precision, recall, scor F1, curba ROC și AUC
- Reeșantionarea: oversampling (aleator și SMOTE) și undersampling (aleator, NearMiss, legături Tomek, centroizi de clustere)
- Colectarea mai multor date
- Folosirea parametrului
class_weightal modelelor de clasificare, pentru ca modelul să învețe în egală măsură din clasa minoritară și din cea majoritară - Analiza performanței altor modele, în loc să ne bazăm pe unul singur
- Adoptarea unei abordări diferite, precum detectarea anomaliilor sau a schimbărilor
Mai întâi examinăm setul dezechilibrat Credit Card Fraud Detection, apoi aplicăm mai multe metode pentru a face față dezechilibrului.
Examinarea setului de date
Detectarea fraudelor este important pentru companiile emitente de carduri de credit: ele nu vor ca clienții să fie taxați pentru cumpărături pe care nu le-au făcut.
Set de date: creditcard.csv (Kaggle)
Vrem să folosim acest set de date pentru a construi un model care detectează tranzacțiile frauduloase. Datele provin din tranzacții cu carduri efectuate în Europa în septembrie 2013; fiecare tranzacție este etichetată cu 1 dacă e fraudă și cu 0 dacă nu. Din motive de confidențialitate există puține informații de context, iar toate variabilele în afară de Time și Amount au fost transformate cu PCA (analiza componentelor principale).
Time: secundele scurse de la prima tranzacție până la fiecare tranzacțieAmount: suma tranzacției
Mai întâi citim datele, verificăm valorile lipsă și analizăm distribuția variabilei Class. Apoi standardizăm Amount și Time, împărțim datele prin metoda hold-out și construim un model de clasificare cu regresie logistică. Vom lucra cu un singur model.
# Gerekli kütüphaneler
import pandas as pd
import numpy as np
from sklearn.preprocessing import RobustScaler
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score
from sklearn.metrics import confusion_matrix, classification_report,f1_score,recall_score,roc_auc_score, roc_curve
import matplotlib.pyplot as plt
import seaborn as sns
from matplotlib import rc,rcParams
import itertools

import warnings
warnings.filterwarnings("ignore", category=DeprecationWarning)
warnings.filterwarnings("ignore", category=FutureWarning)
warnings.filterwarnings("ignore", category=UserWarning)
# Veri setinin okutulması
df = pd.read_csv("creditcard.csv")
df.head()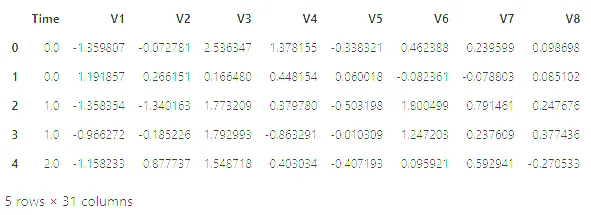
# Veri setindeki değişken ve gözlem sayısı
print("Gözlem sayısı : " ,len(df))
print("Değişken sayısı : ", len(df.columns))
Gözlem sayısı : 284807
Değişken sayısı : 31(Codul afișează etichetele în turcă: numărul de observații și numărul de variabile.)
# veri setindeki değişkenlerin tiplerini ve boş değer içerip içermediğini gözlemlemek istiyoruz
df.info()
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 284807 entries, 0 to 284806
Data columns (total 31 columns):
# Column Non-Null Count Dtype
--- ------ -------------- -----
0 Time 284807 non-null float64
1 V1 284807 non-null float64
2 V2 284807 non-null float64
3 V3 284807 non-null float64
4 V4 284807 non-null float64
5 V5 284807 non-null float64
6 V6 284807 non-null float64
7 V7 284807 non-null float64
8 V8 284807 non-null float64
9 V9 284807 non-null float64
10 V10 284807 non-null float64
11 V11 284807 non-null float64
12 V12 284807 non-null float64
13 V13 284807 non-null float64
14 V14 284807 non-null float64
15 V15 284807 non-null float64
16 V16 284807 non-null float64
17 V17 284807 non-null float64
18 V18 284807 non-null float64
19 V19 284807 non-null float64
20 V20 284807 non-null float64
21 V21 284807 non-null float64
22 V22 284807 non-null float64
23 V23 284807 non-null float64
24 V24 284807 non-null float64
25 V25 284807 non-null float64
26 V26 284807 non-null float64
27 V27 284807 non-null float64
28 V28 284807 non-null float64
29 Amount 284807 non-null float64
30 Class 284807 non-null int64
dtypes: float64(30), int64(1)
memory usage: 67.4 MB# 1 sınıfının veri setinde bulunma oranı %0.2, 0 sınıfının ise %99.8
f, ax = plt.subplots(1, 2, figsize=(18, 8))
# Sınıf dağılımı
class_counts = df['Class'].value_counts().sort_values(ascending=False)
# Sınıf sayısına göre patlamayı belirleyin
explode = [0.1] * len(class_counts)
# Sınıf dağılımı için pasta grafik
ax[0].pie(class_counts, labels=class_counts.index, autopct='%1.1f%%', explode=explode, shadow=True)
ax[0].set_title('Dağılım')
ax[0].set_ylabel('')
# Sınıf dağılımı için sayım grafiği (seaborn kullanarak)
sns.countplot(x='Class', data=df, ax=ax[1])
ax[1].set_title('Sınıf Sayısı')
plt.show()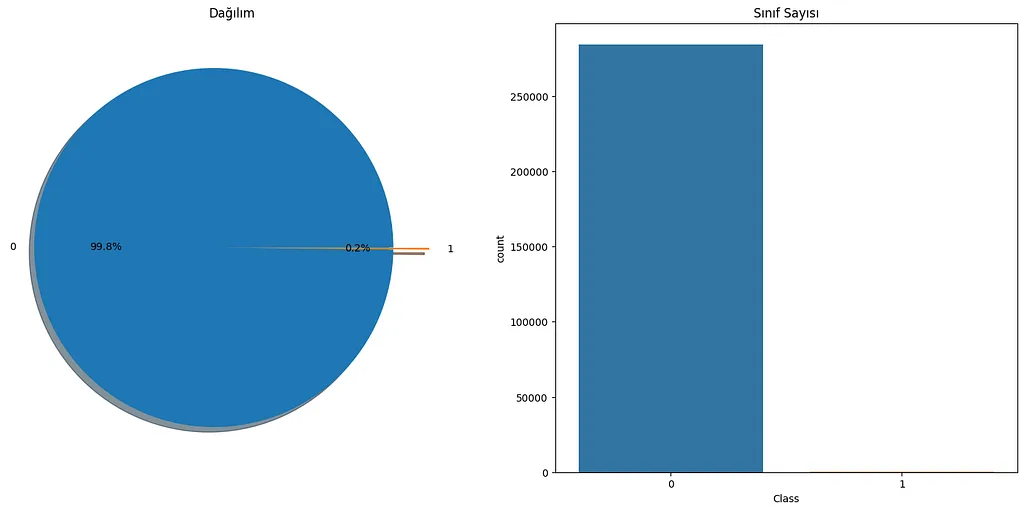
# Time ve Amount değişkenlerini standartlaştırma
rob_scaler = RobustScaler()
df['Amount'] = rob_scaler.fit_transform(df['Amount'].values.reshape(-1,1))
df['Time'] = rob_scaler.fit_transform(df['Time'].values.reshape(-1,1))
df.head()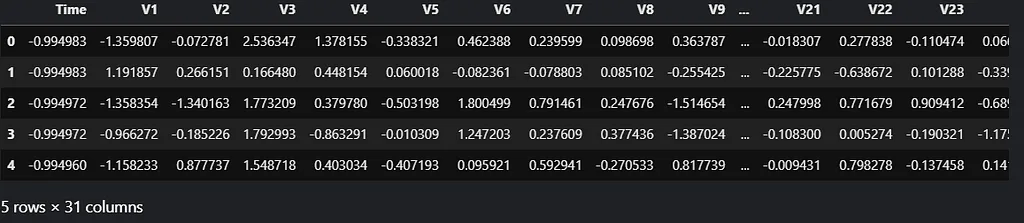
# Hold out yöntemi uygulayıp veri setini eğitim ve test olarak ikiye ayırıyoruz.(%80,%20)
X = df.drop("Class", axis=1)
y = df["Class"]
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.20, random_state=123456)
# modelin tanımlanıp, eğitilmesi ve başarı skoru
model = LogisticRegression(random_state=123456)
model.fit(X_train, y_train)
y_pred = model.predict(X_test)
accuracy = accuracy_score(y_test, y_pred)
print("Accuracy: %.3f"%(accuracy))Accuracy: 0.999Acuratețea este proporția predicțiilor corecte din totalul predicțiilor. Modelul nostru obține 0,999. Am putea spune că funcționează perfect, nu? Să ne uităm și la matricea de confuzie.
Matricea de confuzie
Matricea de confuzie este un tabel care rezumă cum se descurcă un model de clasificare pe datele de test. Conține cele patru combinații de valori prezise și reale. Aici considerăm frauda clasa pozitivă:
- Adevărat pozitiv (TP): predicția este pozitivă și corectă.
- Adevărat negativ (TN): predicția este negativă și corectă.
- Fals pozitiv (FP): predicția este pozitivă, dar greșită.
- Fals negativ (FN): predicția este negativă, dar greșită.
def plot_confusion_matrix(cm, classes,
                          title='Confusion matrix',
                          cmap=plt.cm.Blues):

    plt.rcParams.update({'font.size': 19})
    plt.imshow(cm, interpolation='nearest', cmap=cmap)
    plt.title(title,fontdict={'size':'16'})
    plt.colorbar()
    tick_marks = np.arange(len(classes))
    plt.xticks(tick_marks, classes, rotation=45,fontsize=12,color="blue")
    plt.yticks(tick_marks, classes,fontsize=12,color="blue")
    rc('font', weight='bold')
    fmt = '.1f'
    thresh = cm.max()
    for i, j in itertools.product(range(cm.shape[0]), range(cm.shape[1])):
        plt.text(j, i, format(cm[i, j], fmt),
                 horizontalalignment="center",
                 color="red")

    plt.ylabel('True label',fontdict={'size':'16'})
    plt.xlabel('Predicted label',fontdict={'size':'16'})
    plt.tight_layout()

plot_confusion_matrix(confusion_matrix(y_test, y_pred=y_pred), classes=['Non Fraud','Fraud'],
                      title='Confusion matrix')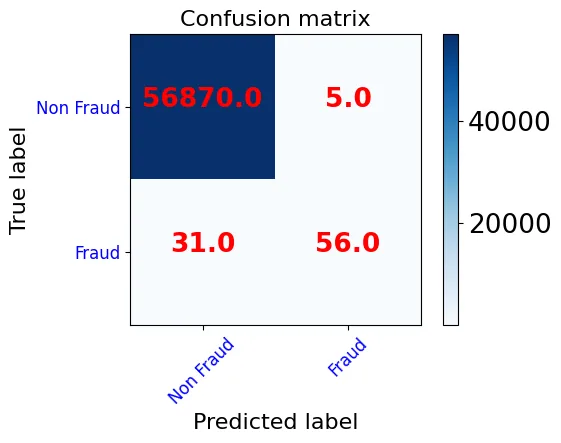
- Din cele 56875 de tranzacții care sunt de fapt normale, 56870 sunt prezise corect și 5 sunt marcate greșit drept fraudă (FP).
- Din cele 87 de tranzacții care sunt de fapt fraude, 56 sunt detectate (TP) și 31 sunt ratate (FN).
Modelul pretinde o acuratețe de 0,999, dar matricea de confuzie arată o rată mare de erori în clasa fraudelor. Modelul prezice bine clasa majoritară și prost clasa minoritară. Fiindcă tranzacțiile normale sunt mult mai numeroase decât cele frauduloase, modelul pare performant prezicând clasa normală.
Lecția: acuratețea nu este o măsură bună a performanței pentru modelele de clasificare, mai ales când datele sunt la fel de dezechilibrate ca ale noastre. Să vedem cum gestionăm dezechilibrul, ce metode aplicăm și cu ce metrici măsurăm performanța.
Alegerea metricilor potrivite
Am văzut că acuratețea nu ajunge; avem nevoie de alte metrici pentru a măsura performanța.
Precision (precizia): proporția predicțiilor pozitive care sunt cu adevărat pozitive. O precizie mică înseamnă multe cazuri fals pozitive. Precision = TP / (TP + FP).
Recall (sensibilitatea): proporția cazurilor pozitive reale pe care le-am prezis ca pozitive. Un recall mic înseamnă multe cazuri fals negative; trebuie să fie cât mai mare. Recall = TP / (TP + FN).
Scorul F1: e greu de comparat un model cu precizie mică și recall mare cu unul aflat în situația inversă. Scorul F1 le măsoară împreună ca medie armonică a preciziei și recall-ului. F1 = 2 × (Precision × Recall) / (Precision + Recall).
Să analizăm aceste metrici pentru modelul nostru. Raportul de clasificare arată principalele metrici pe clase.
#sınıflandırma raporu
print(classification_report(y_test, y_pred))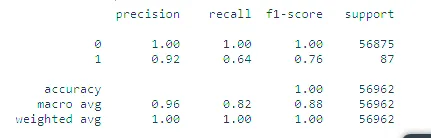
Precizia pe clase:
- Clasa 0 (normale): 56870 + 31 = 56901 tranzacții prezise ca normale, dintre care 56870 corect. Precision ≈ 1,00 (56870 / 56901).
- Clasa 1 (fraudă): 5 + 56 = 61 de tranzacții prezise ca fraudă, dintre care 56 corect. Precision ≈ 0,92 (56 / 61).
Recall pe clase:
- Clasa 0 (normale): din 56870 + 5 = 56875 de tranzacții normale, 56870 sunt prezise corect. Recall ≈ 1,00.
- Clasa 1 (fraudă): din 31 + 56 = 87 de tranzacții frauduloase, 56 sunt prezise corect. Recall = 56 / 87 ≈ 0,64.
Valorile recall-ului arată limpede eșecul pe clasa 1. Scorul F1 este media armonică a recall-ului și a preciziei. Support (suportul) este numărul real de exemple din fiecare clasă; diferența dintre clase arată o slăbiciune structurală a măsurătorilor, fiindcă dezechilibrul însuși le influențează.
Curba ROC
Curba ROC este un grafic al performanței unui model de clasificare la toate pragurile de decizie. Ea reprezintă două valori:
- Rata cazurilor adevărat pozitive (TPR), adică recall-ul: TPR = TP / (TP + FN)
- Rata cazurilor fals pozitive (FPR), adică rata alarmelor false la tranzacțiile normale: FPR = FP / (FP + TN)
Curba trasează TPR față de FPR la praguri diferite; pornește din (0,0) și se termină în (1,1). Un model bun produce o curbă care urcă repede de la 0 la 1.
AUC (aria de sub curba ROC)
AUC rezumă curba ROC într-un singur număr: măsoară toată aria de sub curbă de la (0,0) la (1,1). Cea mai bună valoare este 1; o predicție la întâmplare dă 0,5.
# Auc Roc Curve
def generate_auc_roc_curve(clf, X_test):
    y_pred_proba = clf.predict_proba(X_test)[:, 1]
    fpr, tpr, thresholds = roc_curve(y_test,  y_pred_proba)
    auc = roc_auc_score(y_test, y_pred_proba)
    plt.plot(fpr,tpr)
    plt.show()
    pass

generate_auc_roc_curve(model, X_test)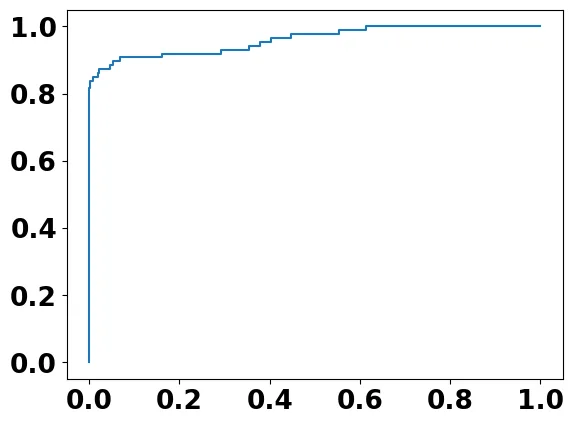
y_pred_proba = model.predict_proba(X_test)[:, 1]
auc = roc_auc_score(y_test, y_pred_proba)
print("AUC ROC Curve with Area Under the curve = %.3f"%auc)
AUC ROC Curve with Area Under the curve = 0.961Notă: AUC evaluează performanța generală de clasificare. Fiindcă nu acordă unei clase mai multă greutate decât celeilalte, nu reflectă bine performanța pe clasa minoritară.
Acum să aplicăm pe setul de date câteva metode pentru a elimina dezechilibrul.
Important: aceste metode se aplică doar pe setul de antrenare. Aplicate pe setul de test, fac imposibilă o evaluare corectă.
Reeșantionarea
Reeșantionarea (resampling) face un set de date mai echilibrat adăugând exemple noi în clasa minoritară sau eliminând exemple din cea majoritară. Undersampling-ul elimină exemple ale majorității; oversampling-ul multiplică exemplele minorității.
Oversampling
Oversampling-ul echilibrează datele duplicând exemple ale clasei minoritare.
Oversampling aleator:
- Se adaugă exemple alese aleator din clasa minoritară pentru a echilibra setul.
- Se poate folosi când setul este mic.
- Poate duce la supraînvățare (overfitting).
RandomOverSampler primește argumentul sampling_strategy. Cu sampling_strategy='minority' clasa minoritară se multiplică până egalează clasa majoritară. Argumentul acceptă și o valoare zecimală: dacă clasa majoritară are 1000 de exemple și cea minoritară 100, sampling_strategy=0.5 ridică minoritatea la 500.
# random oversampling önce eğitim setindeki sınıf sayısı
y_train.value_counts()
0 227440
1 405
Name: Class, dtype: int64# RandomOver Sampling uygulanması (Eğitim setine uygulanıyor)
from imblearn.over_sampling import RandomOverSampler
oversample = RandomOverSampler(sampling_strategy='minority')
X_randomover, y_randomover = oversample.fit_resample(X_train, y_train)# random oversampling den sonra eğitim setinin sınıf sayısı
y_randomover.value_counts()1 227440
0 227440
Name: Class, dtype: int64# modelin eğitilmesi ve başarı oranı
model.fit(X_randomover, y_randomover)
y_pred = model.predict(X_test)
accuracy = accuracy_score(y_test, y_pred)
print("Accuracy: %.3f%%" % (accuracy))Accuracy: 0.977plot_confusion_matrix(confusion_matrix(y_test, y_pred=y_pred), classes=['Non Fraud','Fraud'],
title='Confusion matrix')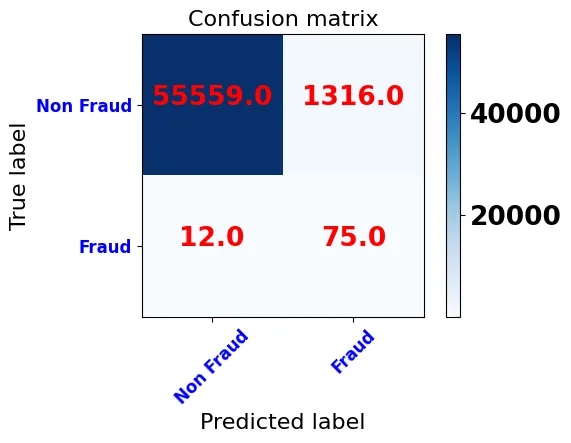
#sınıflandırma raporu
print(classification_report(y_test, y_pred)) precision recall f1-score support
0 1.00 0.98 0.99 56875
1 0.05 0.86 0.10 87
accuracy 0.98 56962
macro avg 0.53 0.92 0.55 56962
weighted avg 1.00 0.98 0.99 56962După oversampling-ul aleator, acuratețea modelului scade la 0,977. Matricea de confuzie și raportul de clasificare arată că majoritatea tranzacțiilor marcate drept fraudă sunt alarme false, ceea ce coboară precizia clasei 1 la 0,05. În schimb, recall-ul clasei 1 urcă la 0,86: sunt detectate 75 din cele 87 de fraude. Tranzacțiile normale sunt prezise puțin mai slab decât la primul model, dar acest salt în detectarea fraudelor este un motiv puternic să preferăm modelul antrenat după oversampling-ul aleator.
Oversampling cu SMOTE:
Pentru a evita supraînvățarea, în loc de copii se generează exemple sintetice ale clasei minoritare:
- Se alege aleator un exemplu din clasa minoritară.
- Se determină cei mai apropiați k vecini ai săi.
- Se alege aleator un vecin; în spațiul caracteristicilor se trasează un segment între exemplu și vecin, iar exemplul sintetic se creează pe acest segment.
# smote dan önce eğitim setindeki sınıf sayısı
y_train.value_counts()0 227440
1 405
Name: Class, dtype: int64# Smote uygulanması (Eğitim setine uygulanıyor)
from imblearn.over_sampling import SMOTE
oversample = SMOTE()
X_smote, y_smote = oversample.fit_resample(X_train, y_train)# smote dan sonra eğitim setinin sınıf sayısı
y_smote.value_counts()1 227440
0 227440
Name: Class, dtype: int64# modelin eğitilmesi ve başarı oranı
model.fit(X_smote, y_smote)
y_pred = model.predict(X_test)
accuracy = accuracy_score(y_test, y_pred)
print("Accuracy: %.3f%%" % (accuracy))Accuracy: 0.975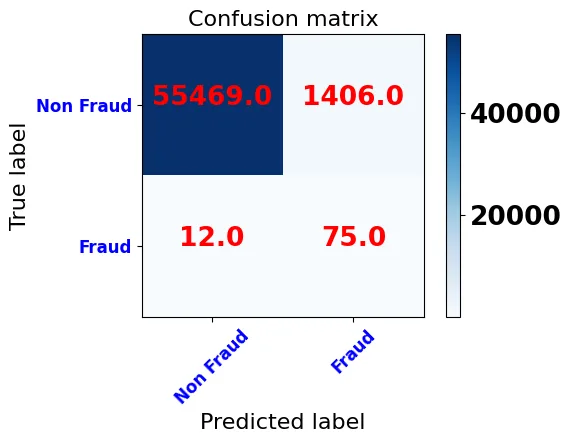
plot_confusion_matrix(confusion_matrix(y_test, y_pred=y_pred), classes=['Non Fraud','Fraud'],
                      title='Confusion matrix')
#sınıflandırma raporu
print(classification_report(y_test, y_pred)) precision recall f1-score support
0 1.00 0.98 0.99 56875
1 0.05 0.86 0.10 87
accuracy 0.98 56962
macro avg 0.53 0.92 0.54 56962
weighted avg 1.00 0.98 0.99 56962Rezultatele după SMOTE seamănă cu oversampling-ul aleator: din nou sunt detectate 75 din 87 de fraude, iar alarmele false cresc la 1406.
Undersampling
Undersampling-ul echilibrează datele eliminând exemple din clasa majoritară și se potrivește seturilor mari. Setul nostru nu este suficient de mare pentru ca metoda să funcționeze bine, dar explicăm metodele și arătăm cum se aplică unele dintre ele.
Undersampling aleator:
- Exemplele de eliminat se aleg aleator.
- Se poate folosi dacă aveți un set de date mare.
- Alegerea aleatoare poate duce la pierdere de informație.
# random undersampling den önce eğitim setindeki sınıf sayısı
y_train.value_counts()
0 227440
1 405
Name: Class, dtype: int64from imblearn.under_sampling import RandomUnderSampler
# transform the dataset
ranUnSample = RandomUnderSampler()
X_ranUnSample, y_ranUnSample = ranUnSample.fit_resample(X_train, y_train)# Random undersampling sonra
y_ranUnSample.value_counts()1 405
0 405
Name: Class, dtype: int64Undersampling cu NearMiss:
- Reduce pierderea de informație.
- Se bazează pe algoritmul KNN.
- Calculează distanța dintre exemplele majorității și cele ale minorității.
- Păstrează exemplele majorității cele mai apropiate de clasa minoritară, în funcție de un k dat.
Legături Tomek: pentru fiecare pereche de exemple cele mai apropiate din clase diferite se elimină exemplul majorității, ceea ce mărește distanța dintre clase.
Centroizi de clustere: exemplele neimportante sunt eliminate din set; importanța unui exemplu se stabilește prin clusterizare.
Undersampling-ul și oversampling-ul pot fi combinate pentru a obține seturi de date mai echilibrate.
Alte metode
- Colectarea mai multor date
- Folosirea parametrului
class_weight, pentru ca modelul să învețe în egală măsură din clasa minoritară și din cea majoritară - Analiza performanței altor modele, nu doar a unuia
- Adoptarea unei abordări diferite, precum detectarea anomaliilor sau a schimbărilor
Metoda care funcționează cel mai bine depinde de setul de date în cauză. Cel mai bun rezultat îl obțineți încercând metodele și alegând-o pe cea potrivită datelor dumneavoastră.
Surse
- Kaggle: Despre seturile de date dezechilibrate (Yasin Tanış, în turcă)
- Miuul: Ce este un set de date dezechilibrat (în turcă)
- Machine Learning Mastery: Random oversampling and undersampling
- Machine Learning Mastery: SMOTE oversampling
- Towards Data Science: Understanding the confusion matrix
- Towards Data Science: Understanding the AUC-ROC curve
- Machine Learning Mastery: Tactics to combat imbalanced classes