

¿Qué es un conjunto de datos desequilibrado y cómo se aborda?
Escrito por Yasin TANIŞ
Qué es un conjunto de datos desequilibrado
Supongamos que usted construye un modelo de clasificación para una empresa y obtiene un 95 % de exactitud. Todo parece ir bien. El modelo entra en uso y pronto alguien nota que siempre predice la misma clase. Al volver a revisar los datos, descubre que la clase que nunca detecta es apenas el 5 % de los datos. El fallo del modelo se debe a un conjunto de datos desequilibrado.
Los conjuntos de datos desequilibrados aparecen en problemas de clasificación cuando las clases distan mucho de estar repartidas por igual. El problema es que la clase mayoritaria ahoga a la minoritaria: el modelo se inclina hacia la mayoría y clasifica mal a la minoría.
Ante datos desequilibrados, estos son los métodos que podemos usar para observar correctamente y recuperar el equilibrio:
- Elegir las métricas adecuadas: precisión, exhaustividad, puntuación F1, curva ROC y AUC
- Remuestrear: sobremuestreo (aleatorio y SMOTE) y submuestreo (aleatorio, NearMiss, enlaces de Tomek, centroides de clústeres)
- Recoger más datos
- Usar el parámetro
class_weightde los modelos de clasificación para que el modelo aprenda por igual de la minoría y de la mayoría - Mirar el rendimiento de otros modelos en lugar de confiar en uno solo
- Cambiar de enfoque, por ejemplo con detección de anomalías o de cambios
Primero examinamos el conjunto de datos Credit Card Fraud Detection, que está desequilibrado, y después aplicamos varios métodos para hacer frente al desequilibrio.
Examen del conjunto de datos
Detectar el fraude es importante para las compañías de tarjetas de crédito: no quieren cobrar a sus clientes compras que no han hecho.
Conjunto de datos: creditcard.csv (Kaggle)
Con este conjunto queremos construir un modelo que detecte transacciones fraudulentas. Los datos proceden de transacciones con tarjeta realizadas en Europa en septiembre de 2013; cada transacción lleva la etiqueta 1 si es fraude y 0 si no lo es. Por motivos de privacidad hay poca información de contexto, y todas las variables salvo Time y Amount se han transformado con PCA (análisis de componentes principales).
Time: segundos transcurridos entre la primera transacción y cada transacciónAmount: importe de la transacción
Primero leemos los datos, comprobamos si hay valores ausentes y miramos la distribución de la variable Class. Después estandarizamos Amount y Time, dividimos los datos con el método hold-out y construimos un modelo de clasificación con regresión logística. Trabajaremos con un solo modelo.
# Gerekli kütüphaneler
import pandas as pd
import numpy as np
from sklearn.preprocessing import RobustScaler
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score
from sklearn.metrics import confusion_matrix, classification_report,f1_score,recall_score,roc_auc_score, roc_curve
import matplotlib.pyplot as plt
import seaborn as sns
from matplotlib import rc,rcParams
import itertools

import warnings
warnings.filterwarnings("ignore", category=DeprecationWarning)
warnings.filterwarnings("ignore", category=FutureWarning)
warnings.filterwarnings("ignore", category=UserWarning)
# Veri setinin okutulması
df = pd.read_csv("creditcard.csv")
df.head()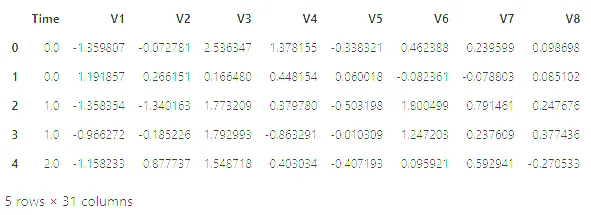
# Veri setindeki değişken ve gözlem sayısı
print("Gözlem sayısı : " ,len(df))
print("Değişken sayısı : ", len(df.columns))
Gözlem sayısı : 284807
Değişken sayısı : 31(El código imprime sus etiquetas en turco: número de observaciones y número de variables.)
# veri setindeki değişkenlerin tiplerini ve boş değer içerip içermediğini gözlemlemek istiyoruz
df.info()
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 284807 entries, 0 to 284806
Data columns (total 31 columns):
# Column Non-Null Count Dtype
--- ------ -------------- -----
0 Time 284807 non-null float64
1 V1 284807 non-null float64
2 V2 284807 non-null float64
3 V3 284807 non-null float64
4 V4 284807 non-null float64
5 V5 284807 non-null float64
6 V6 284807 non-null float64
7 V7 284807 non-null float64
8 V8 284807 non-null float64
9 V9 284807 non-null float64
10 V10 284807 non-null float64
11 V11 284807 non-null float64
12 V12 284807 non-null float64
13 V13 284807 non-null float64
14 V14 284807 non-null float64
15 V15 284807 non-null float64
16 V16 284807 non-null float64
17 V17 284807 non-null float64
18 V18 284807 non-null float64
19 V19 284807 non-null float64
20 V20 284807 non-null float64
21 V21 284807 non-null float64
22 V22 284807 non-null float64
23 V23 284807 non-null float64
24 V24 284807 non-null float64
25 V25 284807 non-null float64
26 V26 284807 non-null float64
27 V27 284807 non-null float64
28 V28 284807 non-null float64
29 Amount 284807 non-null float64
30 Class 284807 non-null int64
dtypes: float64(30), int64(1)
memory usage: 67.4 MB# 1 sınıfının veri setinde bulunma oranı %0.2, 0 sınıfının ise %99.8
f, ax = plt.subplots(1, 2, figsize=(18, 8))
# Sınıf dağılımı
class_counts = df['Class'].value_counts().sort_values(ascending=False)
# Sınıf sayısına göre patlamayı belirleyin
explode = [0.1] * len(class_counts)
# Sınıf dağılımı için pasta grafik
ax[0].pie(class_counts, labels=class_counts.index, autopct='%1.1f%%', explode=explode, shadow=True)
ax[0].set_title('Dağılım')
ax[0].set_ylabel('')
# Sınıf dağılımı için sayım grafiği (seaborn kullanarak)
sns.countplot(x='Class', data=df, ax=ax[1])
ax[1].set_title('Sınıf Sayısı')
plt.show()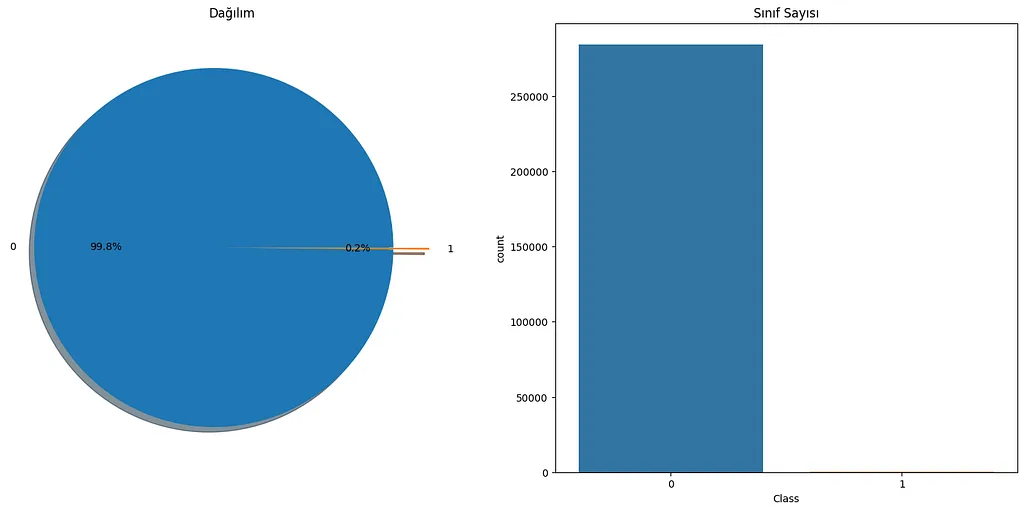
# Time ve Amount değişkenlerini standartlaştırma
rob_scaler = RobustScaler()
df['Amount'] = rob_scaler.fit_transform(df['Amount'].values.reshape(-1,1))
df['Time'] = rob_scaler.fit_transform(df['Time'].values.reshape(-1,1))
df.head()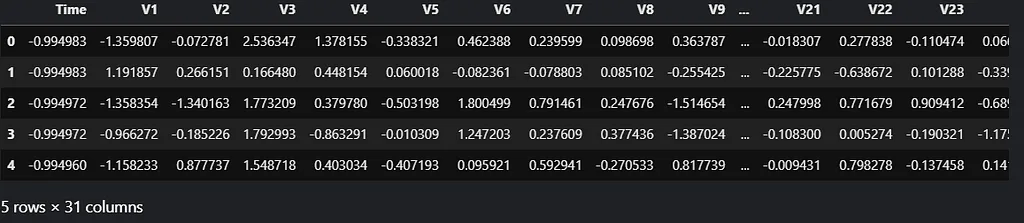
# Hold out yöntemi uygulayıp veri setini eğitim ve test olarak ikiye ayırıyoruz.(%80,%20)
X = df.drop("Class", axis=1)
y = df["Class"]
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.20, random_state=123456)
# modelin tanımlanıp, eğitilmesi ve başarı skoru
model = LogisticRegression(random_state=123456)
model.fit(X_train, y_train)
y_pred = model.predict(X_test)
accuracy = accuracy_score(y_test, y_pred)
print("Accuracy: %.3f"%(accuracy))Accuracy: 0.999La exactitud (accuracy) es la proporción de predicciones correctas sobre el total. Nuestro modelo obtiene 0,999. Podríamos decir que funciona a la perfección, ¿no? Veamos también la matriz de confusión.
La matriz de confusión
La matriz de confusión es una tabla que resume cómo se comporta un modelo de clasificación con los datos de prueba. Contiene las cuatro combinaciones de valores predichos y reales. Aquí consideramos el fraude como clase positiva:
- Verdadero positivo (TP): la predicción es positiva y acierta.
- Verdadero negativo (TN): la predicción es negativa y acierta.
- Falso positivo (FP): la predicción es positiva, pero falla.
- Falso negativo (FN): la predicción es negativa, pero falla.
def plot_confusion_matrix(cm, classes,
                          title='Confusion matrix',
                          cmap=plt.cm.Blues):

    plt.rcParams.update({'font.size': 19})
    plt.imshow(cm, interpolation='nearest', cmap=cmap)
    plt.title(title,fontdict={'size':'16'})
    plt.colorbar()
    tick_marks = np.arange(len(classes))
    plt.xticks(tick_marks, classes, rotation=45,fontsize=12,color="blue")
    plt.yticks(tick_marks, classes,fontsize=12,color="blue")
    rc('font', weight='bold')
    fmt = '.1f'
    thresh = cm.max()
    for i, j in itertools.product(range(cm.shape[0]), range(cm.shape[1])):
        plt.text(j, i, format(cm[i, j], fmt),
                 horizontalalignment="center",
                 color="red")

    plt.ylabel('True label',fontdict={'size':'16'})
    plt.xlabel('Predicted label',fontdict={'size':'16'})
    plt.tight_layout()

plot_confusion_matrix(confusion_matrix(y_test, y_pred=y_pred), classes=['Non Fraud','Fraud'],
                      title='Confusion matrix')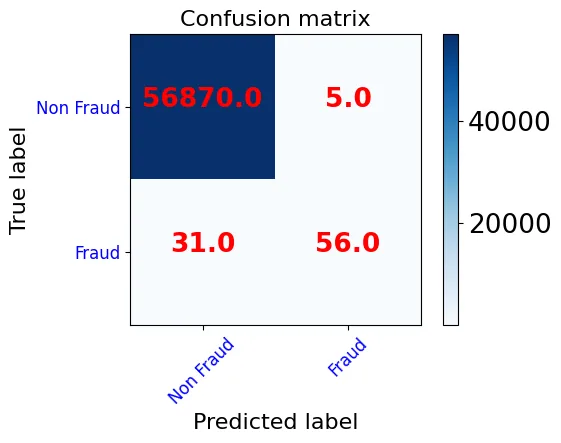
- De las 56 875 transacciones realmente normales, 56 870 se predicen correctamente y 5 se marcan por error como fraude (FP).
- De los 87 fraudes reales, 56 se detectan (TP) y 31 se escapan (FN).
El modelo afirma tener una exactitud de 0,999, pero la matriz de confusión muestra una alta tasa de error en la clase de fraude. El modelo predice bien la clase mayoritaria y mal la minoritaria. Como hay muchas más transacciones normales que fraudulentas, el modelo parece acertado solo por predecir la clase normal.
La lección: la exactitud no es una buena medida del rendimiento de los modelos de clasificación, sobre todo con datos tan desequilibrados como los nuestros. Veamos cómo abordar el desequilibrio, qué métodos aplicar y con qué métricas medir el rendimiento.
Elegir las métricas adecuadas
Hemos visto que la exactitud no basta; necesitamos otras métricas para medir el rendimiento.
Precisión (precision): la proporción de predicciones positivas que son realmente positivas. Una precisión baja significa muchos falsos positivos. Precisión = TP / (TP + FP).
Exhaustividad (recall): la proporción de positivos reales que hemos predicho como positivos. Una exhaustividad baja significa muchos falsos negativos; debe ser lo más alta posible. Exhaustividad = TP / (TP + FN).
Puntuación F1: es difícil comparar un modelo de precisión baja y exhaustividad alta con otro que presente lo contrario. La puntuación F1 mide ambas a la vez como media armónica de precisión y exhaustividad. F1 = 2 × (Precisión × Exhaustividad) / (Precisión + Exhaustividad).
Veamos estas métricas para nuestro modelo. El informe de clasificación muestra las métricas principales por clase.
#sınıflandırma raporu
print(classification_report(y_test, y_pred))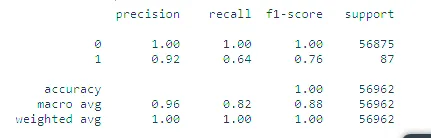
Precisión por clase:
- Clase 0 (normal): 56 870 + 31 = 56 901 transacciones predichas como normales, 56 870 de ellas correctamente. Precisión ≈ 1,00 (56 870 / 56 901).
- Clase 1 (fraude): 5 + 56 = 61 transacciones predichas como fraude, 56 de ellas correctamente. Precisión ≈ 0,92 (56 / 61).
Exhaustividad por clase:
- Clase 0 (normal): de 56 870 + 5 = 56 875 transacciones normales, 56 870 se predicen correctamente. Exhaustividad ≈ 1,00.
- Clase 1 (fraude): de 31 + 56 = 87 transacciones fraudulentas, 56 se predicen correctamente. Exhaustividad = 56 / 87 ≈ 0,64.
Los valores de exhaustividad muestran con claridad el fallo en la clase 1. La puntuación F1 es la media armónica de exhaustividad y precisión. El soporte (support) es el número real de ejemplos de cada clase; la diferencia entre clases revela una debilidad estructural de las mediciones, porque el propio desequilibrio las afecta.
La curva ROC
La curva ROC es un gráfico del rendimiento de un modelo de clasificación en todos los umbrales de decisión. Representa dos valores:
- Tasa de verdaderos positivos (TPR), es decir, la exhaustividad: TPR = TP / (TP + FN)
- Tasa de falsos positivos (FPR), es decir, la tasa de falsas alarmas en las transacciones normales: FPR = FP / (FP + TN)
La curva representa la TPR frente a la FPR en distintos umbrales; empieza en (0,0) y termina en (1,1). Un buen modelo produce una curva que sube rápidamente de 0 a 1.
AUC (área bajo la curva ROC)
El AUC resume la curva ROC en un solo número: mide toda el área bajo la curva de (0,0) a (1,1). El mejor valor es 1; adivinar al azar da 0,5.
# Auc Roc Curve
def generate_auc_roc_curve(clf, X_test):
    y_pred_proba = clf.predict_proba(X_test)[:, 1]
    fpr, tpr, thresholds = roc_curve(y_test,  y_pred_proba)
    auc = roc_auc_score(y_test, y_pred_proba)
    plt.plot(fpr,tpr)
    plt.show()
    pass

generate_auc_roc_curve(model, X_test)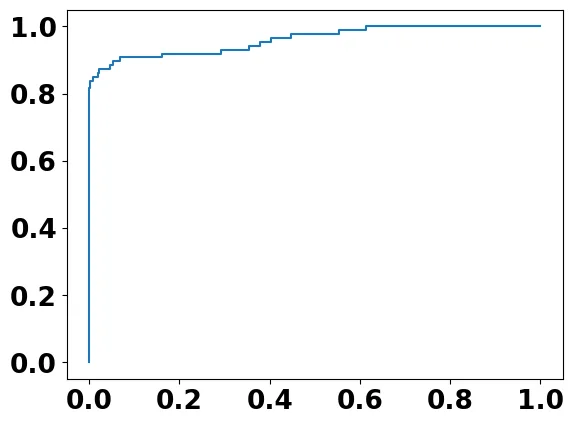
y_pred_proba = model.predict_proba(X_test)[:, 1]
auc = roc_auc_score(y_test, y_pred_proba)
print("AUC ROC Curve with Area Under the curve = %.3f"%auc)
AUC ROC Curve with Area Under the curve = 0.961Nota: el AUC evalúa el rendimiento global de clasificación. Como no da más peso a una clase que a otra, no refleja bien el rendimiento en la clase minoritaria.
Apliquemos ahora varios métodos al conjunto de datos para eliminar el desequilibrio.
Importante: estos métodos deben aplicarse solo al conjunto de entrenamiento. Si se aplican al conjunto de prueba, impiden una evaluación correcta.
Remuestreo
El remuestreo (resampling) hace que un conjunto de datos esté más equilibrado añadiendo ejemplos nuevos a la clase minoritaria o quitándolos de la mayoritaria. El submuestreo quita ejemplos de la mayoría; el sobremuestreo multiplica los de la minoría.
Sobremuestreo
El sobremuestreo (oversampling) equilibra los datos duplicando los ejemplos de la clase minoritaria.
Sobremuestreo aleatorio:
- Se añaden ejemplos de la minoría elegidos al azar para equilibrar el conjunto.
- Puede usarse cuando el conjunto es pequeño.
- Puede provocar sobreajuste (overfitting).
RandomOverSampler recibe el argumento sampling_strategy. Con sampling_strategy='minority' la clase minoritaria se multiplica hasta igualar a la mayoritaria. El argumento también admite un decimal: si la clase mayoritaria tiene 1000 ejemplos y la minoritaria 100, sampling_strategy=0.5 eleva la clase minoritaria a 500.
# random oversampling önce eğitim setindeki sınıf sayısı
y_train.value_counts()
0 227440
1 405
Name: Class, dtype: int64# RandomOver Sampling uygulanması (Eğitim setine uygulanıyor)
from imblearn.over_sampling import RandomOverSampler
oversample = RandomOverSampler(sampling_strategy='minority')
X_randomover, y_randomover = oversample.fit_resample(X_train, y_train)# random oversampling den sonra eğitim setinin sınıf sayısı
y_randomover.value_counts()1 227440
0 227440
Name: Class, dtype: int64# modelin eğitilmesi ve başarı oranı
model.fit(X_randomover, y_randomover)
y_pred = model.predict(X_test)
accuracy = accuracy_score(y_test, y_pred)
print("Accuracy: %.3f%%" % (accuracy))Accuracy: 0.977plot_confusion_matrix(confusion_matrix(y_test, y_pred=y_pred), classes=['Non Fraud','Fraud'],
title='Confusion matrix')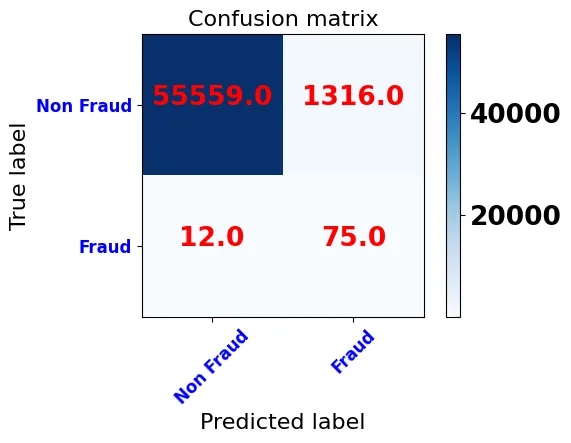
#sınıflandırma raporu
print(classification_report(y_test, y_pred)) precision recall f1-score support
0 1.00 0.98 0.99 56875
1 0.05 0.86 0.10 87
accuracy 0.98 56962
macro avg 0.53 0.92 0.55 56962
weighted avg 1.00 0.98 0.99 56962Tras el sobremuestreo aleatorio, la exactitud del modelo baja a 0,977. La matriz de confusión y el informe de clasificación muestran que la mayoría de las transacciones marcadas como fraude son falsas alarmas, lo que reduce la precisión de la clase 1 a 0,05. A cambio, la exhaustividad de la clase 1 sube a 0,86: se detectan 75 de los 87 fraudes. Las transacciones normales se predicen algo peor que con el primer modelo, pero este salto en la detección del fraude es una buena razón para preferir el modelo entrenado tras el sobremuestreo aleatorio.
Sobremuestreo SMOTE:
Para evitar el sobreajuste, se generan ejemplos sintéticos de la minoría en lugar de copias:
- Se elige al azar un ejemplo de la clase minoritaria.
- Se buscan sus k vecinos más cercanos.
- Se elige un vecino al azar; en el espacio de características se traza un segmento entre el ejemplo y ese vecino, y el ejemplo sintético se crea sobre ese segmento.
# smote dan önce eğitim setindeki sınıf sayısı
y_train.value_counts()0 227440
1 405
Name: Class, dtype: int64# Smote uygulanması (Eğitim setine uygulanıyor)
from imblearn.over_sampling import SMOTE
oversample = SMOTE()
X_smote, y_smote = oversample.fit_resample(X_train, y_train)# smote dan sonra eğitim setinin sınıf sayısı
y_smote.value_counts()1 227440
0 227440
Name: Class, dtype: int64# modelin eğitilmesi ve başarı oranı
model.fit(X_smote, y_smote)
y_pred = model.predict(X_test)
accuracy = accuracy_score(y_test, y_pred)
print("Accuracy: %.3f%%" % (accuracy))Accuracy: 0.975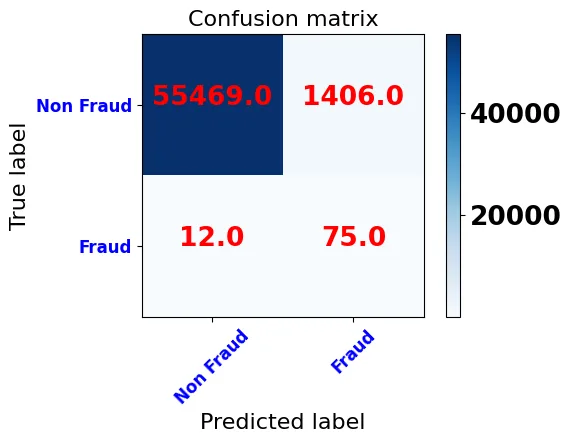
plot_confusion_matrix(confusion_matrix(y_test, y_pred=y_pred), classes=['Non Fraud','Fraud'],
                      title='Confusion matrix')
#sınıflandırma raporu
print(classification_report(y_test, y_pred)) precision recall f1-score support
0 1.00 0.98 0.99 56875
1 0.05 0.86 0.10 87
accuracy 0.98 56962
macro avg 0.53 0.92 0.54 56962
weighted avg 1.00 0.98 0.99 56962Los resultados tras SMOTE se parecen a los del sobremuestreo aleatorio: de nuevo se detectan 75 de los 87 fraudes, mientras que las falsas alarmas suben a 1406.
Submuestreo
El submuestreo (undersampling) equilibra los datos quitando ejemplos de la clase mayoritaria y es adecuado para conjuntos grandes. El nuestro no es lo bastante grande para que dé buenos resultados, pero explicamos los métodos y mostramos cómo se aplican algunos.
Submuestreo aleatorio:
- Los ejemplos que se quitan se eligen al azar.
- Puede usarse si tiene un conjunto de datos grande.
- La elección aleatoria puede provocar pérdida de información.
# random undersampling den önce eğitim setindeki sınıf sayısı
y_train.value_counts()
0 227440
1 405
Name: Class, dtype: int64from imblearn.under_sampling import RandomUnderSampler
# transform the dataset
ranUnSample = RandomUnderSampler()
X_ranUnSample, y_ranUnSample = ranUnSample.fit_resample(X_train, y_train)# Random undersampling sonra
y_ranUnSample.value_counts()1 405
0 405
Name: Class, dtype: int64Submuestreo NearMiss:
- Reduce la pérdida de información.
- Se basa en el algoritmo KNN.
- Calcula la distancia de los ejemplos de la mayoría a los de la minoría.
- Conserva los ejemplos de la mayoría más cercanos a la minoría, según un k dado.
Enlaces de Tomek: en cada par de ejemplos más cercanos de clases distintas se elimina el de la mayoría, lo que agranda la separación entre clases.
Centroides de clústeres: los ejemplos poco importantes se quitan del conjunto; la importancia de un ejemplo se decide mediante clustering.
El submuestreo y el sobremuestreo pueden combinarse para lograr conjuntos más equilibrados.
Otros métodos
- Recoger más datos
- Usar el parámetro
class_weightpara que el modelo aprenda por igual de la minoría y de la mayoría - Mirar el rendimiento de otros modelos, no solo de uno
- Cambiar de enfoque, por ejemplo con detección de anomalías o de cambios
Qué método funciona mejor depende del conjunto de datos de que se trate. Probar los métodos y elegir el que mejor se adapte a sus datos da el mejor resultado.
Referencias
- Kaggle: sobre conjuntos de datos desequilibrados (Yasin Tanış, en turco)
- Miuul: qué es un conjunto de datos desequilibrado (en turco)
- Machine Learning Mastery: Random oversampling and undersampling
- Machine Learning Mastery: SMOTE oversampling
- Towards Data Science: Understanding the confusion matrix
- Towards Data Science: Understanding the AUC-ROC curve
- Machine Learning Mastery: Tactics to combat imbalanced classes