

Τι είναι ένα μη ισορροπημένο σύνολο δεδομένων και πώς το αντιμετωπίζουμε;
Γράφει Yasin TANIŞ
Τι είναι ένα μη ισορροπημένο σύνολο δεδομένων
Φτιάχνετε ένα μοντέλο ταξινόμησης για μια επιχείρηση και πετυχαίνει ακρίβεια 95 %. Όλα φαίνονται εντάξει. Το μοντέλο μπαίνει σε χρήση, και σύντομα κάποιος προσέχει ότι προβλέπει πάντα την ίδια κλάση. Ξανακοιτάζοντας τα δεδομένα, διαπιστώνετε ότι η κλάση που δεν εντοπίζει ποτέ αποτελεί μόλις το 5 % των δεδομένων. Η αποτυχία του μοντέλου οφείλεται σε ένα μη ισορροπημένο σύνολο δεδομένων.
Τα μη ισορροπημένα σύνολα δεδομένων εμφανίζονται σε προβλήματα ταξινόμησης, όταν η κατανομή των κλάσεων απέχει πολύ από το να είναι ομοιόμορφη. Το πρόβλημα είναι ότι η πλειοψηφούσα κλάση καταπνίγει τη μειοψηφούσα: το μοντέλο γέρνει προς την πλειοψηφία και ταξινομεί λανθασμένα τη μειοψηφία.
Όταν έχουμε μη ισορροπημένα δεδομένα, μπορούμε να χρησιμοποιήσουμε τις εξής μεθόδους για να παρατηρήσουμε σωστά και να αποκαταστήσουμε την ισορροπία:
- Επιλογή των σωστών μετρικών: precision, recall, σκορ F1, καμπύλη ROC και AUC
- Επαναδειγματοληψία: oversampling (τυχαίο και SMOTE) και undersampling (τυχαίο, NearMiss, δεσμοί Tomek, κέντρα συστάδων)
- Συλλογή περισσότερων δεδομένων
- Χρήση της παραμέτρου
class_weightτων μοντέλων ταξινόμησης, ώστε το μοντέλο να μαθαίνει εξίσου από τη μειοψηφούσα και την πλειοψηφούσα κλάση - Εξέταση της απόδοσης και άλλων μοντέλων αντί να βασιζόμαστε σε ένα μόνο
- Υιοθέτηση διαφορετικής προσέγγισης, όπως η ανίχνευση ανωμαλιών ή αλλαγών
Πρώτα εξετάζουμε το σύνολο δεδομένων Credit Card Fraud Detection, το οποίο είναι μη ισορροπημένο, και μετά εφαρμόζουμε διάφορες μεθόδους για να αντιμετωπίσουμε την ανισορροπία.
Εξέταση του συνόλου δεδομένων
Ο εντοπισμός της απάτης είναι σημαντικός για τις εταιρείες πιστωτικών καρτών: δεν θέλουν να χρεώνονται οι πελάτες τους για αγορές που δεν έκαναν.
Σύνολο δεδομένων: creditcard.csv (Kaggle)
Με αυτό το σύνολο δεδομένων θέλουμε να φτιάξουμε ένα μοντέλο που εντοπίζει δόλιες συναλλαγές. Τα δεδομένα προέρχονται από συναλλαγές με κάρτες που έγιναν στην Ευρώπη τον Σεπτέμβριο του 2013· κάθε συναλλαγή φέρει την ετικέτα 1 αν είναι απάτη και 0 αν δεν είναι. Για λόγους προστασίας της ιδιωτικότητας, οι πληροφορίες για το υπόβαθρο των δεδομένων είναι λιγοστές, και όλες οι μεταβλητές εκτός από τις Time και Amount έχουν μετασχηματιστεί με PCA (ανάλυση κύριων συνιστωσών).
Time: τα δευτερόλεπτα που μεσολάβησαν από την πρώτη συναλλαγή έως την κάθε συναλλαγήAmount: το ποσό της συναλλαγής
Πρώτα διαβάζουμε τα δεδομένα, ελέγχουμε αν υπάρχουν ελλείπουσες τιμές και εξετάζουμε την κατανομή της μεταβλητής Class. Έπειτα τυποποιούμε τα Amount και Time, χωρίζουμε τα δεδομένα με τη μέθοδο hold-out και φτιάχνουμε ένα μοντέλο ταξινόμησης με λογιστική παλινδρόμηση. Θα δουλέψουμε με ένα μόνο μοντέλο.
# Gerekli kütüphaneler
import pandas as pd
import numpy as np
from sklearn.preprocessing import RobustScaler
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score
from sklearn.metrics import confusion_matrix, classification_report,f1_score,recall_score,roc_auc_score, roc_curve
import matplotlib.pyplot as plt
import seaborn as sns
from matplotlib import rc,rcParams
import itertools

import warnings
warnings.filterwarnings("ignore", category=DeprecationWarning)
warnings.filterwarnings("ignore", category=FutureWarning)
warnings.filterwarnings("ignore", category=UserWarning)
# Veri setinin okutulması
df = pd.read_csv("creditcard.csv")
df.head()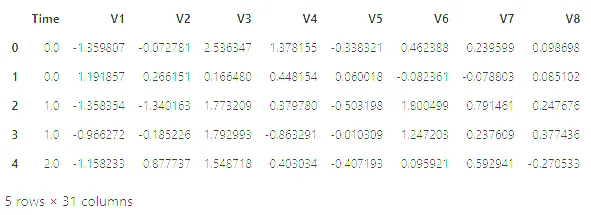
# Veri setindeki değişken ve gözlem sayısı
print("Gözlem sayısı : " ,len(df))
print("Değişken sayısı : ", len(df.columns))
Gözlem sayısı : 284807
Değişken sayısı : 31(Ο κώδικας τυπώνει τις ετικέτες στα τουρκικά: πλήθος παρατηρήσεων και πλήθος μεταβλητών.)
# veri setindeki değişkenlerin tiplerini ve boş değer içerip içermediğini gözlemlemek istiyoruz
df.info()
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 284807 entries, 0 to 284806
Data columns (total 31 columns):
# Column Non-Null Count Dtype
--- ------ -------------- -----
0 Time 284807 non-null float64
1 V1 284807 non-null float64
2 V2 284807 non-null float64
3 V3 284807 non-null float64
4 V4 284807 non-null float64
5 V5 284807 non-null float64
6 V6 284807 non-null float64
7 V7 284807 non-null float64
8 V8 284807 non-null float64
9 V9 284807 non-null float64
10 V10 284807 non-null float64
11 V11 284807 non-null float64
12 V12 284807 non-null float64
13 V13 284807 non-null float64
14 V14 284807 non-null float64
15 V15 284807 non-null float64
16 V16 284807 non-null float64
17 V17 284807 non-null float64
18 V18 284807 non-null float64
19 V19 284807 non-null float64
20 V20 284807 non-null float64
21 V21 284807 non-null float64
22 V22 284807 non-null float64
23 V23 284807 non-null float64
24 V24 284807 non-null float64
25 V25 284807 non-null float64
26 V26 284807 non-null float64
27 V27 284807 non-null float64
28 V28 284807 non-null float64
29 Amount 284807 non-null float64
30 Class 284807 non-null int64
dtypes: float64(30), int64(1)
memory usage: 67.4 MB# 1 sınıfının veri setinde bulunma oranı %0.2, 0 sınıfının ise %99.8
f, ax = plt.subplots(1, 2, figsize=(18, 8))
# Sınıf dağılımı
class_counts = df['Class'].value_counts().sort_values(ascending=False)
# Sınıf sayısına göre patlamayı belirleyin
explode = [0.1] * len(class_counts)
# Sınıf dağılımı için pasta grafik
ax[0].pie(class_counts, labels=class_counts.index, autopct='%1.1f%%', explode=explode, shadow=True)
ax[0].set_title('Dağılım')
ax[0].set_ylabel('')
# Sınıf dağılımı için sayım grafiği (seaborn kullanarak)
sns.countplot(x='Class', data=df, ax=ax[1])
ax[1].set_title('Sınıf Sayısı')
plt.show()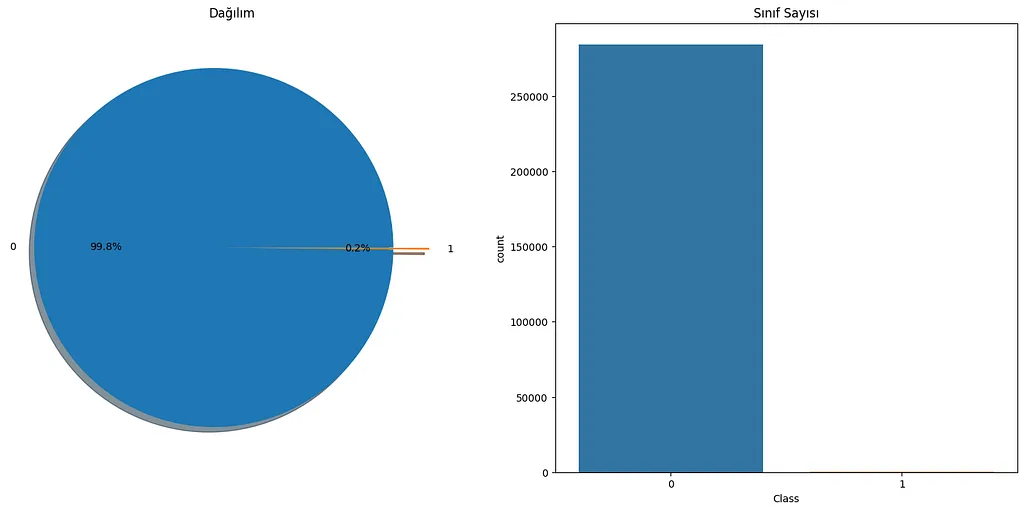
# Time ve Amount değişkenlerini standartlaştırma
rob_scaler = RobustScaler()
df['Amount'] = rob_scaler.fit_transform(df['Amount'].values.reshape(-1,1))
df['Time'] = rob_scaler.fit_transform(df['Time'].values.reshape(-1,1))
df.head()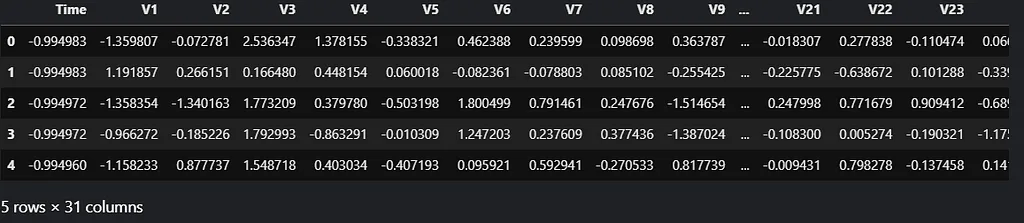
# Hold out yöntemi uygulayıp veri setini eğitim ve test olarak ikiye ayırıyoruz.(%80,%20)
X = df.drop("Class", axis=1)
y = df["Class"]
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.20, random_state=123456)
# modelin tanımlanıp, eğitilmesi ve başarı skoru
model = LogisticRegression(random_state=123456)
model.fit(X_train, y_train)
y_pred = model.predict(X_test)
accuracy = accuracy_score(y_test, y_pred)
print("Accuracy: %.3f"%(accuracy))Accuracy: 0.999Η ακρίβεια (accuracy) είναι το ποσοστό των σωστών προβλέψεων επί του συνόλου των προβλέψεων. Το μοντέλο μας πετυχαίνει 0,999. Θα μπορούσαμε να πούμε ότι λειτουργεί τέλεια, έτσι δεν είναι; Ας δούμε και τον πίνακα σύγχυσης.
Ο πίνακας σύγχυσης
Ο πίνακας σύγχυσης (confusion matrix) είναι ένας πίνακας που συνοψίζει πώς αποδίδει ένα μοντέλο ταξινόμησης στα δεδομένα ελέγχου. Περιέχει τους τέσσερις συνδυασμούς προβλεπόμενων και πραγματικών τιμών. Εδώ θεωρούμε την απάτη ως θετική κλάση:
- Αληθώς θετικό (TP): προβλέφθηκε θετικό, και σωστά.
- Αληθώς αρνητικό (TN): προβλέφθηκε αρνητικό, και σωστά.
- Ψευδώς θετικό (FP): προβλέφθηκε θετικό, αλλά λανθασμένα.
- Ψευδώς αρνητικό (FN): προβλέφθηκε αρνητικό, αλλά λανθασμένα.
def plot_confusion_matrix(cm, classes,
                          title='Confusion matrix',
                          cmap=plt.cm.Blues):

    plt.rcParams.update({'font.size': 19})
    plt.imshow(cm, interpolation='nearest', cmap=cmap)
    plt.title(title,fontdict={'size':'16'})
    plt.colorbar()
    tick_marks = np.arange(len(classes))
    plt.xticks(tick_marks, classes, rotation=45,fontsize=12,color="blue")
    plt.yticks(tick_marks, classes,fontsize=12,color="blue")
    rc('font', weight='bold')
    fmt = '.1f'
    thresh = cm.max()
    for i, j in itertools.product(range(cm.shape[0]), range(cm.shape[1])):
        plt.text(j, i, format(cm[i, j], fmt),
                 horizontalalignment="center",
                 color="red")

    plt.ylabel('True label',fontdict={'size':'16'})
    plt.xlabel('Predicted label',fontdict={'size':'16'})
    plt.tight_layout()

plot_confusion_matrix(confusion_matrix(y_test, y_pred=y_pred), classes=['Non Fraud','Fraud'],
                      title='Confusion matrix')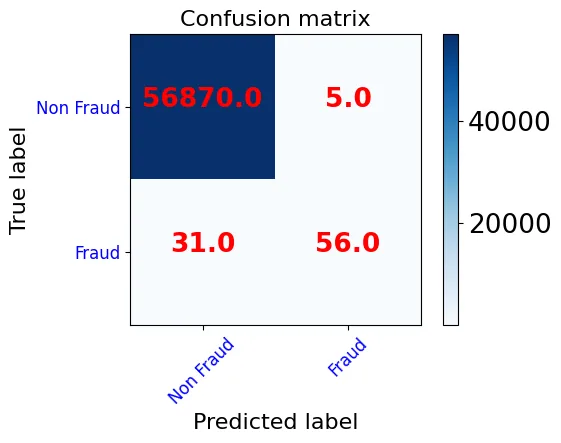
- Από τις 56875 πραγματικά κανονικές συναλλαγές, οι 56870 προβλέπονται σωστά και οι 5 επισημαίνονται εσφαλμένα ως απάτη (FP).
- Από τις 87 πραγματικές απάτες, οι 56 εντοπίζονται (TP) και οι 31 διαφεύγουν (FN).
Το μοντέλο εμφανίζει ακρίβεια 0,999, αλλά ο πίνακας σύγχυσης δείχνει υψηλό ποσοστό σφαλμάτων στην κλάση της απάτης. Το μοντέλο προβλέπει καλά την πλειοψηφούσα κλάση και άσχημα τη μειοψηφούσα. Επειδή οι κανονικές συναλλαγές είναι πολύ περισσότερες από τις δόλιες, το μοντέλο φαίνεται επιτυχημένο προβλέποντας την κανονική κλάση.
Το δίδαγμα: η ακρίβεια δεν είναι καλό μέτρο απόδοσης για μοντέλα ταξινόμησης, ιδίως όταν τα δεδομένα είναι τόσο μη ισορροπημένα όσο τα δικά μας. Ας δούμε πώς αντιμετωπίζουμε την ανισορροπία, ποιες μεθόδους εφαρμόζουμε και με ποιες μετρικές μετράμε την απόδοση.
Επιλογή των σωστών μετρικών
Είδαμε ότι η ακρίβεια δεν αρκεί· χρειαζόμαστε άλλες μετρικές για να αξιολογήσουμε την απόδοση.
Precision: το ποσοστό των προβλεπόμενων θετικών που είναι πράγματι θετικά. Χαμηλή precision σημαίνει πολλά ψευδώς θετικά. Precision = TP / (TP + FP).
Recall (ανάκληση): το ποσοστό των πραγματικά θετικών που προβλέψαμε ως θετικά. Χαμηλή ανάκληση σημαίνει πολλά ψευδώς αρνητικά· πρέπει να είναι όσο το δυνατόν υψηλότερη. Recall = TP / (TP + FN).
Σκορ F1: είναι δύσκολο να συγκρίνει κανείς ένα μοντέλο με χαμηλή precision και υψηλή ανάκληση με ένα μοντέλο που έχει το αντίστροφο. Το σκορ F1 μετρά και τα δύο μαζί, ως αρμονικός μέσος της precision και της ανάκλησης. F1 = 2 × (Precision × Recall) / (Precision + Recall).
Ας δούμε αυτές τις μετρικές για το μοντέλο μας. Η αναφορά ταξινόμησης (classification report) δείχνει τις κύριες μετρικές ανά κλάση.
#sınıflandırma raporu
print(classification_report(y_test, y_pred))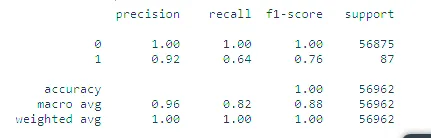
Precision ανά κλάση:
- Κλάση 0 (κανονικές): 56870 + 31 = 56901 συναλλαγές προβλέφθηκαν ως κανονικές, από τις οποίες οι 56870 σωστά. Precision ≈ 1,00 (56870 / 56901).
- Κλάση 1 (απάτη): 5 + 56 = 61 συναλλαγές προβλέφθηκαν ως απάτη, από τις οποίες οι 56 σωστά. Precision ≈ 0,92 (56 / 61).
Ανάκληση ανά κλάση:
- Κλάση 0 (κανονικές): από τις 56870 + 5 = 56875 κανονικές συναλλαγές, οι 56870 προβλέπονται σωστά. Recall ≈ 1,00.
- Κλάση 1 (απάτη): από τις 31 + 56 = 87 δόλιες συναλλαγές, οι 56 προβλέπονται σωστά. Recall = 56 / 87 ≈ 0,64.
Οι τιμές της ανάκλησης δείχνουν καθαρά την αποτυχία στην κλάση 1. Το σκορ F1 είναι ο αρμονικός μέσος της ανάκλησης και της precision. Το support είναι το πραγματικό πλήθος παραδειγμάτων κάθε κλάσης· η διαφορά μεταξύ των κλάσεων δείχνει μια δομική αδυναμία των μετρήσεων, αφού η ίδια η ανισορροπία τις επηρεάζει.
Η καμπύλη ROC
Η καμπύλη ROC είναι ένα γράφημα της απόδοσης ενός μοντέλου ταξινόμησης σε όλα τα κατώφλια απόφασης. Απεικονίζει δύο μεγέθη:
- Ποσοστό αληθώς θετικών (TPR), δηλαδή η ανάκληση: TPR = TP / (TP + FN)
- Ποσοστό ψευδώς θετικών (FPR), δηλαδή το ποσοστό ψευδών συναγερμών στις κανονικές συναλλαγές: FPR = FP / (FP + TN)
Η καμπύλη απεικονίζει το TPR έναντι του FPR για διαφορετικά κατώφλια· ξεκινά στο (0,0) και τελειώνει στο (1,1). Ένα καλό μοντέλο δίνει καμπύλη που ανεβαίνει γρήγορα από το 0 στο 1.
AUC (εμβαδόν κάτω από την καμπύλη ROC)
Το AUC συνοψίζει την καμπύλη ROC σε έναν αριθμό: μετρά όλο το εμβαδόν κάτω από την καμπύλη από το (0,0) έως το (1,1). Η καλύτερη τιμή είναι 1· η τυχαία πρόβλεψη δίνει 0,5.
# Auc Roc Curve
def generate_auc_roc_curve(clf, X_test):
    y_pred_proba = clf.predict_proba(X_test)[:, 1]
    fpr, tpr, thresholds = roc_curve(y_test,  y_pred_proba)
    auc = roc_auc_score(y_test, y_pred_proba)
    plt.plot(fpr,tpr)
    plt.show()
    pass

generate_auc_roc_curve(model, X_test)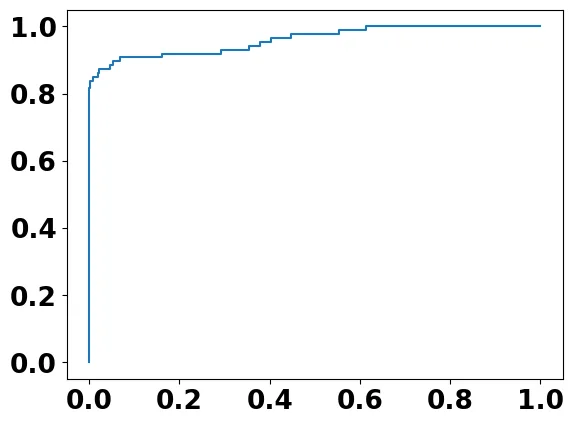
y_pred_proba = model.predict_proba(X_test)[:, 1]
auc = roc_auc_score(y_test, y_pred_proba)
print("AUC ROC Curve with Area Under the curve = %.3f"%auc)
AUC ROC Curve with Area Under the curve = 0.961Σημείωση: το AUC αξιολογεί τη συνολική απόδοση ταξινόμησης. Επειδή δεν δίνει μεγαλύτερο βάρος στη μία κλάση έναντι της άλλης, δεν αποτυπώνει καλά την απόδοση στη μειοψηφούσα κλάση.
Ας εφαρμόσουμε τώρα στο σύνολο δεδομένων μερικές μεθόδους για να άρουμε την ανισορροπία.
Σημαντικό: οι μέθοδοι αυτές εφαρμόζονται μόνο στο σύνολο εκπαίδευσης. Αν εφαρμοστούν στο σύνολο ελέγχου, η σωστή αξιολόγηση καθίσταται αδύνατη.
Επαναδειγματοληψία
Η επαναδειγματοληψία (resampling) κάνει ένα σύνολο δεδομένων πιο ισορροπημένο, προσθέτοντας νέα παραδείγματα στη μειοψηφούσα κλάση ή αφαιρώντας παραδείγματα από την πλειοψηφούσα. Το undersampling αφαιρεί παραδείγματα της πλειοψηφίας· το oversampling πολλαπλασιάζει τα παραδείγματα της μειοψηφίας.
Oversampling
Το oversampling εξισορροπεί τα δεδομένα δημιουργώντας αντίγραφα παραδειγμάτων της μειοψηφούσας κλάσης.
Τυχαίο oversampling:
- Προστίθενται τυχαία επιλεγμένα παραδείγματα της μειοψηφίας, ώστε να εξισορροπηθεί το σύνολο δεδομένων.
- Μπορεί να χρησιμοποιηθεί όταν το σύνολο δεδομένων είναι μικρό.
- Μπορεί να οδηγήσει σε υπερπροσαρμογή (overfitting).
Ο RandomOverSampler δέχεται το όρισμα sampling_strategy. Με sampling_strategy='minority' η μειοψηφούσα κλάση πολλαπλασιάζεται μέχρι να εξισωθεί με την πλειοψηφούσα. Το όρισμα δέχεται και δεκαδικό αριθμό: αν η πλειοψηφία έχει 1000 παραδείγματα και η μειοψηφία 100, το sampling_strategy=0.5 ανεβάζει τη μειοψηφία στα 500.
# random oversampling önce eğitim setindeki sınıf sayısı
y_train.value_counts()
0 227440
1 405
Name: Class, dtype: int64# RandomOver Sampling uygulanması (Eğitim setine uygulanıyor)
from imblearn.over_sampling import RandomOverSampler
oversample = RandomOverSampler(sampling_strategy='minority')
X_randomover, y_randomover = oversample.fit_resample(X_train, y_train)# random oversampling den sonra eğitim setinin sınıf sayısı
y_randomover.value_counts()1 227440
0 227440
Name: Class, dtype: int64# modelin eğitilmesi ve başarı oranı
model.fit(X_randomover, y_randomover)
y_pred = model.predict(X_test)
accuracy = accuracy_score(y_test, y_pred)
print("Accuracy: %.3f%%" % (accuracy))Accuracy: 0.977plot_confusion_matrix(confusion_matrix(y_test, y_pred=y_pred), classes=['Non Fraud','Fraud'],
title='Confusion matrix')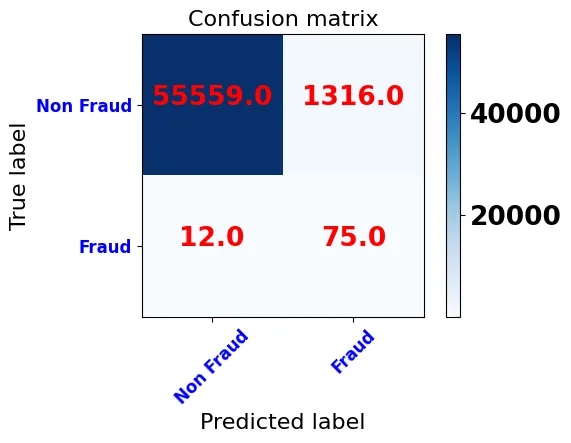
#sınıflandırma raporu
print(classification_report(y_test, y_pred)) precision recall f1-score support
0 1.00 0.98 0.99 56875
1 0.05 0.86 0.10 87
accuracy 0.98 56962
macro avg 0.53 0.92 0.55 56962
weighted avg 1.00 0.98 0.99 56962Μετά το τυχαίο oversampling η ακρίβεια του μοντέλου πέφτει στο 0,977. Ο πίνακας σύγχυσης και η αναφορά ταξινόμησης δείχνουν ότι οι περισσότερες συναλλαγές που σημειώνονται ως απάτη είναι ψευδείς συναγερμοί, κάτι που ρίχνει την precision της κλάσης 1 στο 0,05. Από την άλλη, η ανάκληση της κλάσης 1 ανεβαίνει στο 0,86: εντοπίζονται 75 από τις 87 απάτες. Οι κανονικές συναλλαγές προβλέπονται λίγο χειρότερα απ’ ό,τι με το πρώτο μοντέλο, αλλά αυτό το άλμα στον εντοπισμό απάτης είναι ισχυρός λόγος να προτιμήσουμε το μοντέλο που εκπαιδεύτηκε μετά το τυχαίο oversampling.
SMOTE oversampling:
Για να αποφευχθεί η υπερπροσαρμογή, αντί για αντίγραφα δημιουργούνται συνθετικά παραδείγματα της μειοψηφίας:
- Επιλέγεται τυχαία ένα παράδειγμα της μειοψηφούσας κλάσης.
- Βρίσκονται οι k πλησιέστεροι γείτονές του.
- Επιλέγεται τυχαία ένας γείτονας· στον χώρο των χαρακτηριστικών χαράσσεται ευθύγραμμο τμήμα ανάμεσα στο παράδειγμα και τον γείτονα, και το συνθετικό παράδειγμα δημιουργείται πάνω του.
# smote dan önce eğitim setindeki sınıf sayısı
y_train.value_counts()0 227440
1 405
Name: Class, dtype: int64# Smote uygulanması (Eğitim setine uygulanıyor)
from imblearn.over_sampling import SMOTE
oversample = SMOTE()
X_smote, y_smote = oversample.fit_resample(X_train, y_train)# smote dan sonra eğitim setinin sınıf sayısı
y_smote.value_counts()1 227440
0 227440
Name: Class, dtype: int64# modelin eğitilmesi ve başarı oranı
model.fit(X_smote, y_smote)
y_pred = model.predict(X_test)
accuracy = accuracy_score(y_test, y_pred)
print("Accuracy: %.3f%%" % (accuracy))Accuracy: 0.975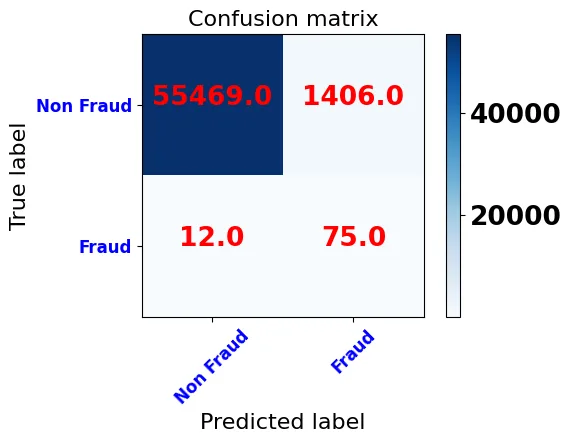
plot_confusion_matrix(confusion_matrix(y_test, y_pred=y_pred), classes=['Non Fraud','Fraud'],
                      title='Confusion matrix')
#sınıflandırma raporu
print(classification_report(y_test, y_pred)) precision recall f1-score support
0 1.00 0.98 0.99 56875
1 0.05 0.86 0.10 87
accuracy 0.98 56962
macro avg 0.53 0.92 0.54 56962
weighted avg 1.00 0.98 0.99 56962Τα αποτελέσματα μετά το SMOTE μοιάζουν με το τυχαίο oversampling: πάλι εντοπίζονται 75 από τις 87 απάτες, ενώ οι ψευδείς συναγερμοί ανεβαίνουν στους 1406.
Undersampling
Το undersampling εξισορροπεί τα δεδομένα αφαιρώντας παραδείγματα της πλειοψηφούσας κλάσης και ταιριάζει σε μεγάλα σύνολα. Το δικό μας σύνολο δεν είναι αρκετά μεγάλο για να αποδώσει καλά η μέθοδος, αλλά εξηγούμε τις μεθόδους και δείχνουμε πώς εφαρμόζονται ορισμένες από αυτές.
Τυχαίο undersampling:
- Τα παραδείγματα που αφαιρούνται επιλέγονται τυχαία.
- Μπορεί να χρησιμοποιηθεί αν έχετε μεγάλο σύνολο δεδομένων.
- Η τυχαία επιλογή μπορεί να προκαλέσει απώλεια πληροφορίας.
# random undersampling den önce eğitim setindeki sınıf sayısı
y_train.value_counts()
0 227440
1 405
Name: Class, dtype: int64from imblearn.under_sampling import RandomUnderSampler
# transform the dataset
ranUnSample = RandomUnderSampler()
X_ranUnSample, y_ranUnSample = ranUnSample.fit_resample(X_train, y_train)# Random undersampling sonra
y_ranUnSample.value_counts()1 405
0 405
Name: Class, dtype: int64NearMiss undersampling:
- Περιορίζει την απώλεια πληροφορίας.
- Βασίζεται στον αλγόριθμο KNN.
- Υπολογίζει την απόσταση των παραδειγμάτων της πλειοψηφίας από εκείνα της μειοψηφίας.
- Κρατά τα παραδείγματα της πλειοψηφίας που βρίσκονται πιο κοντά στη μειοψηφία, σύμφωνα με το δοσμένο k.
Δεσμοί Tomek: για κάθε ζεύγος πλησιέστερων παραδειγμάτων από διαφορετικές κλάσεις αφαιρείται το παράδειγμα της πλειοψηφίας, ώστε να μεγαλώσει η απόσταση ανάμεσα στις δύο κλάσεις.
Κέντρα συστάδων: τα μη σημαντικά παραδείγματα αφαιρούνται από το σύνολο δεδομένων· το αν ένα παράδειγμα είναι σημαντικό κρίνεται μέσω συσταδοποίησης.
Το undersampling και το oversampling μπορούν να συνδυαστούν για τη δημιουργία πιο ισορροπημένων συνόλων δεδομένων.
Άλλες μέθοδοι
- Συλλογή περισσότερων δεδομένων
- Χρήση της παραμέτρου
class_weight, ώστε το μοντέλο να μαθαίνει εξίσου από τη μειοψηφούσα και την πλειοψηφούσα κλάση - Εξέταση της απόδοσης και άλλων μοντέλων, όχι μόνο ενός
- Υιοθέτηση διαφορετικής προσέγγισης, όπως η ανίχνευση ανωμαλιών ή αλλαγών
Ποια μέθοδος δίνει το καλύτερο αποτέλεσμα εξαρτάται από το εκάστοτε σύνολο δεδομένων. Το καλύτερο αποτέλεσμα το πετυχαίνετε αν δοκιμάσετε τις μεθόδους και διαλέξετε αυτή που ταιριάζει στα δεδομένα σας.
Πηγές
- Kaggle: Σχετικά με τα μη ισορροπημένα σύνολα δεδομένων (Yasin Tanış, στα τουρκικά)
- Miuul: Τι είναι ένα μη ισορροπημένο σύνολο δεδομένων (στα τουρκικά)
- Machine Learning Mastery: Random oversampling and undersampling
- Machine Learning Mastery: SMOTE oversampling
- Towards Data Science: Understanding the confusion matrix
- Towards Data Science: Understanding the AUC-ROC curve
- Machine Learning Mastery: Tactics to combat imbalanced classes