

Какво е небалансиран набор от данни и как да се справим с него?
Автор Yasin TANIŞ
Какво е небалансиран набор от данни
Създавате класификационен модел за дадена компания и той постига точност 95 %. Всичко изглежда наред. Моделът влиза в употреба, но скоро някой забелязва, че той винаги предсказва един и същ клас. Като погледнете отново данните, виждате, че класът, който моделът никога не разпознава, е едва 5 % от данните. Причината за провала на модела е небалансираният набор от данни.
Небалансираните набори от данни се срещат в задачите за класификация, когато класовете далеч не са разпределени равномерно. Проблемът е, че мнозинственият клас заглушава малцинствения: моделът клони към мнозинствения клас и класифицира лошо малцинствения.
Когато се сблъскаме с небалансирани данни, можем да използваме следните методи, за да оценяваме правилно и да възстановим баланса:
- Избор на правилните метрики: precision, recall, F1 мярка, ROC кривата и AUC
- Повторна извадка (resampling): овърсемплинг (случаен и SMOTE) и ъндърсемплинг (случаен, NearMiss, връзки на Томек, центроиди на клъстери)
- Събиране на повече данни
- Използване на параметъра
class_weightна класификационните модели, за да се учи моделът еднакво от малцинствения и от мнозинствения клас - Сравняване с представянето на други модели, вместо да се разчита само на един
- Прилагане на различен подход, например откриване на аномалии или промени
Първо разглеждаме небалансирания набор от данни Credit Card Fraud Detection, а после прилагаме няколко метода, за да се справим с дисбаланса.
Разглеждане на набора от данни
Откриването на измами е важно за компаниите за кредитни карти: те не искат от клиентите да бъдат удържани суми за покупки, които не са направили.
Набор от данни: creditcard.csv (Kaggle)
С този набор искаме да изградим модел, който открива измамни транзакции. Данните са от транзакции с карти, извършени в Европа през септември 2013 г.; всяка транзакция е обозначена с 1, ако е измама, и с 0, ако не е. Поради съображения за поверителност допълнителната информация е оскъдна, а всички променливи освен Time и Amount са преобразувани с PCA (анализ на главните компоненти).
Time: секунди, изминали от първата транзакция до всяка следваща транзакцияAmount: сума на транзакцията
Първо зареждаме данните, проверяваме за липсващи стойности и разглеждаме разпределението на променливата Class. След това стандартизираме Amount и Time, разделяме данните по метода hold-out (с отделена тестова извадка) и изграждаме класификационен модел с логистична регресия. Ще работим само с един модел.
# Gerekli kütüphaneler
import pandas as pd
import numpy as np
from sklearn.preprocessing import RobustScaler
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score
from sklearn.metrics import confusion_matrix, classification_report,f1_score,recall_score,roc_auc_score, roc_curve
import matplotlib.pyplot as plt
import seaborn as sns
from matplotlib import rc,rcParams
import itertools

import warnings
warnings.filterwarnings("ignore", category=DeprecationWarning)
warnings.filterwarnings("ignore", category=FutureWarning)
warnings.filterwarnings("ignore", category=UserWarning)
# Veri setinin okutulması
df = pd.read_csv("creditcard.csv")
df.head()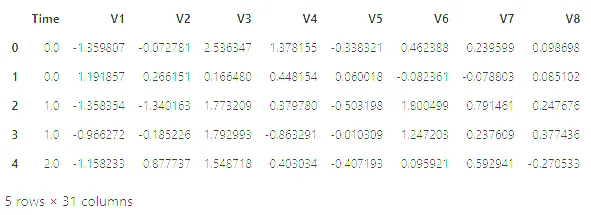
# Veri setindeki değişken ve gözlem sayısı
print("Gözlem sayısı : " ,len(df))
print("Değişken sayısı : ", len(df.columns))
Gözlem sayısı : 284807
Değişken sayısı : 31(Кодът отпечатва етикетите на турски: брой наблюдения и брой променливи.)
# veri setindeki değişkenlerin tiplerini ve boş değer içerip içermediğini gözlemlemek istiyoruz
df.info()
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 284807 entries, 0 to 284806
Data columns (total 31 columns):
# Column Non-Null Count Dtype
--- ------ -------------- -----
0 Time 284807 non-null float64
1 V1 284807 non-null float64
2 V2 284807 non-null float64
3 V3 284807 non-null float64
4 V4 284807 non-null float64
5 V5 284807 non-null float64
6 V6 284807 non-null float64
7 V7 284807 non-null float64
8 V8 284807 non-null float64
9 V9 284807 non-null float64
10 V10 284807 non-null float64
11 V11 284807 non-null float64
12 V12 284807 non-null float64
13 V13 284807 non-null float64
14 V14 284807 non-null float64
15 V15 284807 non-null float64
16 V16 284807 non-null float64
17 V17 284807 non-null float64
18 V18 284807 non-null float64
19 V19 284807 non-null float64
20 V20 284807 non-null float64
21 V21 284807 non-null float64
22 V22 284807 non-null float64
23 V23 284807 non-null float64
24 V24 284807 non-null float64
25 V25 284807 non-null float64
26 V26 284807 non-null float64
27 V27 284807 non-null float64
28 V28 284807 non-null float64
29 Amount 284807 non-null float64
30 Class 284807 non-null int64
dtypes: float64(30), int64(1)
memory usage: 67.4 MB# 1 sınıfının veri setinde bulunma oranı %0.2, 0 sınıfının ise %99.8
f, ax = plt.subplots(1, 2, figsize=(18, 8))
# Sınıf dağılımı
class_counts = df['Class'].value_counts().sort_values(ascending=False)
# Sınıf sayısına göre patlamayı belirleyin
explode = [0.1] * len(class_counts)
# Sınıf dağılımı için pasta grafik
ax[0].pie(class_counts, labels=class_counts.index, autopct='%1.1f%%', explode=explode, shadow=True)
ax[0].set_title('Dağılım')
ax[0].set_ylabel('')
# Sınıf dağılımı için sayım grafiği (seaborn kullanarak)
sns.countplot(x='Class', data=df, ax=ax[1])
ax[1].set_title('Sınıf Sayısı')
plt.show()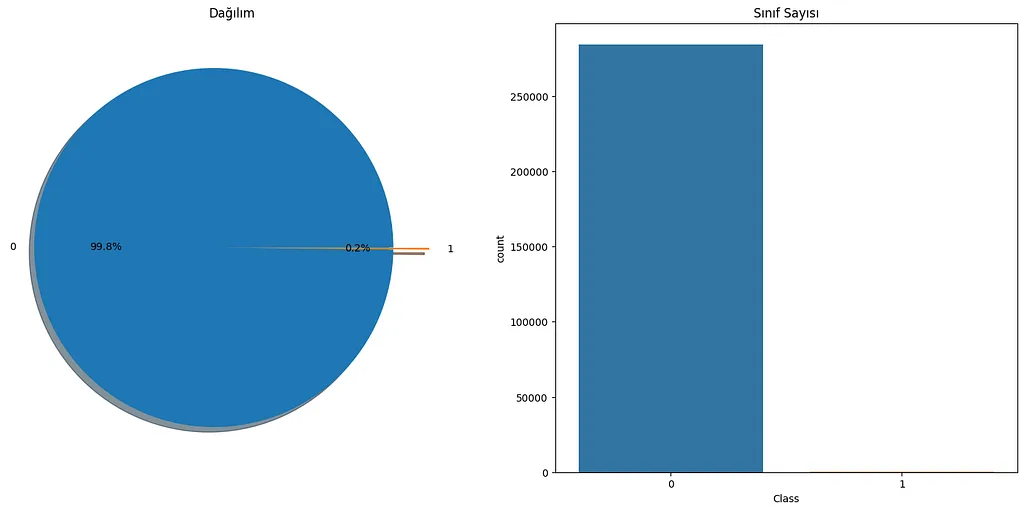
# Time ve Amount değişkenlerini standartlaştırma
rob_scaler = RobustScaler()
df['Amount'] = rob_scaler.fit_transform(df['Amount'].values.reshape(-1,1))
df['Time'] = rob_scaler.fit_transform(df['Time'].values.reshape(-1,1))
df.head()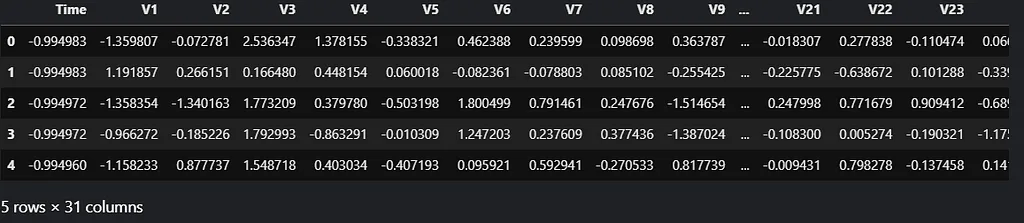
# Hold out yöntemi uygulayıp veri setini eğitim ve test olarak ikiye ayırıyoruz.(%80,%20)
X = df.drop("Class", axis=1)
y = df["Class"]
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.20, random_state=123456)
# modelin tanımlanıp, eğitilmesi ve başarı skoru
model = LogisticRegression(random_state=123456)
model.fit(X_train, y_train)
y_pred = model.predict(X_test)
accuracy = accuracy_score(y_test, y_pred)
print("Accuracy: %.3f"%(accuracy))Accuracy: 0.999Точността е делът на верните прогнози от всички прогнози. Нашият модел постига 0,999. Можем да кажем, че работи безупречно, нали? Да погледнем и матрицата на объркванията.
Матрица на объркванията
Матрицата на объркванията е таблица, която обобщава как се представя класификационният модел върху тестовите данни. Тя съдържа четирите комбинации от предсказани и действителни стойности. Тук приемаме измамата за положителен клас:
- Истински положителни (TP): прогнозата е положителна и е вярна.
- Истински отрицателни (TN): прогнозата е отрицателна и е вярна.
- Фалшиво положителни (FP): прогнозата е положителна, но е грешна.
- Фалшиво отрицателни (FN): прогнозата е отрицателна, но е грешна.
def plot_confusion_matrix(cm, classes,
                          title='Confusion matrix',
                          cmap=plt.cm.Blues):

    plt.rcParams.update({'font.size': 19})
    plt.imshow(cm, interpolation='nearest', cmap=cmap)
    plt.title(title,fontdict={'size':'16'})
    plt.colorbar()
    tick_marks = np.arange(len(classes))
    plt.xticks(tick_marks, classes, rotation=45,fontsize=12,color="blue")
    plt.yticks(tick_marks, classes,fontsize=12,color="blue")
    rc('font', weight='bold')
    fmt = '.1f'
    thresh = cm.max()
    for i, j in itertools.product(range(cm.shape[0]), range(cm.shape[1])):
        plt.text(j, i, format(cm[i, j], fmt),
                 horizontalalignment="center",
                 color="red")

    plt.ylabel('True label',fontdict={'size':'16'})
    plt.xlabel('Predicted label',fontdict={'size':'16'})
    plt.tight_layout()

plot_confusion_matrix(confusion_matrix(y_test, y_pred=y_pred), classes=['Non Fraud','Fraud'],
                      title='Confusion matrix')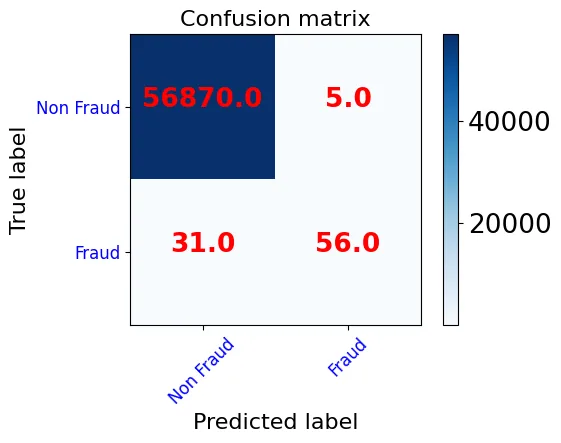
- От 56875 действително нормални транзакции 56870 са предсказани вярно, а 5 са погрешно отбелязани като измама (FP).
- От 87 действителни измами 56 са открити (TP), а 31 са пропуснати (FN).
Моделът отчита точност 0,999, но матрицата на объркванията показва висок дял грешки в класа на измамите. Моделът предсказва добре мнозинствения клас и лошо малцинствения. Тъй като нормалните транзакции са много повече от измамните, моделът изглежда успешен, като предсказва нормалния клас.
Изводът: точността не е добра мярка за представянето на класификационните модели, особено когато данните са толкова небалансирани, колкото нашите. Да видим как да се справим с дисбаланса, какви методи да приложим и с какви метрики да измерваме представянето.
Избор на правилните метрики
Видяхме, че точността не е достатъчна; за да измерим представянето, са ни нужни други метрики.
Precision (прецизност): делът на предсказаните като положителни, които наистина са положителни. Ниската прецизност означава много фалшиво положителни резултати. Precision = TP / (TP + FP).
Recall (пълнота): делът на действително положителните, които сме предсказали като положителни. Ниската пълнота означава много фалшиво отрицателни резултати; пълнотата трябва да е възможно най-висока. Recall = TP / (TP + FN).
F1 мярка: трудно е да се сравни модел с ниска прецизност и висока пълнота с модел с обратните стойности. F1 мярката измерва двете заедно като хармонично средно на прецизността и пълнотата. F1 = 2 × (Precision × Recall) / (Precision + Recall).
Да разгледаме тези метрики за нашия модел. Класификационният отчет показва основните метрики по класове.
#sınıflandırma raporu
print(classification_report(y_test, y_pred))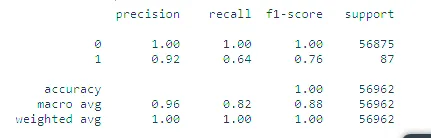
Прецизност по класове:
- Клас 0 (нормални): 56870 + 31 = 56901 транзакции са предсказани като нормални, 56870 от тях вярно. Precision ≈ 1,00 (56870 / 56901).
- Клас 1 (измама): 5 + 56 = 61 транзакции са предсказани като измама, 56 от тях вярно. Precision ≈ 0,92 (56 / 61).
Пълнота по класове:
- Клас 0 (нормални): от 56870 + 5 = 56875 нормални транзакции 56870 са предсказани вярно. Recall ≈ 1,00.
- Клас 1 (измама): от 31 + 56 = 87 измамни транзакции 56 са предсказани вярно. Recall = 56 / 87 ≈ 0,64.
Стойностите на пълнотата ясно показват провала при клас 1. F1 мярката е хармоничното средно на пълнотата и прецизността. Support е действителният брой примери във всеки клас; разликата между класовете показва структурна слабост на измерванията, тъй като самият дисбаланс им влияе.
ROC крива
ROC кривата е графика на представянето на класификационния модел при всички прагове на решение. Тя изобразява две величини:
- Дял на истински положителните (TPR), т.е. пълнотата: TPR = TP / (TP + FN)
- Дял на фалшиво положителните (FPR), т.е. фалшивите тревоги при нормални транзакции: FPR = FP / (FP + TN)
Кривата изобразява TPR спрямо FPR при различни прагове; започва в (0,0) и завършва в (1,1). Добрият модел дава крива, която бързо се изкачва от 0 до 1.
AUC (площ под ROC кривата)
AUC обобщава ROC кривата с едно число: измерва цялата площ под кривата от (0,0) до (1,1). Най-добрата стойност е 1; случайното отгатване дава 0,5.
# Auc Roc Curve
def generate_auc_roc_curve(clf, X_test):
    y_pred_proba = clf.predict_proba(X_test)[:, 1]
    fpr, tpr, thresholds = roc_curve(y_test,  y_pred_proba)
    auc = roc_auc_score(y_test, y_pred_proba)
    plt.plot(fpr,tpr)
    plt.show()
    pass

generate_auc_roc_curve(model, X_test)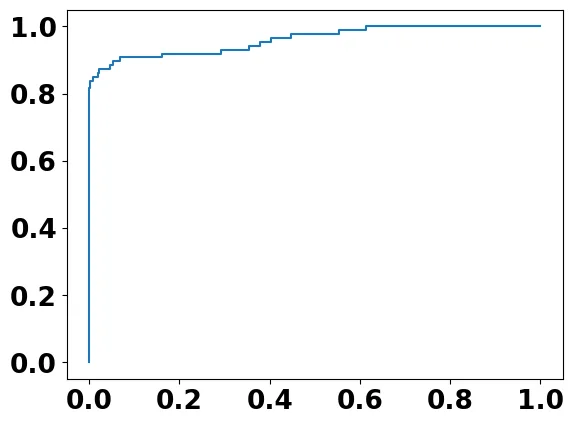
y_pred_proba = model.predict_proba(X_test)[:, 1]
auc = roc_auc_score(y_test, y_pred_proba)
print("AUC ROC Curve with Area Under the curve = %.3f"%auc)
AUC ROC Curve with Area Under the curve = 0.961Бележка: AUC оценява общото представяне на класификацията. Тъй като не дава на единия клас по-голяма тежест от другия, тя не отразява добре представянето при малцинствения клас.
Сега да приложим към набора няколко метода, за да премахнем дисбаланса.
Важно: тези методи трябва да се прилагат само към обучаващата извадка. Ако се приложат към тестовата, правилната оценка става невъзможна.
Повторна извадка
Повторната извадка (resampling) прави набора по-балансиран, като добавя нови примери към малцинствения клас или премахва примери от мнозинствения. Ъндърсемплингът премахва примери от мнозинствения клас; овърсемплингът умножава примерите от малцинствения.
Овърсемплинг
Овърсемплингът балансира данните, като дублира примери от малцинствения клас.
Случаен овърсемплинг:
- Добавят се случайно избрани примери от малцинствения клас, за да се балансира наборът.
- Може да се използва, когато наборът е малък.
- Може да доведе до преобучение (overfitting).
RandomOverSampler приема аргумент sampling_strategy. При sampling_strategy='minority' малцинственият клас се умножава, докато се изравни с мнозинствения. Аргументът приема и десетично число: ако мнозинственият клас има 1000 примера, а малцинственият – 100, sampling_strategy=0.5 увеличава малцинствения до 500.
# random oversampling önce eğitim setindeki sınıf sayısı
y_train.value_counts()
0 227440
1 405
Name: Class, dtype: int64# RandomOver Sampling uygulanması (Eğitim setine uygulanıyor)
from imblearn.over_sampling import RandomOverSampler
oversample = RandomOverSampler(sampling_strategy='minority')
X_randomover, y_randomover = oversample.fit_resample(X_train, y_train)# random oversampling den sonra eğitim setinin sınıf sayısı
y_randomover.value_counts()1 227440
0 227440
Name: Class, dtype: int64# modelin eğitilmesi ve başarı oranı
model.fit(X_randomover, y_randomover)
y_pred = model.predict(X_test)
accuracy = accuracy_score(y_test, y_pred)
print("Accuracy: %.3f%%" % (accuracy))Accuracy: 0.977plot_confusion_matrix(confusion_matrix(y_test, y_pred=y_pred), classes=['Non Fraud','Fraud'],
title='Confusion matrix')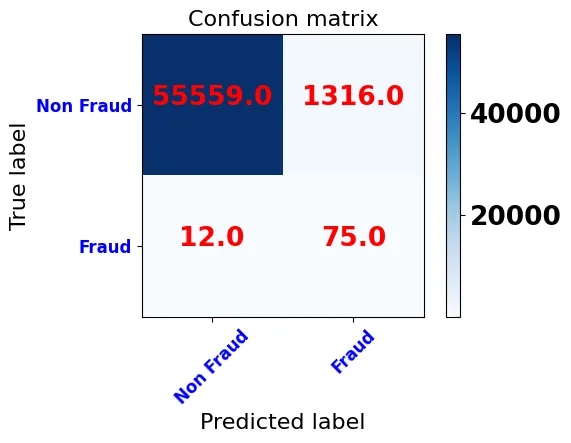
#sınıflandırma raporu
print(classification_report(y_test, y_pred)) precision recall f1-score support
0 1.00 0.98 0.99 56875
1 0.05 0.86 0.10 87
accuracy 0.98 56962
macro avg 0.53 0.92 0.55 56962
weighted avg 1.00 0.98 0.99 56962След случайния овърсемплинг точността на модела спада до 0,977. Матрицата на объркванията и класификационният отчет показват, че повечето транзакции, отбелязани като измама, са фалшиви тревоги, което понижава прецизността на клас 1 до 0,05. В замяна пълнотата на клас 1 нараства до 0,86: открити са 75 от 87 измами. Нормалните транзакции се предсказват малко по-зле, отколкото при първия модел, но този скок в откриването на измами е сериозна причина да предпочетем модела, обучен след случаен овърсемплинг.
SMOTE овърсемплинг:
За да се избегне преобучението, вместо копия се генерират синтетични примери от малцинствения клас:
- Избира се случаен пример от малцинствения клас.
- Намират се неговите k най-близки съседи.
- Избира се случайно един съсед; в пространството на признаците се прекарва отсечка между примера и този съсед, а синтетичният пример се създава върху нея.
# smote dan önce eğitim setindeki sınıf sayısı
y_train.value_counts()0 227440
1 405
Name: Class, dtype: int64# Smote uygulanması (Eğitim setine uygulanıyor)
from imblearn.over_sampling import SMOTE
oversample = SMOTE()
X_smote, y_smote = oversample.fit_resample(X_train, y_train)# smote dan sonra eğitim setinin sınıf sayısı
y_smote.value_counts()1 227440
0 227440
Name: Class, dtype: int64# modelin eğitilmesi ve başarı oranı
model.fit(X_smote, y_smote)
y_pred = model.predict(X_test)
accuracy = accuracy_score(y_test, y_pred)
print("Accuracy: %.3f%%" % (accuracy))Accuracy: 0.975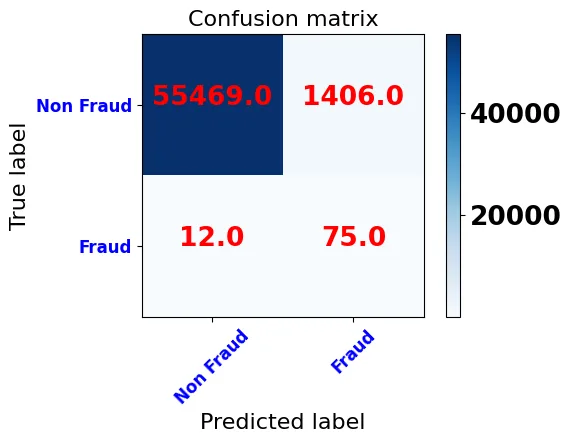
plot_confusion_matrix(confusion_matrix(y_test, y_pred=y_pred), classes=['Non Fraud','Fraud'],
                      title='Confusion matrix')
#sınıflandırma raporu
print(classification_report(y_test, y_pred)) precision recall f1-score support
0 1.00 0.98 0.99 56875
1 0.05 0.86 0.10 87
accuracy 0.98 56962
macro avg 0.53 0.92 0.54 56962
weighted avg 1.00 0.98 0.99 56962Резултатите след SMOTE са подобни на случайния овърсемплинг: отново са открити 75 от 87 измами, а фалшивите тревоги нарастват до 1406.
Ъндърсемплинг
Ъндърсемплингът балансира данните, като премахва примери от мнозинствения клас, и е подходящ за големи набори. Нашият набор не е достатъчно голям, за да работи методът добре, но обясняваме методите и показваме как се прилагат някои от тях.
Случаен ъндърсемплинг:
- Примерите за премахване се избират случайно.
- Може да се използва, ако имате голям набор от данни.
- Случайният избор може да доведе до загуба на информация.
# random undersampling den önce eğitim setindeki sınıf sayısı
y_train.value_counts()
0 227440
1 405
Name: Class, dtype: int64from imblearn.under_sampling import RandomUnderSampler
# transform the dataset
ranUnSample = RandomUnderSampler()
X_ranUnSample, y_ranUnSample = ranUnSample.fit_resample(X_train, y_train)# Random undersampling sonra
y_ranUnSample.value_counts()1 405
0 405
Name: Class, dtype: int64NearMiss ъндърсемплинг:
- Намалява загубата на информация.
- Основава се на алгоритъма KNN.
- Изчислява разстоянието от примерите на мнозинствения клас до тези на малцинствения.
- Запазва примерите от мнозинствения клас, най-близки до малцинствения, според зададеното k.
Връзки на Томек (Tomek links): за всяка двойка най-близки примери от различни класове се премахва примерът от мнозинствения клас, с което разстоянието между двата класа се увеличава.
Центроиди на клъстери: маловажните примери се премахват от набора; дали примерът е важен, се определя чрез клъстеризация.
Ъндърсемплингът и овърсемплингът могат да се комбинират, за да се получат по-балансирани набори от данни.
Други методи
- Събиране на повече данни
- Използване на параметъра
class_weight, за да се учи моделът еднакво от малцинствения и от мнозинствения клас - Сравняване с представянето на други модели, а не само на един
- Прилагане на различен подход, например откриване на аномалии или промени
Кой метод работи най-добре, зависи от конкретния набор от данни. Най-добър резултат дава изпробването на методите и изборът на този, който подхожда на вашите данни.
Източници
- Kaggle: За небалансираните набори от данни (Yasin Tanış, на турски)
- Miuul: Какво е небалансиран набор от данни (на турски)
- Machine Learning Mastery: Random oversampling and undersampling
- Machine Learning Mastery: SMOTE oversampling
- Towards Data Science: Understanding the confusion matrix
- Towards Data Science: Understanding the AUC-ROC curve
- Machine Learning Mastery: Tactics to combat imbalanced classes