

Што е неурамнотежена збирка податоци и како да се справиме со неа?
Автор Yasin TANIŞ
Што е неурамнотежена збирка податоци
Правите класификациски модел за една компанија и тој постигнува точност од 95 %. Сè изгледа во ред. Моделот влегува во употреба, но наскоро се забележува дека секогаш ја предвидува истата класа. Кога повторно ќе ги погледнете податоците, откривате дека класата што никогаш не ја препознава сочинува само 5 % од податоците. Неуспехот на моделот потекнува од неурамнотежената збирка податоци.
Неурамнотежени збирки податоци се јавуваат кај класификациските проблеми кога класите се далеку од рамномерно распоредени. Проблемот е што мнозинската класа ја надвладува малцинската: моделот се наклонува кон мнозинската класа и лошо ја класифицира малцинската.
Кога ќе се соочиме со неурамнотежени податоци, ова се методите со кои можеме правилно да набљудуваме и да ја вратиме рамнотежата:
- Избор на вистинските метрики: precision, recall, F1 резултат, ROC крива и AUC
- Повторно земање примероци: оверсемплинг (случаен и SMOTE) и андерсемплинг (случаен, NearMiss, Томекови врски, центроиди на кластери)
- Собирање повеќе податоци
- Користење на параметарот
class_weightна класификациските модели, за моделот подеднакво да учи од малцинската и мнозинската класа - Разгледување на перформансите на други модели наместо потпирање на само еден
- Примена на поинаков пристап, како откривање аномалии или промени
Прво ја испитуваме неурамнотежената збирка Credit Card Fraud Detection, а потоа применуваме повеќе методи за да се справиме со таа нерамнотежа.
Испитување на збирката
Откривањето измами е важно за компаниите за платежни картички: не сакаат на клиентите да им се наплатат купувања што не ги направиле.
Збирка податоци: creditcard.csv (Kaggle)
Со оваа збирка сакаме да изградиме модел што открива измамнички трансакции. Податоците потекнуваат од трансакции со картички во Европа во септември 2013 година; секоја трансакција е означена со 1 ако е измама и со 0 ако не е. Поради заштита на приватноста, информациите за позадината се малку, а сите променливи освен Time и Amount се трансформирани со PCA (анализа на главни компоненти).
Time: секунди поминати од првата трансакција до секоја трансакцијаAmount: износ на трансакцијата
Прво ги читаме податоците, проверуваме дали има недостасувачки вредности и ја гледаме распределбата на променливата Class. Потоа ги стандардизираме Amount и Time, ги делиме податоците со методот hold-out и градиме класификациски модел со логистичка регресија. Ќе работиме со еден модел.
# Gerekli kütüphaneler
import pandas as pd
import numpy as np
from sklearn.preprocessing import RobustScaler
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score
from sklearn.metrics import confusion_matrix, classification_report,f1_score,recall_score,roc_auc_score, roc_curve
import matplotlib.pyplot as plt
import seaborn as sns
from matplotlib import rc,rcParams
import itertools

import warnings
warnings.filterwarnings("ignore", category=DeprecationWarning)
warnings.filterwarnings("ignore", category=FutureWarning)
warnings.filterwarnings("ignore", category=UserWarning)
# Veri setinin okutulması
df = pd.read_csv("creditcard.csv")
df.head()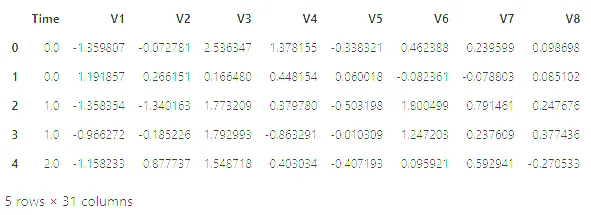
# Veri setindeki değişken ve gözlem sayısı
print("Gözlem sayısı : " ,len(df))
print("Değişken sayısı : ", len(df.columns))
Gözlem sayısı : 284807
Değişken sayısı : 31(Кодот ги печати ознаките на турски: број на набљудувања и број на променливи.)
# veri setindeki değişkenlerin tiplerini ve boş değer içerip içermediğini gözlemlemek istiyoruz
df.info()
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 284807 entries, 0 to 284806
Data columns (total 31 columns):
# Column Non-Null Count Dtype
--- ------ -------------- -----
0 Time 284807 non-null float64
1 V1 284807 non-null float64
2 V2 284807 non-null float64
3 V3 284807 non-null float64
4 V4 284807 non-null float64
5 V5 284807 non-null float64
6 V6 284807 non-null float64
7 V7 284807 non-null float64
8 V8 284807 non-null float64
9 V9 284807 non-null float64
10 V10 284807 non-null float64
11 V11 284807 non-null float64
12 V12 284807 non-null float64
13 V13 284807 non-null float64
14 V14 284807 non-null float64
15 V15 284807 non-null float64
16 V16 284807 non-null float64
17 V17 284807 non-null float64
18 V18 284807 non-null float64
19 V19 284807 non-null float64
20 V20 284807 non-null float64
21 V21 284807 non-null float64
22 V22 284807 non-null float64
23 V23 284807 non-null float64
24 V24 284807 non-null float64
25 V25 284807 non-null float64
26 V26 284807 non-null float64
27 V27 284807 non-null float64
28 V28 284807 non-null float64
29 Amount 284807 non-null float64
30 Class 284807 non-null int64
dtypes: float64(30), int64(1)
memory usage: 67.4 MB# 1 sınıfının veri setinde bulunma oranı %0.2, 0 sınıfının ise %99.8
f, ax = plt.subplots(1, 2, figsize=(18, 8))
# Sınıf dağılımı
class_counts = df['Class'].value_counts().sort_values(ascending=False)
# Sınıf sayısına göre patlamayı belirleyin
explode = [0.1] * len(class_counts)
# Sınıf dağılımı için pasta grafik
ax[0].pie(class_counts, labels=class_counts.index, autopct='%1.1f%%', explode=explode, shadow=True)
ax[0].set_title('Dağılım')
ax[0].set_ylabel('')
# Sınıf dağılımı için sayım grafiği (seaborn kullanarak)
sns.countplot(x='Class', data=df, ax=ax[1])
ax[1].set_title('Sınıf Sayısı')
plt.show()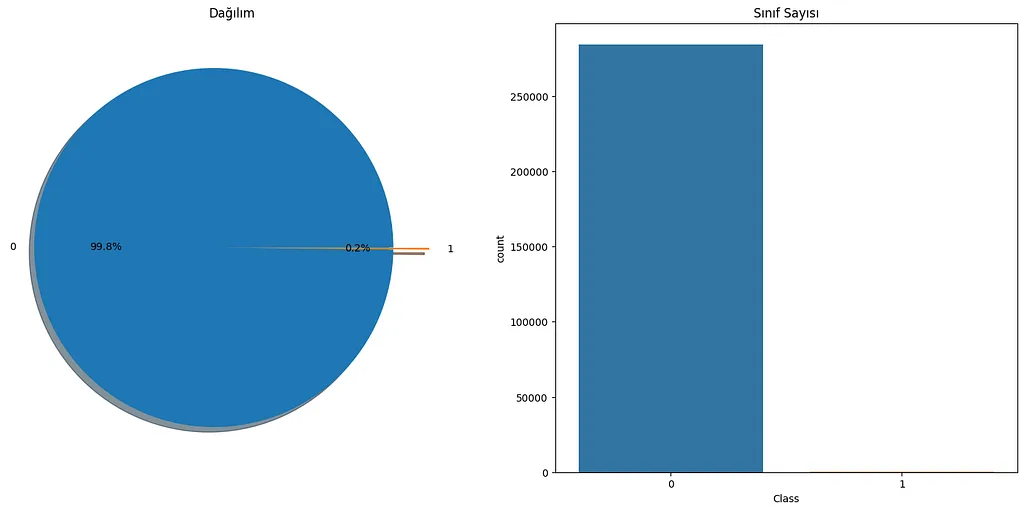
# Time ve Amount değişkenlerini standartlaştırma
rob_scaler = RobustScaler()
df['Amount'] = rob_scaler.fit_transform(df['Amount'].values.reshape(-1,1))
df['Time'] = rob_scaler.fit_transform(df['Time'].values.reshape(-1,1))
df.head()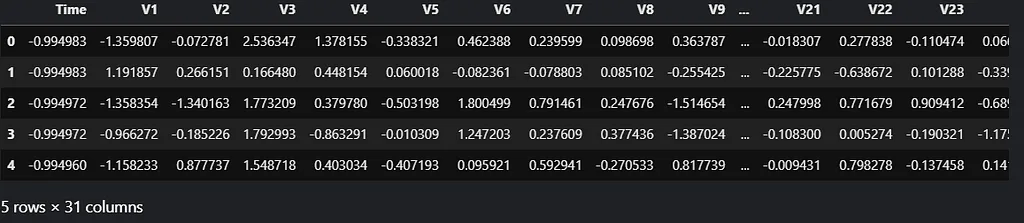
# Hold out yöntemi uygulayıp veri setini eğitim ve test olarak ikiye ayırıyoruz.(%80,%20)
X = df.drop("Class", axis=1)
y = df["Class"]
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.20, random_state=123456)
# modelin tanımlanıp, eğitilmesi ve başarı skoru
model = LogisticRegression(random_state=123456)
model.fit(X_train, y_train)
y_pred = model.predict(X_test)
accuracy = accuracy_score(y_test, y_pred)
print("Accuracy: %.3f"%(accuracy))Accuracy: 0.999Точноста (accuracy) е уделот на точните предвидувања во вкупниот број предвидувања. Нашиот модел постигнува 0,999. Би можеле да кажеме дека работи совршено, нели? Да ја погледнеме и матрицата на конфузија.
Матрица на конфузија
Матрицата на конфузија е табела што сумира колку добро работи класификацискиот модел врз тест-податоците. Содржи четири комбинации на предвидени и вистински вредности. Овде измамата ја сметаме за позитивна класа:
- Вистински позитивно (TP): предвидено позитивно и точно.
- Вистински негативно (TN): предвидено негативно и точно.
- Лажно позитивно (FP): предвидено позитивно, но погрешно.
- Лажно негативно (FN): предвидено негативно, но погрешно.
def plot_confusion_matrix(cm, classes,
                          title='Confusion matrix',
                          cmap=plt.cm.Blues):

    plt.rcParams.update({'font.size': 19})
    plt.imshow(cm, interpolation='nearest', cmap=cmap)
    plt.title(title,fontdict={'size':'16'})
    plt.colorbar()
    tick_marks = np.arange(len(classes))
    plt.xticks(tick_marks, classes, rotation=45,fontsize=12,color="blue")
    plt.yticks(tick_marks, classes,fontsize=12,color="blue")
    rc('font', weight='bold')
    fmt = '.1f'
    thresh = cm.max()
    for i, j in itertools.product(range(cm.shape[0]), range(cm.shape[1])):
        plt.text(j, i, format(cm[i, j], fmt),
                 horizontalalignment="center",
                 color="red")

    plt.ylabel('True label',fontdict={'size':'16'})
    plt.xlabel('Predicted label',fontdict={'size':'16'})
    plt.tight_layout()

plot_confusion_matrix(confusion_matrix(y_test, y_pred=y_pred), classes=['Non Fraud','Fraud'],
                      title='Confusion matrix')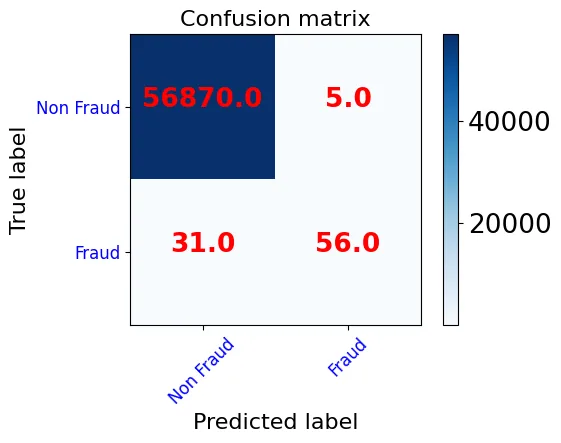
- Од 56875 трансакции што се навистина нормални, 56870 се предвидени точно, а 5 погрешно се означени како измама (FP).
- Од 87 трансакции што се навистина измами, 56 се откриени (TP), а 31 е пропуштена (FN).
Моделот тврди точност од 0,999, но матрицата на конфузија покажува висока стапка на грешки во класата на измами. Моделот добро ја предвидува мнозинската, а лошо малцинската класа. Бидејќи нормалните трансакции се многу повеќе од измамничките, моделот изгледа успешен само затоа што ја предвидува нормалната класа.
Поука: точноста не е добра мерка за перформансите на класификациските модели, особено кога податоците се неурамнотежени како нашите. Да видиме како да се справиме со нерамнотежата, кои методи да ги примениме и со кои метрики да ги мериме перформансите.
Избор на вистинските метрики
Видовме дека точноста не е доволна; за мерење на перформансите потребни се други метрики.
Precision (прецизност): уделот на навистина позитивните меѓу предвидените позитивни. Ниската прецизност значи многу лажно позитивни резултати. Precision = TP / (TP + FP).
Recall (одзив): уделот на вистински позитивните што сме ги предвиделе како позитивни. Нискиот одзив значи многу лажно негативни резултати; треба да биде што повисок. Recall = TP / (TP + FN).
F1 резултат: тешко е да се спореди модел со ниска прецизност и висок одзив со модел кај кој е обратно. F1 ги мери двете заедно како хармониска средина на прецизноста и одзивот. F1 = 2 × (Precision × Recall) / (Precision + Recall).
Да ги погледнеме овие метрики за нашиот модел. Извештајот за класификација ги прикажува главните метрики по класи.
#sınıflandırma raporu
print(classification_report(y_test, y_pred))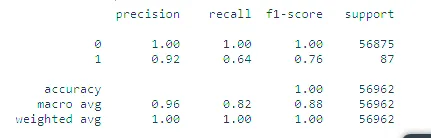
Прецизност по класи:
- Класа 0 (нормални): како нормални се предвидени 56870 + 31 = 56901 трансакција, од кои 56870 точно. Precision ≈ 1,00 (56870 / 56901).
- Класа 1 (измама): како измама се предвидени 5 + 56 = 61 трансакција, од кои 56 точно. Precision ≈ 0,92 (56 / 61).
Одзив по класи:
- Класа 0 (нормални): од 56870 + 5 = 56875 нормални трансакции, 56870 се предвидени точно. Recall ≈ 1,00.
- Класа 1 (измама): од 31 + 56 = 87 измамнички трансакции, 56 се предвидени точно. Recall = 56 / 87 ≈ 0,64.
Вредностите на одзивот јасно го покажуваат неуспехот кај класа 1. F1 резултатот е хармониска средина на одзивот и прецизноста. Support е вистинскиот број примероци во секоја класа; разликата меѓу класите покажува структурна слабост на мерењата, бидејќи самата нерамнотежа влијае врз нив.
ROC крива
ROC кривата е графикон на перформансите на класификацискиот модел на сите прагови на одлучување. Таа прикажува две вредности:
- Стапка на вистински позитивни (TPR), т.е. одзив: TPR = TP / (TP + FN)
- Стапка на лажно позитивни (FPR), т.е. стапката на лажни тревоги кај нормалните трансакции: FPR = FP / (FP + TN)
Кривата го прикажува TPR во однос на FPR на различни прагови; почнува во (0,0), а завршува во (1,1). Добар модел дава крива што брзо расте од 0 до 1.
AUC (површина под ROC кривата)
AUC ја сумира ROC кривата со еден број: ја мери целата површина под кривата од (0,0) до (1,1). Најдобрата вредност е 1; случајното погодување дава 0,5.
# Auc Roc Curve
def generate_auc_roc_curve(clf, X_test):
    y_pred_proba = clf.predict_proba(X_test)[:, 1]
    fpr, tpr, thresholds = roc_curve(y_test,  y_pred_proba)
    auc = roc_auc_score(y_test, y_pred_proba)
    plt.plot(fpr,tpr)
    plt.show()
    pass

generate_auc_roc_curve(model, X_test)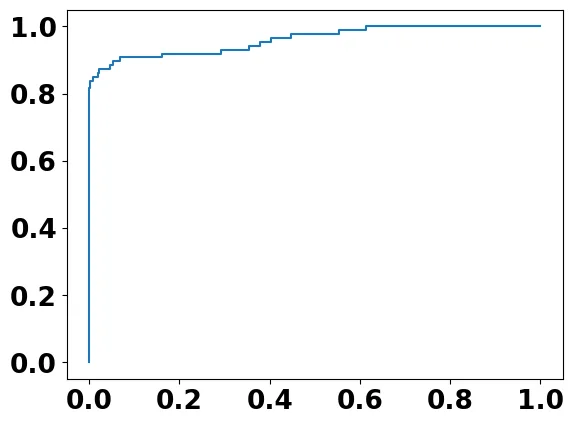
y_pred_proba = model.predict_proba(X_test)[:, 1]
auc = roc_auc_score(y_test, y_pred_proba)
print("AUC ROC Curve with Area Under the curve = %.3f"%auc)
AUC ROC Curve with Area Under the curve = 0.961Забелешка: AUC ги оценува вкупните перформанси на класификацијата. Бидејќи на ниедна класа не ѝ дава поголема тежина, не ги одразува добро перформансите кај малцинската класа.
Сега да примениме неколку методи врз збирката за да ја отстраниме нерамнотежата.
Важно: овие методи се применуваат само на множеството за обука. Ако се применат на тест-множеството, правилната оценка станува невозможна.
Повторно земање примероци
Повторното земање примероци (resampling) ја урамнотежува збирката со додавање нови примероци на малцинската класа или со отстранување примероци од мнозинската. Андерсемплингот отстранува примероци од мнозинството; оверсемплингот ги умножува примероците од малцинството.
Оверсемплинг
Оверсемплингот ги урамнотежува податоците со умножување на примероците од малцинската класа.
Случаен оверсемплинг:
- Се додаваат случајно избрани примероци од малцинската класа за да се урамнотежи збирката.
- Може да се користи кога збирката е мала.
- Може да доведе до преприлагодување (overfitting).
RandomOverSampler прима аргумент sampling_strategy. Со sampling_strategy='minority' малцинската класа се умножува додека не се изедначи со мнозинската. Аргументот прима и децимален број: ако мнозинската класа има 1000 примероци, а малцинската 100, sampling_strategy=0.5 ја зголемува малцинската класа на 500 примероци.
# random oversampling önce eğitim setindeki sınıf sayısı
y_train.value_counts()
0 227440
1 405
Name: Class, dtype: int64# RandomOver Sampling uygulanması (Eğitim setine uygulanıyor)
from imblearn.over_sampling import RandomOverSampler
oversample = RandomOverSampler(sampling_strategy='minority')
X_randomover, y_randomover = oversample.fit_resample(X_train, y_train)# random oversampling den sonra eğitim setinin sınıf sayısı
y_randomover.value_counts()1 227440
0 227440
Name: Class, dtype: int64# modelin eğitilmesi ve başarı oranı
model.fit(X_randomover, y_randomover)
y_pred = model.predict(X_test)
accuracy = accuracy_score(y_test, y_pred)
print("Accuracy: %.3f%%" % (accuracy))Accuracy: 0.977plot_confusion_matrix(confusion_matrix(y_test, y_pred=y_pred), classes=['Non Fraud','Fraud'],
title='Confusion matrix')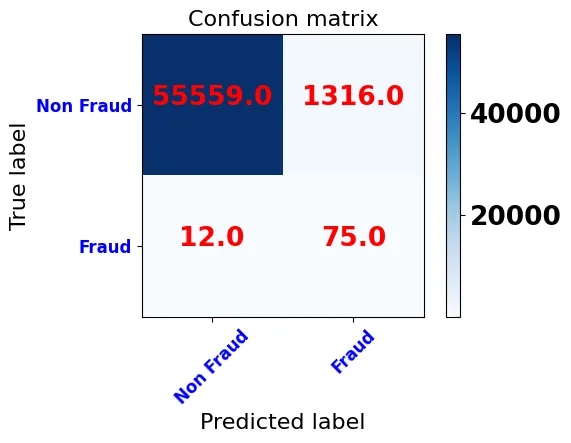
#sınıflandırma raporu
print(classification_report(y_test, y_pred)) precision recall f1-score support
0 1.00 0.98 0.99 56875
1 0.05 0.86 0.10 87
accuracy 0.98 56962
macro avg 0.53 0.92 0.55 56962
weighted avg 1.00 0.98 0.99 56962По случајниот оверсемплинг точноста на моделот паѓа на 0,977. Матрицата на конфузија и извештајот за класификација покажуваат дека повеќето трансакции означени како измама се лажни тревоги, што ја спушта прецизноста на класа 1 на 0,05. За возврат, одзивот на класа 1 расте на 0,86: откриени се 75 од 87 измами. Нормалните трансакции се предвидуваат малку полошо отколку кај првиот модел, но овој скок во откривањето измами е силна причина да се претпочита моделот обучен по случајниот оверсемплинг.
SMOTE оверсемплинг:
За да се избегне преприлагодување, наместо копии се генерираат синтетички примероци од малцинската класа:
- Случајно се избира еден примерок од малцинската класа.
- Се наоѓаат неговите k најблиски соседи.
- Еден сосед се избира случајно; во просторот на карактеристики се повлекува отсечка меѓу примерокот и тој сосед, а синтетичкиот примерок се создава на таа отсечка.
# smote dan önce eğitim setindeki sınıf sayısı
y_train.value_counts()0 227440
1 405
Name: Class, dtype: int64# Smote uygulanması (Eğitim setine uygulanıyor)
from imblearn.over_sampling import SMOTE
oversample = SMOTE()
X_smote, y_smote = oversample.fit_resample(X_train, y_train)# smote dan sonra eğitim setinin sınıf sayısı
y_smote.value_counts()1 227440
0 227440
Name: Class, dtype: int64# modelin eğitilmesi ve başarı oranı
model.fit(X_smote, y_smote)
y_pred = model.predict(X_test)
accuracy = accuracy_score(y_test, y_pred)
print("Accuracy: %.3f%%" % (accuracy))Accuracy: 0.975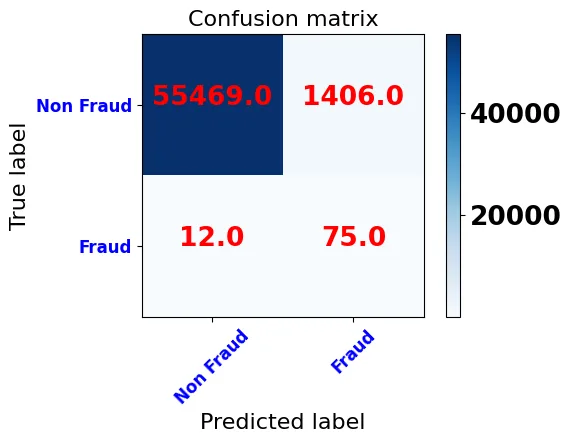
plot_confusion_matrix(confusion_matrix(y_test, y_pred=y_pred), classes=['Non Fraud','Fraud'],
                      title='Confusion matrix')
#sınıflandırma raporu
print(classification_report(y_test, y_pred)) precision recall f1-score support
0 1.00 0.98 0.99 56875
1 0.05 0.86 0.10 87
accuracy 0.98 56962
macro avg 0.53 0.92 0.54 56962
weighted avg 1.00 0.98 0.99 56962Резултатите по SMOTE се слични на случајниот оверсемплинг: повторно се откриени 75 од 87 измами, а бројот на лажни тревоги расте на 1406.
Андерсемплинг
Андерсемплингот ги урамнотежува податоците со отстранување примероци од мнозинската класа и е погоден за големи збирки. Нашата збирка не е доволно голема за овој пристап да даде добри резултати, но ги објаснуваме методите и покажуваме како се применуваат некои од нив.
Случаен андерсемплинг:
- Примероците за отстранување се избираат случајно.
- Може да се користи ако имате голема збирка.
- Случајниот избор може да доведе до губење информации.
# random undersampling den önce eğitim setindeki sınıf sayısı
y_train.value_counts()
0 227440
1 405
Name: Class, dtype: int64from imblearn.under_sampling import RandomUnderSampler
# transform the dataset
ranUnSample = RandomUnderSampler()
X_ranUnSample, y_ranUnSample = ranUnSample.fit_resample(X_train, y_train)# Random undersampling sonra
y_ranUnSample.value_counts()1 405
0 405
Name: Class, dtype: int64NearMiss андерсемплинг:
- Го намалува губењето информации.
- Се заснова на алгоритмот KNN.
- Го пресметува растојанието на примероците од мнозинската класа до примероците од малцинската.
- Ги задржува примероците од мнозинската класа што се најблиску до малцинската, според зададеното k.
Томекови врски: за секој пар најблиски примероци од различни класи се отстранува примерокот од мнозинската класа, со што се зголемува растојанието меѓу класите.
Центроиди на кластери: неважните примероци се отстрануваат од збирката; дали примерокот е важен се одредува со кластерирање.
Андерсемплингот и оверсемплингот можат да се комбинираат за да се добијат поурамнотежени збирки.
Други методи
- Собирање повеќе податоци
- Користење на параметарот
class_weight, за моделот подеднакво да учи од малцинската и мнозинската класа - Разгледување на перформансите на други модели, не само на еден
- Примена на поинаков пристап, како откривање аномалии или промени
Кој метод дава најдобар резултат зависи од конкретната збирка. Најдобро е методите да се испробаат и да се избере оној што им одговара на вашите податоци.
Извори
- Kaggle: За неурамнотежените збирки податоци (Yasin Tanış, на турски)
- Miuul: Што е неурамнотежена збирка податоци (на турски)
- Machine Learning Mastery: Random oversampling and undersampling
- Machine Learning Mastery: SMOTE oversampling
- Towards Data Science: Understanding the confusion matrix
- Towards Data Science: Understanding the AUC-ROC curve
- Machine Learning Mastery: Tactics to combat imbalanced classes